Attention 은 문맥에 맞춰 다른 토큰의 정보를 섞는 가중 평균이다
문장 속 단어의 뜻은 주변 단어에 따라 달라진다. “배가 아프다” 의 ‘배’ 와 “배를 탔다” 의 ‘배’ 는 같은 토큰이지만, 모델이 다음 단어를 잘 고르려면 두 경우의 표현이 달라야 한다. attention 은 각 토큰이 시퀀스의 다른 토큰들 중 어디를 얼마나 참고할지 정하고, 그 비율대로 다른 토큰의 정보를 섞어 새 표현을 만드는 연산이다. 비율을 정해 섞는다는 점에서 attention 은 가중 평균, 넓게 보면 pooling 의 한 종류다.
attention 은 번역 모델에서 처음 쓰였다. seq2seq 번역 모델은 인코더가 입력 문장 전체를 고정 길이 벡터 하나로 압축해 디코더에 넘겼는데, 문장이 길수록 벡터 하나에 정보가 다 담기지 않았다. Bahdanau, Cho, Bengio (2014) 는 이 고정 길이 벡터를 병목으로 지목하고, 디코더가 출력 단어를 하나 만들 때마다 인코더의 모든 위치를 다시 보면서 지금 만들 단어와 관련 있는 위치에 더 큰 가중치를 주게 했다. transformer 는 여기서 RNN 을 빼고 attention 만으로 모델을 쌓았고, 지금의 LLM 은 모두 이 구조를 쓴다.
아래는 네 단계로 이어진다. 먼저 attention 한 번의 계산을 작은 숫자로 따라가고, LLM 안의 attention 이 여기에 무엇을 더했는지 본다. 그다음 토큰을 하나씩 생성할 때 생기는 KV Cache 를 소개하고, 마지막으로 attention 의 연산·메모리 비용을 줄이는 기법들을 무엇을 줄이는지 기준으로 분류한다.
Query, key, value
attention 에는 역할이 다른 세 종류의 벡터가 들어간다.
| 벡터 | 맡는 일 |
|---|---|
| query | 표현을 새로 만들려는 쪽. 이 토큰이 어떤 정보를 찾는지를 나타낸다 |
| key | 참고 대상이 되는 쪽. 각 토큰이 어떤 정보를 갖고 있는지를 나타내며, query 와 내적해 관련도를 계산하는 데만 쓰인다 |
| value | 실제로 섞이는 내용. 관련도로 정한 비율만큼 가져간다 |
key 와 value 를 나누는 이유는 관련도를 판단하는 데 쓸 특징과 실제로 전달할 정보가 다를 수 있기 때문이다. transformer 에서는 세 벡터를 모두 같은 토큰의 hidden vector(그 층에 들어온 토큰 표현) 에서 서로 다른 가중치 행렬로 만든다: , , . 세 행렬은 학습으로 정해진다.
Scaled dot-product attention 의 식
query 여러 개를 한꺼번에 계산하기 위해 벡터들을 행으로 쌓은 행렬 로 쓴다 (Vaswani et al., 2017, 3.2.1절).
| 기호 | 뜻 | 크기 |
|---|---|---|
| query 벡터를 행으로 쌓은 행렬 | ||
| key 벡터를 행으로 쌓은 행렬 | ||
| value 벡터를 행으로 쌓은 행렬. 번째 행이 의 번째 행과 같은 토큰에서 나온다 | ||
| query 수. 표현을 새로 만들 토큰 수 | ||
| key·value 수. 참고할 수 있는 토큰 수 | ||
| query·key 벡터의 길이 | ||
| value 벡터의 길이 | ||
| 행마다 따로 적용한다. 벡터 에 대해 |
계산은 네 단계다.
- 관련도 점수. 를 계산한다. 는 query 와 key 의 내적이고, 클수록 둘이 관련 있다고 본다. 크기는 이다.
- 스케일링. 를 로 나눈다. 이유는 아래 ” 로 나누는 이유” 절에서 따로 본다.
- 가중치. 행마다 softmax 를 적용해 attention 가중치 행렬 를 얻는다. 각 행은 0 이상이고 합이 1 이다.
- 가중 평균. 를 계산한다. 출력의 번째 행은 value 벡터들을 의 번째 행 비율로 더한 값이다.
관련도를 내적 대신 은닉층 하나짜리 MLP 로 계산하는 방식도 있다. Bahdanau 의 방식이 이것이고 additive attention 이라 부른다. 내적 방식(dot-product attention)은 행렬곱 한 번으로 끝나서 더 빠르고 메모리도 덜 쓰기 때문에 transformer 가 이쪽을 택했다.
토큰 세 개로 직접 계산하기
토큰 3개, 인 작은 예를 손으로 따라가 본다. 숫자는 설명용으로 고른 값이다.
행 하나가 토큰 하나다. 토큰 1 의 query 을 세 key 와 내적하면 이 나온다. 같은 계산을 세 query 에 모두 하고 로 나누면 다음과 같다.
행마다 softmax 를 적용한다. 첫 행은 , 이므로 가중치가 을 합 1 로 맞춘 이 된다.
토큰 1 의 출력은 다. 토큰 1 의 query 와 내적이 큰 토큰 1, 3 의 value 가 40% 씩, 내적이 0 인 토큰 2 의 value 가 20% 섞였다. 토큰 3 은 자기 key 와의 내적이 2 로 가장 커서 자기 value 를 절반 가까이(0.503) 가져온다.
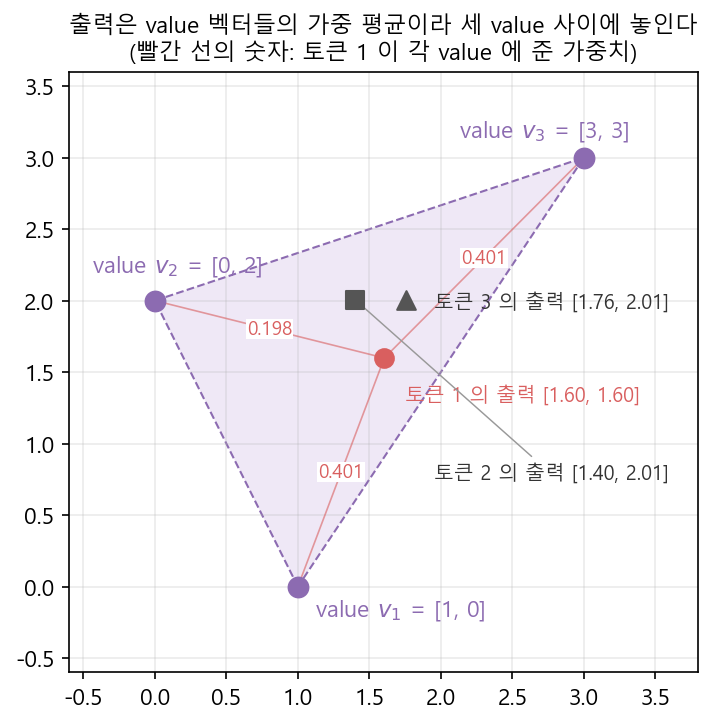
같은 계산을 value 벡터가 놓인 평면에 그리면 위와 같다. 보라색 점 세 개가 value 이고, 가중치는 0 이상이며 합이 1 이므로 출력은 항상 세 점이 만드는 삼각형 안에 놓인다. 빨간 선은 토큰 1 의 출력에서 각 value 로 이은 선이고, 선 위의 숫자가 그 value 에 준 가중치다. 토큰 1 의 출력은 과 쪽으로 같은 비율(0.401)로 끌려가고 쪽으로는 덜(0.198) 끌려간다. 토큰 3 의 출력은 가중치 0.503 을 준 에 가장 가깝다. attention 이 하는 일은 query 마다 이 삼각형 안의 한 점을 고르는 것이고, 어느 점을 고를지를 query 와 key 의 내적이 정한다.
로 나누는 이유
벡터가 길어질수록 내적값의 폭이 커진다. Vaswani et al. (2017, 3.2.1절 각주) 은 query 와 key 의 각 원소가 평균 0, 분산 1 인 독립 확률변수라면 내적 는 평균 0, 분산 를 갖는다고 설명한다. 표준편차가 로 커진다는 뜻이다. 표준정규분포에서 뽑은 벡터 쌍 10,000 개로 직접 확인하면 아래와 같다.
| 내적의 표준편차 (실측) | ||
|---|---|---|
| 2 | 1.42 | 1.41 |
| 64 | 8.08 | 8.00 |
| 512 | 22.5 | 22.6 |
내적이 이만큼 벌어지면 softmax 가 거의 한 칸에 몰린다. 지금 LLM 에서 흔한 이면 표준편차가 약 11.3 이다. 점수가 인 세 key 에 softmax 를 적용하면 가중치는 다. softmax 출력 를 자기 점수로 미분한 값은 인데, 가장 큰 가중치에서 이 값이 약 0.00001 이라서 학습 신호가 거의 전달되지 않는다. 로 나눠 점수를 로 줄이면 가중치는 , 같은 기울기는 0.22 다.
Vaswani et al. 은 가 작을 때는 additive attention 과 스케일링 없는 dot-product attention 의 성능이 비슷하고, 가 클 때는 additive 가 더 낫다고 보고했다. 그 차이의 원인으로 이 포화를 의심했고, 로 나누는 것은 그 대응이다.
LLM 안의 self-attention
앞의 식은 attention 한 번이다. LLM 은 이것을 그대로 쓰지 않고 네 가지를 더한다. query·key·value 를 모두 같은 시퀀스에서 만들고(self-attention), 미래 토큰을 가리고(causal mask), 여러 개를 나란히 돌리고(multi-head), 위치 정보를 넣는다. 그리고 이 구조 때문에 비용이 시퀀스 길이의 제곱으로 는다.
Self-attention 은 query·key·value 를 같은 시퀀스에서 만든다
번역 모델의 attention 은 query 를 디코더에서, key·value 를 인코더에서 가져왔다. 이렇게 두 시퀀스를 잇는 것을 cross-attention 이라 한다. self-attention 은 한 시퀀스 안의 토큰들이 서로를 참고한다. 앞의 식에서 (시퀀스 길이)이고, 가 모두 같은 입력 에서 나온다.
| 기호 | 뜻 | 크기 |
|---|---|---|
| 그 층에 들어온 토큰 hidden vector 를 행으로 쌓은 행렬 | ||
| 시퀀스 길이 (토큰 수) | ||
| hidden vector 의 길이 | ||
| query·key 를 만드는 학습 가중치 | ||
| value 를 만드는 학습 가중치 |

“The animal didn’t cross the street because it was too tired” 에서 ‘it’ 이 무엇을 가리키는지는 문장 안의 다른 단어를 봐야 알 수 있다. 위 그림은 학습된 transformer 의 한 층에서 ‘it’(오른쪽)의 query 가 각 단어(왼쪽)에 준 attention 가중치를 선과 색의 진하기로 그린 것이다. ‘animal’ 이 가장 진하고 ‘street’ 가 그다음이다. 이 층을 지난 ‘it’ 의 표현에는 ‘animal’ 의 value 가 가장 많이 섞인다.
인코더만 쓰는 BERT 는 self-attention 에서 모든 토큰이 모든 토큰을 본다. GPT 계열처럼 다음 토큰을 예측하는 LLM 은 여기에 다음 절의 제약을 건다.
Causal mask 는 뒤에 오는 토큰을 가린다
LLM 은 “앞 토큰들을 보고 다음 토큰을 맞히는” 문제로 학습한다. 학습할 때는 문장 전체가 이미 있으므로 모든 위치의 예측을 한 번에 병렬로 계산한다. 이때 토큰 가 자기보다 뒤의 토큰 를 볼 수 있으면 맞힐 답이 입력에 들어 있는 셈이 된다. 그래서 softmax 전에 그 자리의 점수에 를 더해 가중치를 0 으로 만든다.
은 마스크 행렬이고 이므로 가려진 칸의 가중치는 정확히 0 이 된다. 앞의 토큰 세 개 예에 마스크를 씌우면 가중치 행렬이 아래 오른쪽처럼 바뀐다.
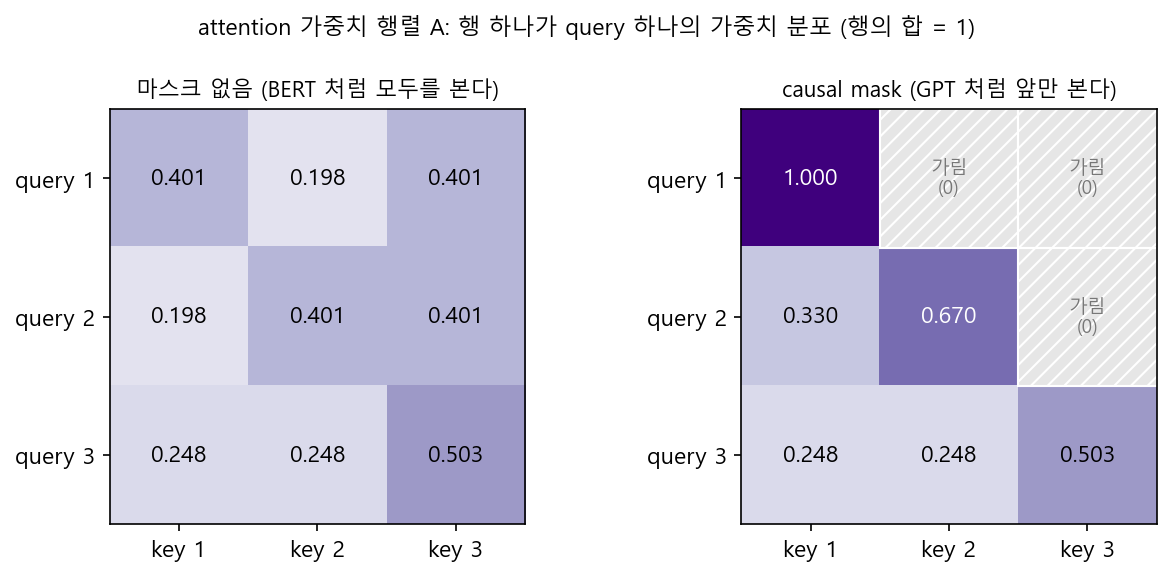
행 하나가 query 하나의 가중치 분포다. 왼쪽은 마스크 없이 계산한 앞의 가중치이고, 오른쪽은 대각선 위쪽(자기보다 뒤의 key)을 빗금으로 가린 결과다. 가린 칸을 빼고 행마다 softmax 를 다시 하므로 남은 칸이 합 1 을 나눠 갖는다. 그래서 query 1 은 자기 자신에게 1.000 을 준다. 출력은 다음과 같다.
- 토큰 1 은 자기 자신만 볼 수 있어서 출력이 자기 value 그대로다.
- 토큰 2 는 점수 두 칸만 남아 softmax 가 이 된다.
- 토큰 3 은 원래 모든 토큰을 볼 수 있는 마지막 위치라서 결과가 마스크 전과 같다.
여기서 생성에 중요한 성질이 하나 나온다. 토큰 의 출력은 번째 토큰에만 의존하므로, 시퀀스 뒤에 토큰이 붙어도 앞 토큰들의 출력은 바뀌지 않는다. 다음 층의 key·value 도 그 출력에서 만들어지므로 역시 그대로다. 생성 단계의 KV cache 는 이 성질 위에 서 있다.
Multi-head attention 은 attention 을 여러 개 나란히 돌린다
softmax 한 번은 query 하나당 가중치 분포 하나를 만든다. 한 토큰이 문법상 주어와 앞 문장의 지시 대상을 동시에 참고해야 할 때, 분포 하나로 두 토큰에 가중치를 나눠 주면 두 value 가 한 벡터로 평균되어 각각의 정보가 흐려진다. Vaswani et al. 도 head 가 하나면 이 평균이 서로 다른 종류의 정보를 함께 참고하는 것을 막는다고 설명했다. multi-head attention 은 를 벌 두고 attention 을 번 따로 계산한 뒤 결과를 이어 붙인다 (Vaswani et al., 2017, 3.2.2절).
| 기호 | 뜻 | 크기 |
|---|---|---|
| head 수 | ||
| head 하나의 query·key·value 길이. 보통 | ||
| 번째 head 의 가중치 | ||
| 번째 head 의 출력 | ||
| 이어 붙인 결과를 다시 로 섞는 가중치 |
head 마다 길이를 로 줄였기 때문에 전체 연산량은 길이 짜리 head 하나와 비슷하다. 원 transformer 는 , , 를 썼다. 구현에서는 를 개 따로 두지 않고 행렬 하나로 곱한 뒤 결과를 조각으로 나눈다.
head 마다 key·value 가 따로 있다는 점이 뒤에서 중요해진다. 생성할 때 저장해야 하는 KV cache 의 크기가 head 수에 비례하고, 뒤에서 볼 MQA·GQA·MLA 는 바로 이 key·value head 를 줄이거나 압축하는 기법이다.
Attention 은 순서를 모르므로 위치 정보를 따로 넣는다
scaled dot-product attention 식에는 토큰의 위치가 들어갈 자리가 없다. 마스크가 없을 때 입력 토큰의 순서를 바꾸면 출력도 같은 순서로 바뀔 뿐 값은 같다. “나는 밥을 먹었다” 와 “밥은 나를 먹었다” 를 구분하려면 위치 정보를 따로 넣어야 한다. 방법은 Positional Encoding 노트에 정리했고, 크게 셋이다.
| 방식 | 위치를 넣는 곳 | 예 |
|---|---|---|
| absolute | 입력 임베딩에 위치 벡터를 더한다 | 원 transformer(sin/cos), BERT·GPT-2(학습된 위치 임베딩) |
| relative bias | attention 점수에 두 토큰 거리에 따른 값을 더한다 | T5 |
| RoPE | query·key 벡터를 위치만큼 회전시킨다 | Llama, Qwen, DeepSeek 등 |
지금의 LLM 은 대부분 RoPE 를 쓴다 (Su et al., 2021). RoPE 는 query·key 벡터의 원소를 두 개씩 짝지어 2 차원 평면의 점으로 보고, 위치 의 토큰이면 번째 짝을 각도 만큼 돌린다. 짝마다 회전 속도 가 다르다. 두 벡터의 같은 짝을 각각 , 만큼 돌린 뒤 내적하면 결과는 각도 차이 에만 의존한다. 그래서 회전은 토큰마다 자기 위치만 보고 따로 적용하는데, attention 점수에는 두 토큰의 거리가 반영된다. value 는 돌리지 않는다.
회전이 자기 위치에만 의존한다는 점은 KV cache 와 잘 맞는다. key 는 한 번 회전시켜 저장하면 뒤에 토큰이 더 붙어도 다시 계산할 필요가 없다. 반대로 뒤에서 볼 MLA 는 key 를 압축해 저장하려다 이 회전과 충돌해서 별도 처리를 한다.
연산과 메모리가 시퀀스 길이의 제곱으로 느는 이유
점수 행렬 는 head 마다, 층마다 크기다. 토큰 하나가 모든 토큰과 내적해야 하므로 칸 수가 이다. 한 층의 연산량을 projection 과 비교하면 이 차이가 드러난다. 곱셈 한 번과 덧셈 한 번을 합쳐 2 FLOPs 로 센다.
| 기호 | 뜻 |
|---|---|
| 를 만들고 출력에 를 곱하는 행렬곱 네 번의 연산량 | |
| head 마다 와 를 계산하는 연산량의 합. 을 썼다 |
projection 은 에 비례하고 attention 행렬 계산은 에 비례한다. 둘의 비는 이다. 인 모델이라면 에서 둘이 같아지고, (128K) 에서는 attention 행렬 계산이 projection 의 16 배다. causal mask 를 쓰면 절반의 칸은 계산할 필요가 없지만 여전히 에 비례한다. (key·value head 를 줄인 GQA 모델은 projection 이 작아서 위 식이 근사다.)
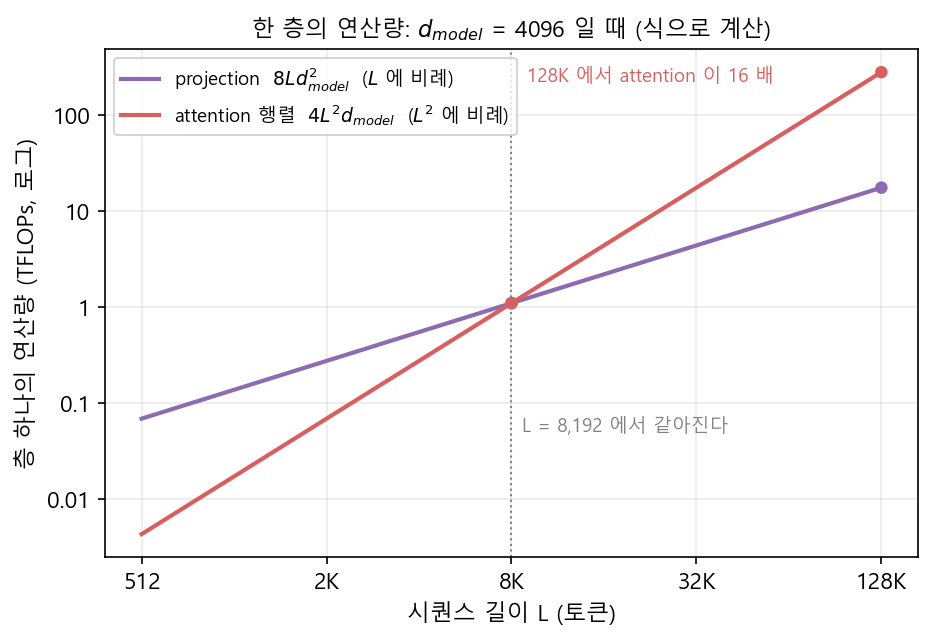
위 그래프는 두 식에 을 넣어 계산한 값이다. 두 축이 모두 로그라서 에 비례하는 projection 은 기울기 1, 에 비례하는 attention 행렬 계산은 기울기 2 의 직선이 된다. 짧은 시퀀스에서는 projection 이 대부분이고, 8K 에서 두 선이 만난 뒤로는 attention 행렬 쪽이 빠르게 커진다.
메모리도 같다. 식을 그대로 구현하면 와 를 GPU 메모리에 통째로 만든다. head 32 개, , 원소당 2 바이트면 한 층의 하나만 해도 바이트 = 4 GiB 다. 학습 때는 역전파를 위해 이것을 보관해야 한다. FlashAttention 은 이 행렬을 메모리에 만들지 않는 방법이다.
생성 단계에서는 사정이 조금 다르다. 새 토큰 하나는 query 하나로 지금까지의 토큰 개와 내적하므로 한 스텝의 attention 연산은 에 비례한다. 다만 답변 길이만큼 스텝을 반복하므로 합치면 다시 제곱이 된다. 그리고 에 비례해 커지는 key·value 를 어딘가에 보관해야 한다. 이것이 다음 절의 KV cache 다.
토큰을 하나씩 생성할 때의 attention 과 KV cache
학습과 달리 생성에서는 다음 토큰을 모른다. LLM 은 토큰 하나를 만들어 입력 끝에 붙이고 다시 모델을 돌리는 일을 답변이 끝날 때까지 반복한다. 이것을 autoregressive decoding 이라 한다.
causal mask 절에서 본 것처럼, 뒤에 토큰이 붙어도 앞 토큰들의 key·value 가 바뀌지 않는다. 그래서 한 번 계산한 key·value 를 층마다 GPU 메모리에 저장해 두고, 다음 스텝에서는 새 토큰 하나의 query·key·value 만 계산한다. 이 저장소가 KV Cache 다. 생성은 두 단계로 나뉜다 (Prefill 노트에 자세히 있다).
- prefill. prompt 전체를 한 번에 넣어 모든 층의 key·value 를 계산해 캐시에 쓰고, 첫 출력 토큰을 만든다.
- decode. 새 토큰 하나를 넣고, 그 토큰의 key·value 를 캐시 끝에 붙인 뒤, query 하나로 캐시 전체와 attention 을 계산한다. 답변이 끝날 때까지 반복한다.
캐시 크기는 토큰 수에 비례해 커진다
토큰 하나가 차지하는 캐시는 층마다, key·value head 마다 길이 짜리 벡터 두 개(key 와 value)다.
| 기호 | 뜻 |
|---|---|
| key 와 value | |
| 층 수 | |
| key·value head 수. 원래의 multi-head attention 이면 query head 수 와 같다 | |
| head 하나의 길이 | |
| 원소 하나의 바이트 수. BF16·FP16 이면 2 |
Llama 3 8B 는 32 층, key·value head 8 개, 이다 (Llama 3 논문 Table 3, 는 4096 / 32 로 계산). BF16 으로 저장하면 토큰당 바이트, 즉 128 KiB 다. 8,192 토큰 문맥 하나면 1 GiB, 이런 요청 16 개를 한 번에 처리하면 16 GiB 로 모델 가중치(약 80 억 개 × 2 바이트 ≈ 16 GB)와 맞먹는다. 크기 계산을 다른 모델과 기법별로 비교한 내용은 KV Cache 노트에 있다.
Prefill 은 연산이, decode 는 메모리 읽기가 병목이다
두 단계는 같은 모델을 돌리지만 GPU 가 기다리는 대상이 다르다.
- prefill 은 prompt 의 토큰 수천 개를 한꺼번에 처리한다. 가중치를 한 번 읽어 와서 많은 토큰에 곱하므로 큰 행렬곱이 되고, GPU 의 연산 속도가 병목이다.
- decode 는 토큰 하나를 만들 때마다 가중치 전체와 KV cache 전체를 메모리에서 읽지만 계산할 양은 적다. 그래서 메모리 대역폭이 병목이다.
Sarathi-Serve (Agrawal et al., 2024, 1장·3.1절) 와 DistServe (Zhong et al., 2024, 2.1절) 가 이 구분을 분석했다. 바이트 하나를 읽을 때마다 하는 연산 수를 arithmetic intensity 라 하는데, DistServe 의 부록 A 계산에 따르면 A100-80GB 는 이 값이 약 156 을 넘어야 연산이 병목이 된다. decode 의 attention 은 head 하나에서 메모리 읽기·쓰기 번(원소 단위)에 연산 번( 는 head 길이, 은 문맥 길이)이라 그 비가 1 보다 작다. decode 의 attention 은 캐시를 읽는 속도만큼만 빨라질 수 있다는 뜻이다. prefill 이 연산 병목이라는 말은 주로 행렬곱에 해당한다. DistServe 의 같은 분석에서는 FlashAttention 을 쓴 prefill 의 attention 계산도 이 값이 10–21 정도라서 메모리 쪽에 가깝게 나온다.
이 차이 때문에 같은 기법도 prefill 과 decode 에서 효과가 다르다. 연산량을 줄이는 기법은 prefill 과 학습에서, 캐시를 작게 만들거나 덜 읽게 하는 기법은 decode 에서 효과가 크다.
Attention 최적화 기법은 무엇을 줄이는지로 나뉜다
attention 의 비용은 세 가지 자원으로 나눠 볼 수 있다.
| 자원 | 뜻 | 커지는 이유 |
|---|---|---|
| 연산량 | 곱셈·덧셈 횟수(FLOPs) | 점수 행렬이 칸이다 |
| 메모리 IO | GPU 의 큰 메모리(HBM)와 연산 장치 사이에 오가는 바이트 수 | 점수 행렬이나 KV cache 를 HBM 에 쓰고 다시 읽는다 |
| KV cache 크기 | 생성하는 동안 HBM 에 붙잡아 두는 용량 | 토큰 수 × 층 수 × key·value head 수에 비례한다 |
HBM(high bandwidth memory)은 GPU 의 주 메모리로, 모델 가중치와 KV cache 가 여기 있다. 연산 장치 바로 옆에는 훨씬 작고 빠른 SRAM 이 있다. A100 은 HBM 이 40–80 GB 에 대역폭 1.5–2.0 TB/s, SRAM 은 연산 블록(SM) 108 개에 192 KB 씩이고 대역폭은 약 19 TB/s 로 추정된다 (Dao et al., 2022, 2.1절). attention 최적화의 상당 부분은 이 둘 사이를 오가는 바이트를 줄이는 일이다.
아래 표는 기법들을 이 기준으로 정리한 것이다. “결과” 열은 표준 attention 과 같은 값을 내는지, 아니면 모델 구조 자체가 달라지는지를 나타낸다. 구조가 달라지는 기법은 학습할 때 정해야 하고, 이미 학습한 모델에는 붙일 수 없거나 추가 학습이 필요하다.
| 기법 | 바꾸는 것 | 주로 줄이는 것 | 효과가 큰 단계 | 결과 |
|---|---|---|---|---|
| MQA, GQA | 여러 query head 가 key·value head 를 나눠 쓴다 | KV cache 크기, decode 의 캐시 읽기 | decode | 구조가 달라진다 |
| MLA | key·value 를 짧은 latent 벡터 하나로 압축해 캐시한다 | KV cache 크기, decode 의 캐시 읽기 | decode | 구조가 달라진다 |
| FlashAttention 1–3 | 점수 행렬을 HBM 에 쓰지 않고 블록 단위로 SRAM 안에서 계산한다 | 메모리 IO, 학습 중 activation 메모리 | 학습, prefill | 같다 |
| Flash-Decoding | 캐시를 길이 방향으로 나눠 병렬로 읽는다 | decode 에서 일이 없어 노는 GPU 연산 블록 | decode (배치가 작고 문맥이 길 때) | 같다 |
| PagedAttention | 캐시를 고정 크기 블록에 나눠 담는다 | 캐시 메모리의 낭비 | decode (배치 크기) | 같다 |
| KV cache 양자화 | 캐시 원소를 8 비트 이하로 저장한다 | KV cache 크기, 캐시 읽기 | decode | 근사 |
| sliding window | 최근 개 토큰만 본다 | 연산량, KV cache 크기 | 둘 다 | 구조가 달라진다 |
| NSA, DSA | 토큰 중 일부를 골라 그것만 본다 | 연산량, decode 의 캐시 읽기 | 둘 다 | 구조가 달라진다 |
| linear attention, hybrid | softmax attention 을 고정 크기 상태를 갱신하는 층으로 바꾼다 | 연산량, KV cache 크기 | 둘 다 | 구조가 달라진다 |
“효과가 큰 단계” 는 각 기법이 줄이는 자원을 앞 절의 prefill·decode 병목과 맞춰 본 해석이다. 각 논문이 실제로 잰 조건과 수치는 아래 절마다 따로 적었다.
Key·value head 를 나눠 쓰거나 압축한다: MQA, GQA, MLA
decode 의 attention 은 캐시를 읽는 속도에 묶여 있고, 캐시 크기는 key·value head 수에 비례한다. 그렇다면 query head 는 그대로 두고 key·value head 만 줄이면 된다는 생각이 MQA 와 GQA 다. MLA 는 head 수 대신 저장하는 벡터를 압축한다.
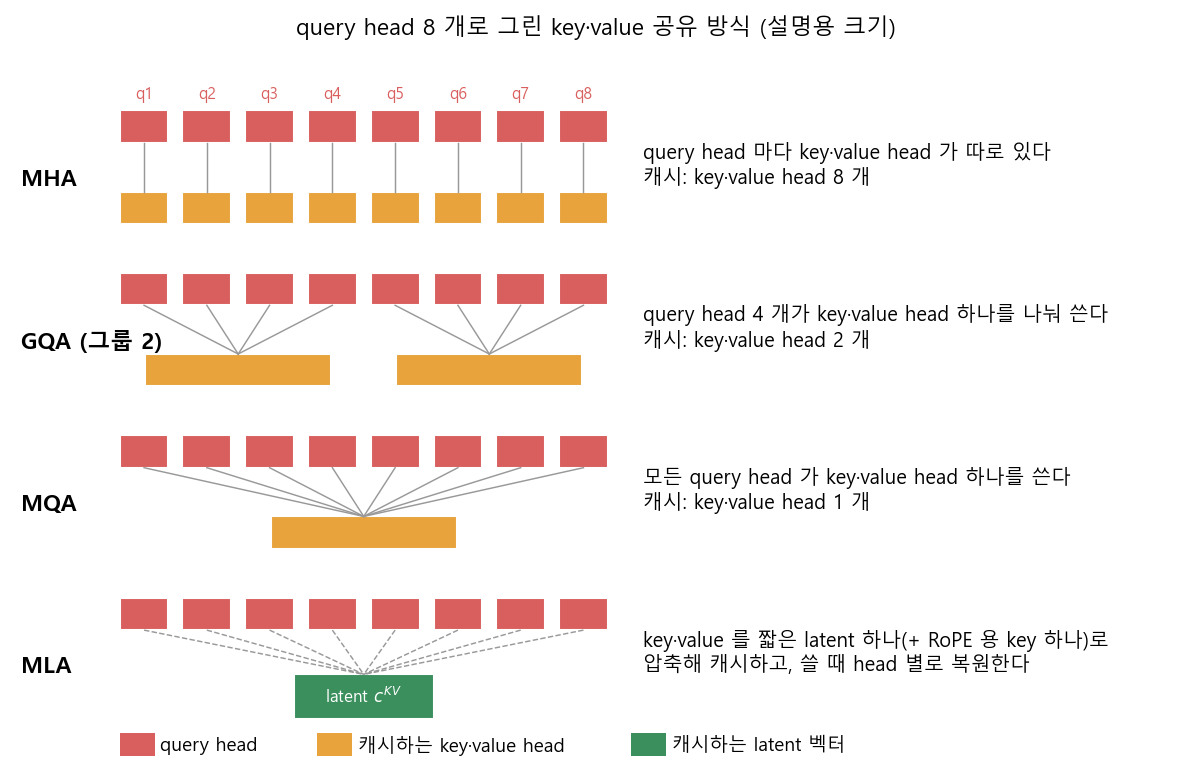
그림은 query head 8 개짜리 층 하나에서 네 방식이 key·value 를 어떻게 나눠 쓰는지 그린 것이다. 빨간 칸이 query head, 주황 칸이 캐시에 저장하는 key·value head, 초록 칸이 MLA 가 저장하는 latent 벡터다. 위에서 아래로 갈수록 캐시에 남는 것이 줄어든다. MHA 는 8 벌, GQA(그룹 2)는 2 벌, MQA 는 1 벌을 저장한다. MLA 는 head 별 key·value 대신 짧은 latent 하나를 저장하고, 계산할 때 head 별 key·value 로 복원한다(점선). 실제 모델은 head 가 훨씬 많다. Llama 3 8B 는 query head 32 개에 key·value head 8 개, DeepSeek-V3 는 query head 128 개에 latent 하나다.
MQA (multi-query attention). Shazeer (2019) 는 모든 query head 가 key·value head 하나를 함께 쓰게 했다. query 와 출력 projection 은 head 마다 그대로 둔다. WMT14 영어–독일어 번역 모델(6 층, , )에서 TPUv2 로 잰 디코더의 토큰당 시간은 46 µs 에서 3.8 µs 로 약 12 배 줄었다 (Table 2, 배치 1024, 원문·번역문 길이 128). 품질은 dev BLEU 가 26.7 에서 26.5 로 0.2 떨어졌다 (Table 1). 파라미터 수를 맞추려고 feed-forward 층을 4096 에서 5440 으로 넓힌 비교다.
GQA (grouped-query attention). Ainslie et al. (2023) 은 그 중간을 택했다. query head 를 개 그룹으로 나누고, 그룹마다 key·value head 하나를 쓴다. 이면 MQA, 면 원래의 multi-head attention(MHA)이다. 이미 학습한 MHA 모델도 그룹 안의 key·value projection 가중치를 평균 내서 합친 뒤 원래 사전학습 스텝의 5% 만큼 더 학습하면 GQA 로 바꿀 수 있다 (2.1절, 3.1절). T5-XXL 에서 GQA-8 은 여러 요약·번역·QA 과제의 평균 점수가 47.1 로 MHA 의 47.2 와 거의 같고, 샘플당 추론 시간은 1.51 초에서 0.28 초로 약 5.4 배 줄었다 (Table 1, TPUv4). Llama 3 8B 는 query head 32 개에 key·value head 8 개를 쓰므로 캐시가 MHA 의 4 분의 1 이다.
MLA (multi-head latent attention). DeepSeek-V2 (DeepSeek-AI, 2024, 2.1절) 는 head 수를 줄이는 대신 key·value 를 짧은 벡터 하나로 압축해 저장한다.
| 기호 | 뜻 | DeepSeek-V2·V3 의 값 |
|---|---|---|
| 토큰 의 hidden vector | 길이 = 5120 (V2), 7168 (V3) | |
| key 와 value 를 함께 압축한 latent 벡터. 캐시에 저장하는 것은 이것이다 | 길이 | |
| hidden vector 를 latent 로 줄이는 가중치 | ||
| latent 에서 head 별 key·value 를 복원하는 가중치 | ||
| 복원한 key·value. head 개, head 길이 |
캐시에는 128 개 head 의 key·value( 개 값) 대신 길이 512 짜리 latent 하나만 남는다. decode 할 때 key 를 매번 복원하면 계산이 늘어날 것 같지만, query 와 key 의 내적 에서 를 query 쪽 가중치에 미리 합쳐 두면 latent 와 바로 내적할 수 있다. value 쪽 도 출력 가중치 에 합친다 (2.1.2절, 부록 C). 이렇게 하면 모든 query head 가 latent 하나를 key·value 로 함께 쓰는 셈이라, DeepSeek 은 이 형태를 MLA 의 “MQA 모드” 라 부른다. DeepSeek-V3.2 보고서 (부록 A) 에 따르면 V3.1-Terminus 는 학습과 prefill 에는 key·value 를 복원하는 MHA 모드를, decode 에는 MQA 모드를 쓴다. 보고서가 이유를 따로 적지는 않았지만, 연산이 병목인 prefill 에서는 복원 비용이 크지 않고 캐시 읽기가 병목인 decode 에서는 작은 latent 만 읽는 쪽이 유리하다는 prefill·decode 병목의 구분으로 읽을 수 있다.
이 합치기는 위치 정보를 넣는 RoPE 와 충돌한다. RoPE 는 key 를 위치에 따라 회전시키는데, 회전 행렬이 와 query 사이에 끼면 행렬곱의 순서를 바꿀 수 없어 를 query 쪽에 합칠 수 없다. 그러면 decode 마다 과거 토큰의 key 를 전부 다시 계산해야 한다. DeepSeek-V2 는 위치 정보만 따로 담는 길이 짜리 key 를 하나 더 두고 RoPE 는 거기에만 적용했다 (decoupled RoPE, 2.1.3절). 이 key 는 모든 head 가 함께 쓴다. 그래서 토큰당 층마다 캐시는 개 값이다.
DeepSeek-V2 는 DeepSeek 67B 대비 KV cache 를 93.3% 줄이고 최대 생성 처리량을 5.76 배 높였다고 보고했다 (초록, 1장). 처리량은 가중치를 FP8, KV cache 를 원소당 평균 약 6 비트로 양자화하고 H800 8 장으로 잰 값이다. 93.3% 에 이 양자화가 포함되는지는 논문에 나와 있지 않다. 같은 규모의 MoE 모델끼리 비교한 실험(부록 D.2)에서는 MLA 가 MHA 의 14%(약 16B 모델), 4%(약 250B 모델) 크기 캐시로 MHA 보다 좋은 성능을 냈다. DeepSeek-V3 도 같은 MLA 를 쓴다 (V3 보고서 2.1절).
같은 계산을 메모리 IO 를 줄여서 한다: FlashAttention 계열
attention 식을 그대로 구현하면 점수 행렬 와 softmax 결과 를 HBM 에 쓰고, 다음 단계에서 다시 읽는다. 행렬이 칸이라 아래 GPT-2 측정에서 보듯 이 읽기·쓰기가 시간의 대부분을 차지한다. FlashAttention (Dao et al., 2022) 은 계산 결과는 그대로 두고 이 왕복을 없앤다.
방법은 두 가지다.
- tiling. 를 SRAM 에 들어가는 크기의 블록으로 잘라 불러오고, 한 블록의 점수 계산·softmax·value 곱을 SRAM 안에서 끝낸 뒤 출력만 HBM 에 쓴다. 이 과정 전체를 CUDA kernel 하나로 합친다(kernel fusion).
- online softmax. softmax 는 행 전체의 최댓값과 지수 합이 있어야 계산되는데, 블록 단위로는 행의 일부만 보인다. 그래서 행마다 지금까지의 최댓값 과 지수 합 을 들고 다니다가, 새 블록에서 더 큰 값이 나오면 이전 누적값을 배로 줄여 맞춘다.
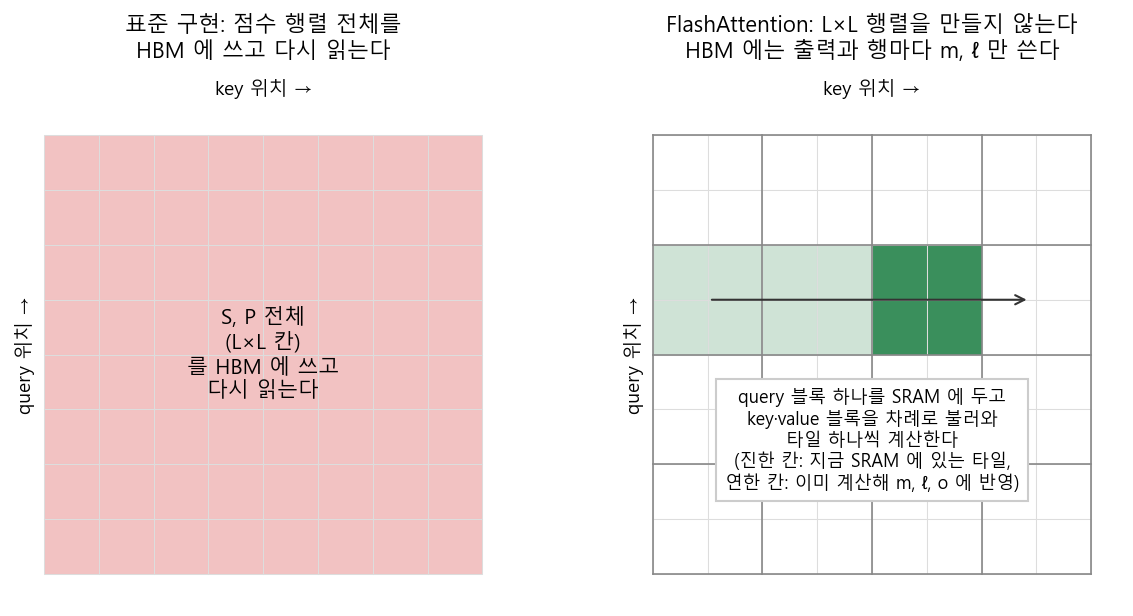
두 그림 모두 가로가 key 위치, 세로가 query 위치인 점수 행렬이다. 왼쪽 표준 구현은 행렬 전체(빨강)를 HBM 에 만든다. 오른쪽 FlashAttention 은 query 블록 하나를 SRAM 에 올려 둔 채 key·value 블록을 왼쪽부터 하나씩 불러온다. 진한 초록 타일이 지금 계산 중인 것이고, 연한 초록은 이미 계산해서 , 과 출력 누적값에 반영한 뒤 버린 것이다. 흰 칸은 아직 계산하지 않았거나 다른 query 블록의 몫이다. 어느 순간에도 SRAM 에는 타일 하나 분량만 있고, 행렬 전체는 어디에도 저장되지 않는다.
online softmax 를 앞의 토큰 세 개 예에서 토큰 3 으로 따라가 본다. 스케일링한 점수는 이고, key·value 를 {토큰 1, 2} 와 {토큰 3} 두 블록으로 나눈다. 정규화하지 않은 출력 누적값을 라 한다.
| 단계 | |||
|---|---|---|---|
| 블록 1 (점수 0.707, 0.707) | 0.707 | ||
| 블록 2 (점수 1.414). 이전 값에 을 곱하고 새 항을 더한다 | 1.414 | ||
| 끝에서 로 나눈다 |
결과는 처음에 행 전체로 계산한 토큰 3 의 출력 과 같다. FlashAttention 은 근사가 아니라 표준 attention 과 같은 값을 계산하고(Theorem 1), 추가 메모리는 이 아니라 에 비례한다.
HBM 접근 횟수는 표준 구현이 , FlashAttention 이 이다 (Theorem 2). 은 시퀀스 길이, 는 head 길이, 은 SRAM 크기다. 가 64–128, 이 약 100 KB 이면 이 보다 훨씬 작아서 접근 횟수가 크게 준다. 역전파에서는 , 를 저장하지 않고 블록마다 다시 계산한다. 연산은 늘지만 HBM 접근이 줄어 전체 시간은 짧아진다. GPT-2 medium(시퀀스 1024, head 16 개, head 길이 64, 배치 64, A100)에서 attention 의 순전파+역전파는 다음과 같았다 (Figure 2).
| 구현 | 연산량 (GFLOPs) | HBM 읽기·쓰기 (GB) | 시간 (ms) |
|---|---|---|---|
| 표준 attention | 66.6 | 40.3 | 41.7 |
| FlashAttention | 75.2 | 4.4 | 7.3 |
연산량은 13% 늘었는데 HBM 읽기·쓰기가 9 분의 1 로 줄어 시간은 5.7 배 짧아졌다. attention 의 비용이 연산이 아니라 메모리 IO 에 있었다는 뜻이다.
후속 버전은 같은 아이디어를 GPU 에 더 잘 맞춘다. FlashAttention-2 (Dao, 2023) 는 행렬곱이 아닌 연산을 줄이고 시퀀스 길이 방향으로도 병렬화해서 FlashAttention 보다 약 2 배 빠르고, A100 이론 최대 연산 속도의 50–73% 에 이른다. FlashAttention-3 (Shah et al., 2024) 는 H100 의 비동기 메모리 복사와 FP8 을 써서 FP16 으로 최대 740 TFLOPs/s(이론 최대의 75%), FP8 로 약 1.2 PFLOPs/s 를 보고했다.
FlashAttention 은 query 가 많은 학습과 prefill 에 맞춰져 있다. decode 에서는 query 가 하나라서 배치 × head 수만큼만 병렬화되고, 배치가 1 이면 GPU 의 1% 도 쓰지 못한다 (Flash-Decoding 블로그, Dao et al., 2023). Flash-Decoding 은 캐시를 길이 방향으로 여러 조각으로 나눠 각각 FlashAttention 으로 계산한 뒤, 조각별 최댓값·지수 합으로 위와 같은 보정을 해서 합친다. A100 에서 배치 1, query head 16 개·key·value head 2 개 조건으로 잰 attention 자체는 FlashAttention 보다 최대 50 배 빨랐다. CodeLlama-34B 로 배치 1, 시퀀스 길이 64K 까지 생성한 전체 속도는 최대 8 배였다 (이 측정의 GPU 종류와 수는 글에 나와 있지 않다).
FlashAttention 계열은 연산량을 줄이지 않는다. 칸을 모두 계산하는 것은 같고, KV cache 크기도 그대로다.
KV cache 를 담는 방식을 바꾼다: PagedAttention, 양자화
PagedAttention. 요청마다 답변이 얼마나 길어질지 모르기 때문에, 기존 서빙 시스템은 요청마다 최대 길이만큼의 연속된 메모리를 미리 잡았다. Kwon et al. (2023, Figure 2) 이 측정해 보니 기존 시스템에서 KV cache 용 메모리 중 실제 토큰의 key·value 가 들어 있는 비율은 20.4–38.2% 였다. 나머지는 미리 잡아 두고 쓰지 않은 자리와 조각난 빈 공간이었다. PagedAttention 은 운영체제의 가상 메모리 paging 처럼 캐시를 16 토큰짜리 블록(기본값)으로 나눠 필요할 때마다 할당하고, 블록 표로 논리적 순서를 기록한다. 같은 실험에서 vLLM 의 이 비율은 96.3% 였다. 같은 prompt 에서 여러 답변을 뽑거나 beam search 를 할 때는 공통 앞부분의 블록을 함께 쓰다가 내용이 갈라질 때만 복사한다(copy-on-write). 그 결과 같은 지연 시간에서 FasterTransformer, Orca 보다 처리량이 2–4 배 높았다. 토큰당 캐시 크기는 그대로이고, 같은 메모리에 더 많은 요청을 담아 배치를 키우는 기법이다. 자세한 내용은 vllm 노트에 있다.
KV cache 양자화. 캐시 크기 식의 (원소당 바이트)를 줄인다. vLLM 은 캐시를 FP8(fp8_e4m3, fp8_e5m2)로 저장하는 옵션을 제공하고, BF16 대비 크기가 절반이 된다. KIVI (Liu et al., 2024) 는 2 비트까지 내렸다. key 는 특정 채널(벡터의 특정 원소 위치)에 큰 값이 몰려 있어서 채널 단위로, value 는 그런 패턴이 없어서 토큰 단위로 양자화 범위를 잡는다. 가장 최근 토큰 몇십 개는 원래 정밀도로 둔다. Llama-2-7B 를 A100 한 장에서 돌렸을 때 가중치까지 포함한 최대 메모리가 2.6 배 줄고, 배치를 최대 4 배 키워 처리량이 2.35–3.47 배 늘었다. 양자화는 근사라서 품질 변화를 따로 확인해야 한다. Quantization 노트가 가중치 양자화를 포함한 일반 내용을 다룬다.
보는 토큰 수를 줄인다: sliding window, NSA, DSA
앞의 기법들은 모든 토큰을 보는 attention 을 더 싸게 계산했다. 이 절의 기법들은 query 하나가 보는 토큰 수 자체를 보다 작게 만든다. 연산량과 decode 의 캐시 읽기가 함께 준다. 대신 모델 구조가 달라지므로 그렇게 학습해야 한다.
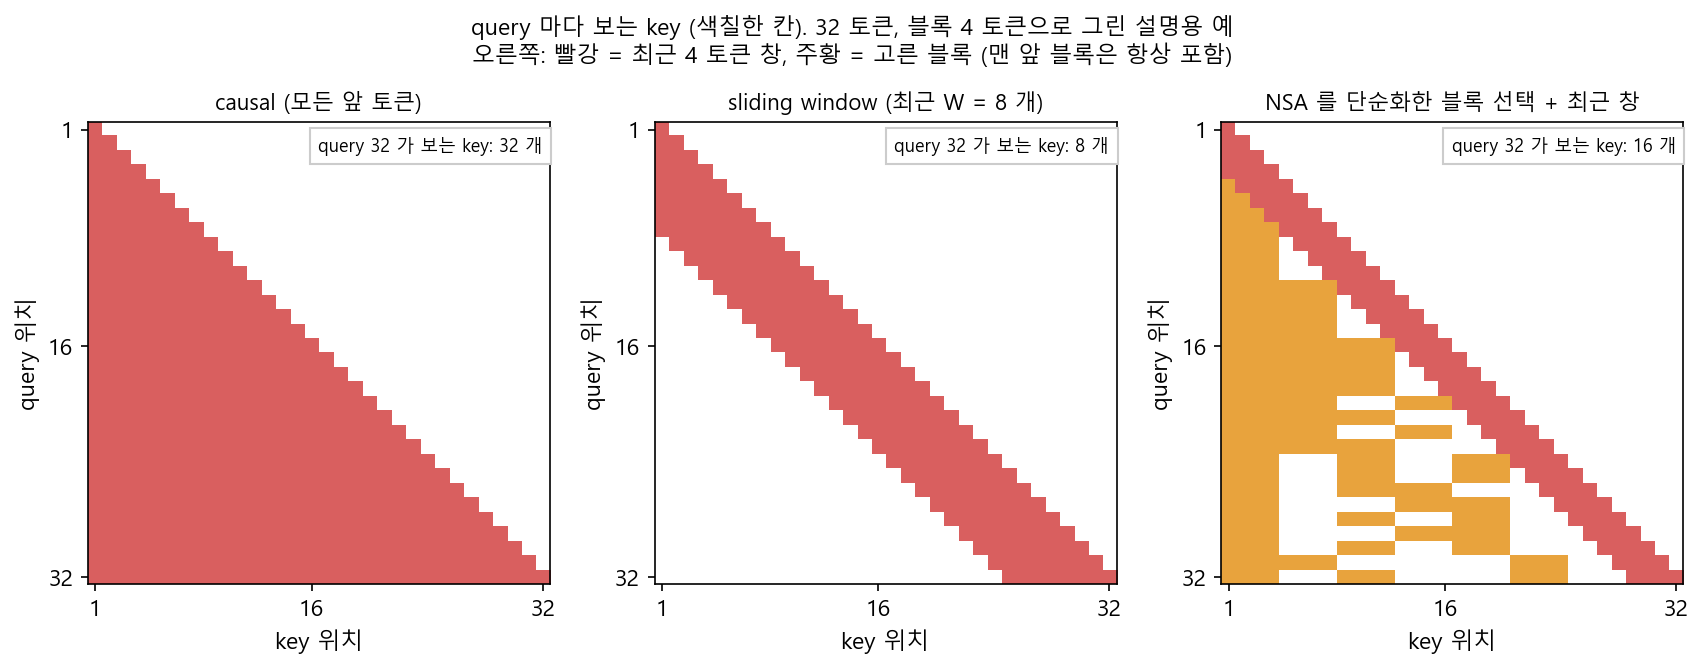
세 그림은 32 토큰 시퀀스에서 query 마다 어떤 key 를 보는지 색칠한 것이다. 크기는 설명용으로 줄였다. 왼쪽 causal attention 은 대각선 아래를 모두 칠하므로 마지막 query 가 key 32 개를 전부 본다. 가운데 sliding window 는 대각선을 따라 폭 인 띠만 남는다. 오른쪽은 아래에서 볼 NSA 를 단순화한 모양이다. 최근 4 토큰 창(빨강)에 더해 4 토큰 블록 몇 개(주황)를 query 마다 골라 본다. 고르는 블록이 query 마다 달라서 줄무늬 모양이 된다. 실제 NSA 는 64 토큰 블록 16 개와 최근 512 토큰을 보고, DSA 는 블록이 아니라 토큰 2048 개를 하나씩 고른다.
Sliding window attention. 각 토큰이 바로 앞 개 토큰만 본다. Mistral 7B 는 을 쓴다 (Jiang et al., 2023, 2절). 한 층에서는 칸 밖을 못 보지만, 층을 하나 지날 때마다 정보가 칸씩 더 전달되므로 번째 층은 최대 칸 앞의 정보까지 받을 수 있다. 32 층이면 이론상 약 131K 토큰이다. 캐시도 층마다 최근 개만 있으면 되므로 고정 크기 버퍼에 돌려 가며 덮어쓴다(rolling buffer). 32K 토큰 시퀀스에서 캐시 메모리가 8 배 줄었다.
NSA (Native Sparse Attention). DeepSeek (Yuan et al., 2025) 은 query 마다 세 갈래로 key·value 를 고르고, 세 결과를 학습된 gate 로 섞는다.
- 압축. 32 토큰 블록(16 토큰 간격)을 작은 MLP 로 key·value 하나씩으로 요약한다. 문맥 전체를 거칠게 본다.
- 선택. 압축 갈래의 attention 점수로 64 토큰 블록의 중요도를 매기고, 상위 16 개 블록(맨 앞 블록 1 개와 최근 블록 2 개는 항상 포함)의 원래 토큰을 그대로 본다.
- 창. 최근 512 토큰을 본다.
블록 단위로 고르는 것은 GPU 가 연속된 메모리를 읽을 때 빠르기 때문이다. 64K 문맥에서 A100 8 장 기준 순전파 9.0 배, 역전파 6.0 배 빨랐다 (Triton 으로 구현한 FlashAttention-2 대비, 5.1절). decode 는 한 스텝에 읽는 토큰이 65,536 개에서 5,632 개로 줄어 11.6 배를 기대할 수 있다고 계산했다 (Table 4). 이것은 시간을 잰 값이 아니라 읽는 메모리 양으로 추정한 값이다. 27B MoE 모델로 사전학습했을 때 일반 벤치마크 평균은 0.456 으로 full attention 의 0.443 보다 높았다 (Table 1).
DSA (DeepSeek Sparse Attention). DeepSeek-V3.2-Exp 와 V3.2 에 들어간 방식이다 (DeepSeek-AI, 2025, 2.1절). 가벼운 점수기(lightning indexer)가 현재 토큰과 앞 토큰들 사이의 점수 를 계산하고, 점수 상위 개 토큰의 캐시 항목만으로 MLA 를 계산한다.
| 기호 | 뜻 |
|---|---|
| 토큰 가 앞 토큰 를 볼 가치를 나타내는 점수 | |
| indexer 의 head 수 (공개 설정 64) | |
| 토큰 에서 만든 indexer 의 query 와 head 가중치 | |
| 토큰 에서 만든 indexer 의 key (길이 128) |
본 attention 의 연산은 에서 로 준다. indexer 자체는 여전히 모든 앞 토큰과 점수를 계산하므로 지만, ReLU 를 쓰고 FP8 로 계산할 수 있게 만들어 MLA 보다 훨씬 싸다 (2.1절, 2.3절). V3.1-Terminus 에서 출발해 indexer 만 먼저 학습하고(21 억 토큰) 전체를 이어서 학습했다(9,437 억 토큰). 비용 감소는 H800 에서 실제 서비스를 측정해 추정한 그래프(Figure 3)로만 제시했고 본문에 수치는 없다. 공개 벤치마크는 V3.1-Terminus 와 비슷하다 (예: MMLU-Pro 85.0 대 85.0).
NSA 와 DSA 는 보는 토큰은 줄여도 캐시에서 지우지는 않는다. 다음 query 가 어느 블록이나 토큰을 고를지 모르기 때문이다. 그래서 캐시 크기는 줄지 않고(DSA 는 indexer 의 key 만큼 오히려 조금 커진다), decode 에서 읽는 양만 준다. sliding window 는 창 밖의 토큰을 지우므로 캐시 크기 자체가 준다.
Softmax attention 을 다른 연산으로 바꾼다: linear attention 과 hybrid
Linear attention. Katharopoulos et al. (2020) 은 를 두 벡터에 각각 함수를 적용한 뒤의 내적 로 바꿨다. 그러면 행렬곱의 순서를 바꿀 수 있다.
| 기호 | 뜻 |
|---|---|
| 벡터의 각 원소에 적용하는 함수. 논문은 을 썼다 | |
| 점수 행렬. 왼쪽처럼 계산하면 에 비례한다 | |
| 길이 과 상관없는 작은 행렬. 오른쪽처럼 계산하면 에 비례한다 |
causal 한 경우에는 를 토큰마다 하나씩 더해 가는 RNN 형태가 된다 (3.4절). 생성할 때 캐시 대신 이 고정 크기 상태 하나만 들고 다니면 되므로, 토큰당 연산과 메모리가 문맥 길이와 상관없이 일정하다. 대신 과거 전체를 고정 크기 상태에 눌러 담기 때문에, 긴 문맥에서 특정 정보를 정확히 찾아오는 능력이 약해질 수 있다. MiniMax-01 보고서 (MiniMax, 2025, 2.2절) 는 linear attention 만 쓴 모델이 긴 문서에서 특정 문장을 찾는 과제(needle in a haystack)에서 한계를 보였다고 적었다.
Hybrid. 그래서 최근 모델은 고정 크기 상태를 갖는 층 사이에 softmax attention 층을 일부만 섞는다. KV cache 는 softmax attention 층에서만 생기므로 그 비율만큼 준다.
| 모델 | 구성 | 출처 |
|---|---|---|
| MiniMax-Text-01 | lightning attention(linear attention 의 한 구현) 7 층마다 softmax attention 1 층, 총 80 층 | MiniMax-01 보고서 2절, 공개 config |
| Jamba | Mamba(state space model) 7 층마다 attention 1 층. 256K 문맥 16 비트 기준 KV cache 4 GB (Mixtral 32 GB) | Lieber et al., 2024, 2절·Table 1 |
| Qwen3-Next-80B-A3B | Gated DeltaNet 3 층마다 gated attention 1 층, 총 48 층 | 공식 모델 카드, config 의 full_attention_interval = 4 |
References
- Bahdanau, Cho, Bengio, 2014, Neural Machine Translation by Jointly Learning to Align and Translate
- Vaswani et al., 2017, Attention Is All You Need — 리뷰는 Attention Is All You Need
- Su et al., 2021, RoFormer: Enhanced Transformer with Rotary Position Embedding
- Llama Team, Meta, 2024, The Llama 3 Herd of Models — Table 3 의 모델 설정
- Agrawal et al., 2024, Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve
- Zhong et al., 2024, DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
- Shazeer, 2019, Fast Transformer Decoding: One Write-Head is All You Need
- Ainslie et al., 2023, GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- DeepSeek-AI, 2024, DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- DeepSeek-AI, 2024, DeepSeek-V3 Technical Report
- Dao et al., 2022, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Dao, 2023, FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- Shah et al., 2024, FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
- Dao, Haziza, Massa, Sizov, 2023, Flash-Decoding for long-context inference
- Kwon et al., 2023, Efficient Memory Management for Large Language Model Serving with PagedAttention
- Liu et al., 2024, KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache
- vLLM 문서, Quantized KV Cache
- Jiang et al., 2023, Mistral 7B
- Yuan et al., 2025, Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
- DeepSeek-AI, 2025, DeepSeek-V3.2-Exp: Boosting Long-Context Efficiency with DeepSeek Sparse Attention, DeepSeek-V3.2
- Katharopoulos et al., 2020, Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention
- MiniMax, 2025, MiniMax-01: Scaling Foundation Models with Lightning Attention
- Lieber et al., 2024, Jamba: A Hybrid Transformer-Mamba Language Model
- Qwen, Qwen3-Next-80B-A3B-Instruct 모델 카드
- Visualizing A Neural Machine Translation Model (Mechanics of Seq2seq Models With Attention)
- 딥 러닝을 이용한 자연어 처리 입문, 어텐션 메커니즘, 트랜스포머