트랜스포머 (Transformer) 는 2017 년 구글이 발표한 논문인 “Attention Is All You Need” 에서 나온 모델
기존의 seq2seq 의 구조인 인코더 - 디코더를 따르면서도, 논문의 이름처럼 어텐션 (attention) 만으로 인코더와 디코더를 구현한 모델이다. 즉, RNN 보정을 위한 용도가 아니라 어텐션을 독자적으로 활용하는 것을 목적으로 한다.
Motivation
RNN 에서 LSTM 으로 넘어가면서 시퀀스 모델의 성능은 향상되었지만, 모델의 복잡도는 올라간다. 그리고 데이터 flow 가 sequential 하다 보니, 정보의 흐름에서 bottleneck 이 발생할 수 밖에 없다.
transformer 는 병렬로 시퀀스 데이터를 처리하기 때문에 훨씬 속도가 빠르며 성능도 좋다.
Core Idea of Transformer
transformer 의 각 층은 두 부분으로 이뤄진다. 토큰들이 서로의 정보를 섞는 multi-head self-attention 과, 토큰마다 따로 적용하는 feed-forward 네트워크다.
self-attention 은 각 토큰의 hidden vector 에서 query, key, value 세 벡터를 만들고, query 와 모든 key 의 내적을 softmax 로 정규화한 가중치로 value 들을 더해 그 토큰의 새 표현을 만든다. 예를 들어 “제인은 9 월에 아프리카를 방문했다” 에서 ‘아프리카’ 의 표현에는 ‘방문했다’ 의 정보가 많이 섞일 수 있다. multi-head attention 은 이 계산을 서로 다른 가중치로 번 나란히 하고 결과를 이어 붙인다. 한 토큰이 여러 종류의 관계를 동시에 참고하게 하려는 것이다.
계산 과정의 식과 직접 따라가는 수치 예제, causal mask, 위치 정보, 시퀀스 길이에 따른 비용은 Attention 노트에 정리했다.
Transformer 구조
Transformer 는 여러 개의 인코더와 디코더가 개의 단위로 구성된 구조를 가지고 있습니다.
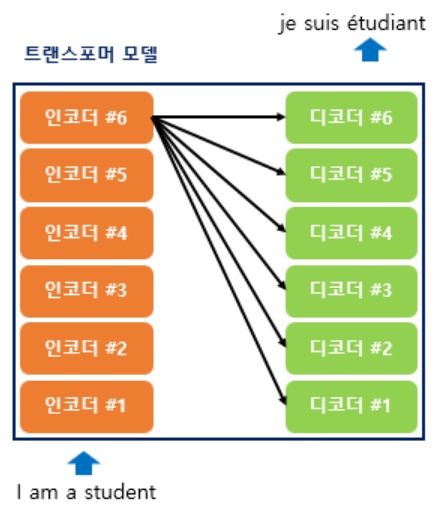
주요 Parameter
- : 트랜스포머 인코더와 디코더에서 입력과 출력의 크기를 나타냅니다.
- num of layers: 인코더와 디코더에 포함된 레이어의 수를 의미합니다.
- num of heads: 멀티헤드 어텐션에서 사용되는 헤드의 수입니다.
- : 트랜스포머 내부 feed forward 네트워크에서 hidden layer 의 크기를 나타냅니다.
Transformer 특징
포지셔널 인코딩 (Positional Encoding)
Transformer 는 RNN 과 달리 단어를 순차적으로 입력받지 않기 때문에, 각 단어의 위치 정보를 모델이 이해할 수 있도록 임베딩 벡터에 위치 정보를 더해줍니다. 이를 통해 모델은 입력 데이터 내에서 각 단어가 어떤 순서에 있는지를 파악할 수 있습니다.
아래 그림은 positional encoding 이 더해지는 과정을 시각화한 것입니다:


“Pre-norm” Architecture
A “Pre-norm” architecture is a re-ordering of the transformer model’s operations which makes it mathematically cleaner to reliably train. This correction was proposed by a number of groups, including a collaboration between Chinese academics and Microsoft Research Asia.