핵심 요약
- “카디널리티의 4제곱근을 임베딩 차원으로 쓴다” 는 출발점일 뿐 정답이 아니다.
- 식은
dimension = vocab_size ** 0.25다. 밑은 카디널리티(고유값 수)이고, 임베딩 차원이 아니다. - Google TensorFlow 팀이 2017년 feature column 소개 글에서 “general rule of thumb” 으로 소개했다. 같은 글이 “원하는 대로 정해도 된다” 고 덧붙였고, 식의 근거는 밝히지 않았다.
- 식은
- 이 식은 값이 작게 나온다. 카디널리티 1,000 이면 6, 100만이면 32, 1억이면 100 이다.
- 실제 추천 모델은 모든 필드에 고정 차원 하나(16·32·64 등)를 주고, 검증 성능을 보며 고친다.
- 임베딩 테이블의 행 수와 열 수는 따로 정한다.
- 행 수(값을 몇 개 담을지)가 너무 크면 hashing trick 으로 줄인다.
- 열 수(값 하나에 숫자 몇 개를 줄지)가 이 노트에서 다루는 차원이다.
차원을 정해야 하는 자리
쇼핑몰에서 사용자가 상품을 클릭할지 예측하는 모델을 만든다고 하자. 입력에는 범주형 값 세 개가 들어간다.
- 상품 카테고리: 1,000 개
- 상품 ID: 100만 개
- 사용자 ID: 1억 명
모델은 문자열을 바로 못 받으므로 값마다 숫자 벡터를 하나씩 배정한다. 이 벡터가 임베딩(embedding)이고, 벡터를 모아 둔 표가 임베딩 테이블이다. 테이블은 값마다 한 행이고, 열의 수가 임베딩 차원이다. 차원을 64 로 정하면 상품 하나가 숫자 64 개로 표현된다.
차원은 두 방향으로 틀릴 수 있다.
- 너무 작으면 서로 다른 값을 구분해 둘 자리가 모자란다. 상품 100만 개를 숫자 2 개로 표현하면 평면 위 점 100만 개가 된다. 취향이 전혀 다른 상품도 가까이 놓일 수밖에 없다.
- 너무 크면 메모리를 많이 먹고, 드문 값이 학습되지 않는다.
그래서 카디널리티가 클수록 차원도 조금 크게 주자는 경험 법칙(rule of thumb)이 여럿 나왔다. 4제곱근 규칙이 그중 하나다.
4제곱근 경험 법칙
TensorFlow 팀의 feature column 소개 글은 어휘 81 개짜리 예시에 3 차원 임베딩을 쓰고, 그 이유를 이렇게 설명한다.
embedding_dimensions = number_of_categories ** 0.25 # 81 ** 0.25 = 3같은 설명이 TensorFlow 1.x 의 feature column 가이드에도 있다. 두 문서 모두 이 식을 “대략적인 지침” 이라고 부르고, 왜 하필 4제곱근인지는 설명하지 않는다.
쇼핑몰 예시의 세 필드에 대 보면 다음과 같다.
- 상품 카테고리 1,000 개 → 5.6 차원
- 상품 ID 100만 개 → 32 차원
- 사용자 ID 1억 명 → 100 차원
카디널리티가 10만 배 늘어도 차원은 18배밖에 안 늘어난다. 지수가 0.25 라서 차원을 두 배로 늘리려면 카디널리티가 16 배가 돼야 한다.
다른 경험 법칙과의 비교
경험 법칙마다 같은 카디널리티에 주는 차원이 크게 다르다. 아래 그림에서 가로축은 카디널리티, 세로축은 임베딩 차원이고 두 축 모두 로그 눈금이다. 점은 쇼핑몰 예시의 세 필드 위치다.
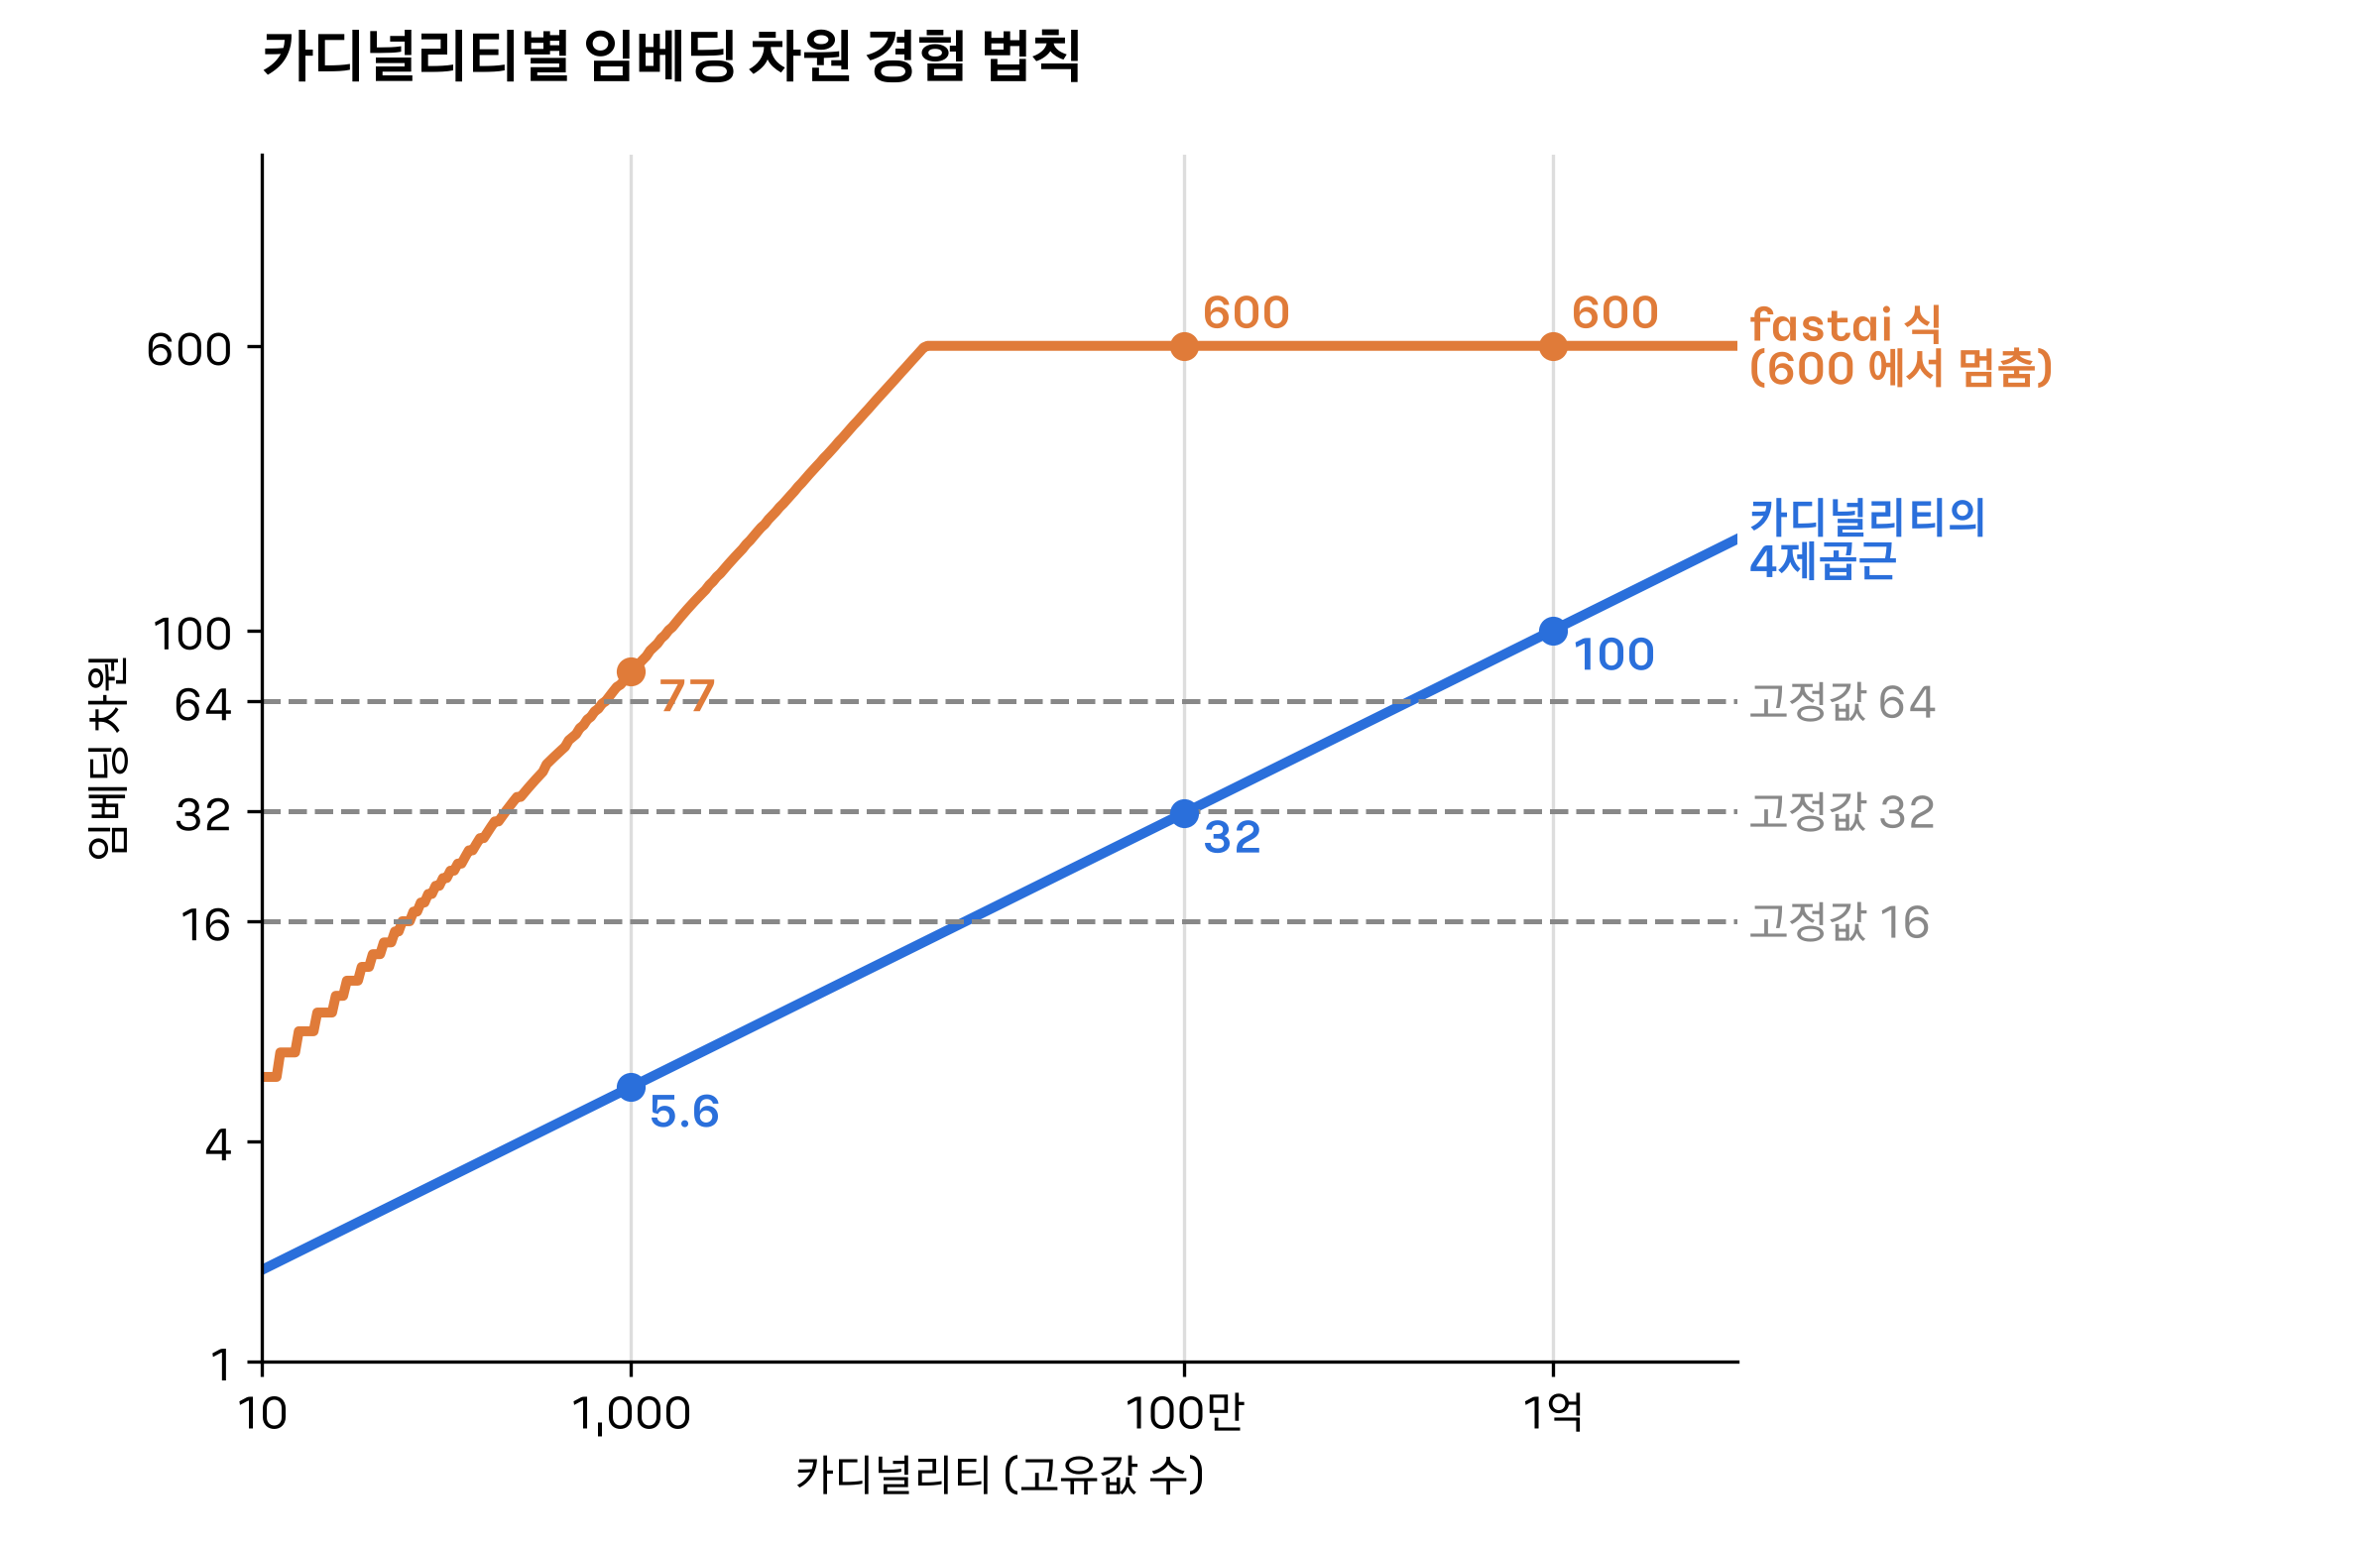
fastai 식은 같은 카디널리티에서 4제곱근보다 훨씬 큰 차원을 준다.
- fastai 의 표 데이터용 모델은 범주형 열의 기본 임베딩 차원을 이 식으로 정한다.
min(600, round(1.6 * n_cat ** 0.56))
- 지수가 0.56 이라 4제곱근보다 빨리 자라고, 카디널리티가 약 4만을 넘으면 600 에서 멈춘다.
- 카디널리티 1,000 이면 77, 100만과 1억은 둘 다 600 이다.
YouTube 추천 모델은 카디널리티의 로그에 비례하게 차원을 늘렸다.
- Covington et al. (2016) 의 ranking 모델은 범주형 feature 마다 차원이 “고유값 수의 로그에 대략 비례” 하는 임베딩을 따로 뒀다.
- 비례 상수는 논문에 없어서 구체적인 값은 계산할 수 없다. 로그는 4제곱근보다도 더 느리게 자란다.
Wide & Deep 과 DLRM 은 모든 필드에 같은 차원을 줬다.
- Wide & Deep (Cheng et al., 2016) 은 Google Play 앱 추천에서 모든 범주형 feature 에 32 차원을 썼다. 논문은 임베딩 차원이 “보통 O(10) 에서 O(100)” 이라고 적었다.
- Facebook(현 Meta) 의 DLRM (Naumov et al., 2019) 은 모든 범주형 feature 를 같은 차원으로 둔다고 설계에 못 박았다. Criteo 광고 데이터 실험에서는 16 차원을, 성능 측정 예시에서는 64 차원을 썼다.
세 필드로 나란히 놓으면 다음과 같다.
| 카디널리티 | 4제곱근 | fastai 식 | 고정값 (Wide & Deep · DLRM) |
|---|---|---|---|
| 1,000 (카테고리) | 6 | 77 | 16, 32, 64 중 하나를 모든 필드에 |
| 100만 (상품 ID) | 32 | 600 | 같음 |
| 1억 (사용자 ID) | 100 | 600 | 같음 |
4제곱근이 작게 나오는 이유와 실제 모델의 선택
4제곱근은 작은 필드에서 특히 작게 나온다.
- 원래 예시가 어휘 81 개짜리 필드였다. 그 크기에서 나온 3 차원은 그럴듯해 보인다.
- 카테고리 200 개짜리 필드는 3.8 차원, 1,000 개짜리는 5.6 차원이 된다. fastai 식은 같은 필드에 31, 77 을 준다.
- 사용자 ID 1억 명처럼 아주 큰 필드에서는 100 차원이 나와, 흔히 쓰는 고정값 64 와 비슷하거나 더 크다.
흔한 오해: 경험 법칙이 주는 값이 “충분한 차원” 을 보장하지는 않는다.
- 경험 법칙이 보는 것은 카디널리티 하나뿐이다.
- 맞는 차원은 데이터 양, 필드가 담는 정보, 모델 구조에 따라 달라진다.
대형 추천 모델이 필드마다 다른 차원 대신 고정 차원 하나를 쓰는 데는 구조상 이유가 있다.
- DLRM, Factorization Machine 계열 모델은 필드의 임베딩끼리 내적해 상호작용을 계산한다. 내적하려면 두 벡터의 길이가 같아야 하므로 모든 필드의 차원이 같아야 한다.
- 필드가 수십 개면 필드마다 차원을 따로 고르는 조합이 너무 많다. 값 하나를 정해 두고 16, 32, 64 처럼 두세 개만 바꿔 보는 편이 싸다.
- 그래서 작은 필드는 경험 법칙보다 큰 차원을 받고, 큰 필드는 경험 법칙과 비슷하거나 작은 차원을 받게 된다.
빈도에 따라 차원을 다르게 주기 (mixed-dimension embedding)
같은 필드 안에서도 자주 나오는 값과 드문 값에 다른 차원을 줄 수 있다.
- Ginart et al. (2019) 은 자주 조회되는 값에는 큰 차원을, 드문 값에는 작은 차원을 줬다.
- 값들을 빈도에 따라 몇 묶음으로 나누고 묶음마다 차원을 다르게 둔다.
- 차원이 다른 벡터는 묶음별 projection 행렬로 같은 길이로 늘린 뒤 모델에 넣는다. 그래서 내적하는 모델에도 쓸 수 있다.
- Criteo 데이터의 클릭 예측에서 파라미터를 절반으로 줄이면서 정확도가 약 0.1% 올랐다. 정확도를 그대로 두면 파라미터를 약 16 배 줄일 수 있었다.
- 한 번만 나타난 상품이 숫자 64 개를 다 맞추지 못하는 문제도 함께 줄어든다. 드문 값은 처음부터 맞출 숫자가 적다.
실제로 정하는 순서
- 모든 필드에 고정 차원 하나로 시작한다. 16, 32, 64 가 흔한 출발점이다.
- 4제곱근과 fastai 식은 필드별 값의 대략적인 범위를 잡을 때 참고한다.
- 차원을 두세 가지로 바꿔 검증 데이터의 AUC 나 log loss 를 비교한다.
- 차원도 다른 하이퍼파라미터와 같은 방식으로 고른다 (Hyperparameter Optimization).
- 메모리를 확인한다. 테이블 크기는 행 수 × 차원 × 4 바이트다 (fp32).
- 행 수 때문에 넘치면 hashing trick 이나 quotient-remainder trick 으로 행 수를 줄인다.
- 드문 값이 대부분인 필드라면 mixed-dimension embedding 을 검토한다.
References
- TensorFlow Team. Introducing TensorFlow Feature Columns (Google Developers Blog, 2017-11-20) —
number_of_categories**0.25, 어휘 81 개 → 3 차원 - TensorFlow 1.15 guide: Feature Columns — 같은 경험 법칙
- fastai
tabular/model.py,emb_sz_rule—min(600, round(1.6 * n_cat**0.56)) - Covington, Adams, Sargin. Deep Neural Networks for YouTube Recommendations (RecSys 2016) — 4.1절 Feature Representation 의 Embedding Categorical Features
- Cheng et al. Wide & Deep Learning for Recommender Systems (DLRS 2016, arXiv:1606.07792) — 3.2절, 4.2절 (32 차원)
- Naumov et al. Deep Learning Recommendation Model for Personalization and Recommendation Systems (arXiv:1906.00091, 2019) — 2.2절 같은 차원, 5절 실험 16 차원 · 64 차원
- Ginart, Naumov, Mudigere, Yang, Zou. Mixed Dimension Embeddings with Application to Memory-Efficient Recommendation Systems (arXiv:1909.11810, 2019)