Hashing trick(feature hashing)은 범주형 값을 정수 인덱스로 바꿀 때, 값과 번호를 짝지어 둔 사전(vocabulary) 대신 해시 함수를 쓰는 방법이다. 해시 함수의 출력을 칸 수로 나눈 나머지가 그 값의 인덱스가 된다.
| 기호 | 뜻 |
|---|---|
| 원래 값. 단어, 국가 코드, user ID, 아이템 ID 같은 것 | |
| 문자열이나 정수를 받아 큰 정수를 내는 해시 함수 | |
| 칸 수(해시 공간의 크기). 인덱스는 부터 중 하나다 |
사전이 없으므로 처음 보는 값도 계산만으로 칸을 얻는다. 대가는 충돌(collision)이다. 서로 다른 값이 같은 칸에 떨어지면 모델 파라미터를 나눠 쓴다.
사전 방식이 감당하지 못하게 된 배경
모델은 문자열을 직접 받지 못하므로 범주형 값을 정수로 바꿔야 한다. 기본 방법은 학습 데이터를 한 번 훑어 {"KR": 0, "JP": 1, "US": 2, ...} 같은 사전을 만드는 것이다. 이 정수가 one-hot 벡터에서 1 의 위치, 선형 모델의 가중치 번호, 딥러닝 모델의 embedding 테이블 행 번호가 된다. 정수를 매기는 일 자체는 Label Encoding 과 같다.
값이 수백 개이고 잘 바뀌지 않으면 사전으로 충분하다. 텍스트 분류나 추천·광고에서는 사정이 다르다.
- 값의 종류가 수천만, 수억 개가 됐다. Weinberger et al. (2009) 의 스팸 필터 데이터에는 이메일 320만 통에 고유 단어가 약 4,000만 개 있었다. 추천·광고의 user ID 와 아이템 ID 도 억 단위다. 사전이 그만큼 커지고, 학습 워커와 서빙 서버가 모두 그 사전을 들고 있어야 한다.
- 값이 계속 새로 생긴다. 사전을 만든 뒤에 나타난 값을 OOV(out-of-vocabulary)라고 한다. OOV 는 보통
[UNK]같은 번호 하나로 묶이므로, 사전을 다시 만들기 전까지 오늘 올라온 아이템 수만 개가 모델 안에서 같은 값이 된다. 데이터를 한 줄씩 읽으며 바로 학습하는 온라인 학습에서는 사전을 다시 만들 틈도 없다. - 조합 feature 는 종류가 곱으로 늘어난다. 사용자와 아이템을 이어 붙인 feature cross 는 사용자 1,000만 명 × 아이템 100만 개면 가능한 조합이 개다. Weinberger et al. 의 개인화 스팸 필터는 사용자 43만 명 × 단어 4,000만 개, 약 17조 가지 조합을 feature 로 썼다.
- 학습과 서빙이 같은 사전을 봐야 한다. 사전을 다시 만들면 번호가 바뀌므로, 옛 사전으로 학습한 모델에 새 사전을 쓰면 엉뚱한 가중치를 읽는다.
Hashing trick 은 사전을 함수 하나로 바꿔 이 문제들을 없앤다. 함수는 어느 서버에서 계산해도 같은 값을 내므로 배포할 것이 없고, 메모리는 값의 종류가 아니라 미리 정한 칸 수 에 비례한다.
사용 예시
국가 코드 6개를 8칸에 넣기
국가 코드 6개를 사전 방식과 칸의 hashing trick 으로 각각 번호를 매겨 본다. 해시 함수는 MD5 출력의 앞 8바이트를 정수로 읽은 것을 썼다. 해시 입력에는 값 앞에 필드 이름을 붙인 country=KR 같은 문자열을 넣는다. 그래야 다른 필드에 같은 문자열 KR 이 있어도 다른 칸으로 간다. 사전을 만든 뒤에 처음 나타난 값 IT 도 함께 넣었다.
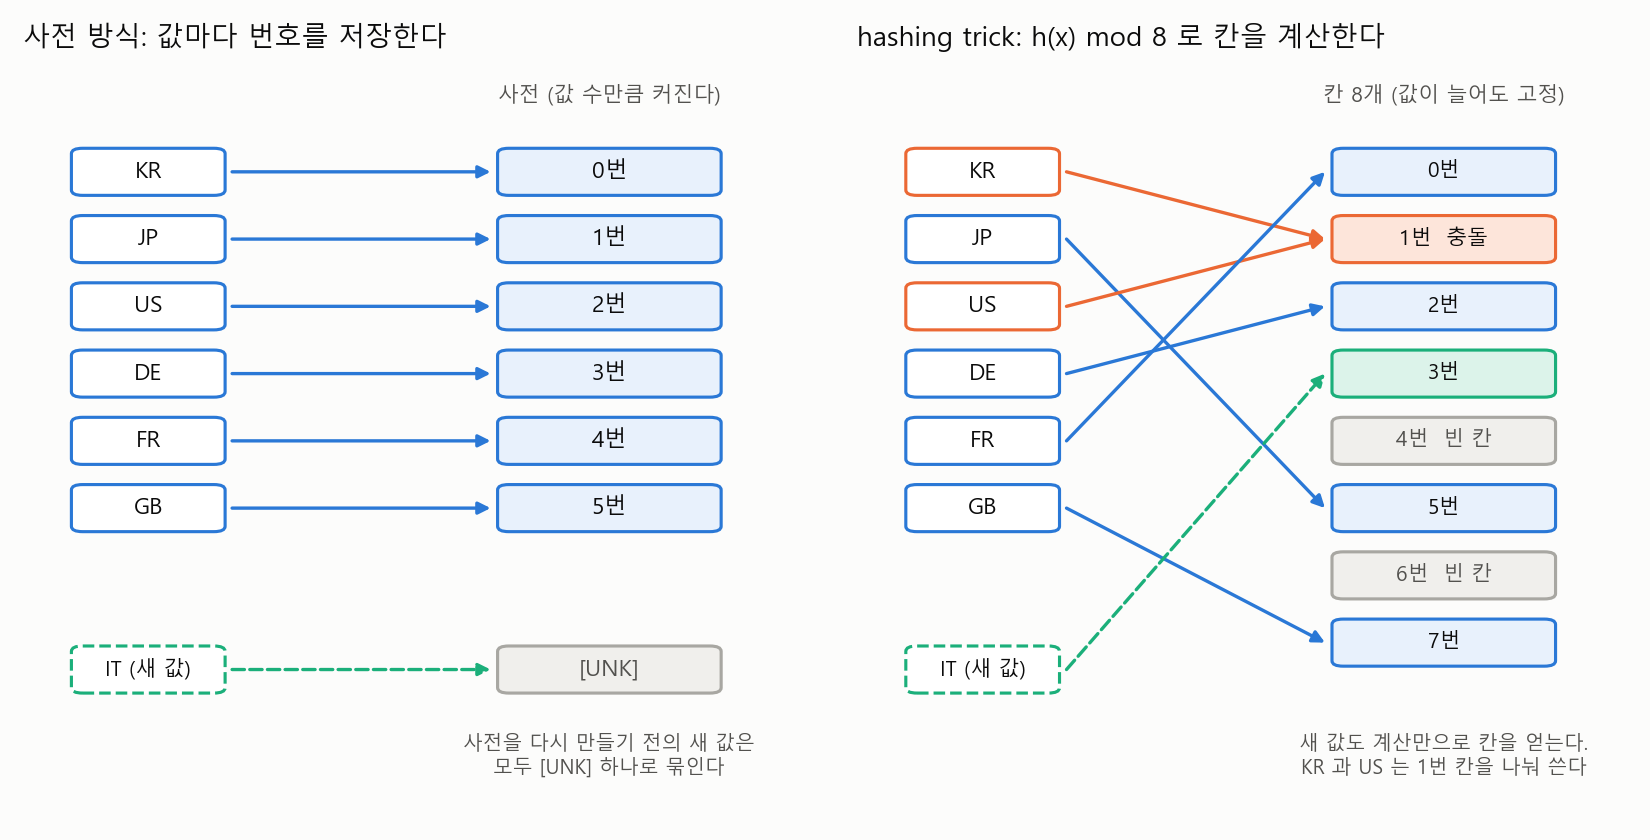
왼쪽 사전 방식은 값마다 번호를 하나씩 저장하므로 번호가 겹치지 않는다. 대신 사전이 값의 수만큼 커지고, 사전에 없던 IT 는 [UNK] 로 간다. 오늘 생긴 새 값이 만 개라면 만 개 모두 [UNK] 하나를 쓴다.
오른쪽 hashing trick 은 저장하는 것 없이 칸을 계산한다. IT 도 계산만으로 3번 칸을 받았다. 그런데 KR 과 US 가 둘 다 1번 칸에 떨어졌다. 선형 모델이라면 1번 가중치 하나가 두 나라의 효과를 함께 학습하고, embedding 모델이라면 두 나라가 같은 벡터를 쓴다. 6개를 8칸에 넣으면 이런 충돌은 거의 피할 수 없다. 6개가 모두 다른 칸에 들어갈 확률은 다. 반대로 4번과 6번 칸은 아무 값도 받지 않았지만 메모리는 차지한다.
선형 모델: scikit-learn FeatureHasher
scikit-learn 은 문자열 목록을 바로 해시 벡터로 바꾼다. 예시 하나에 feature 가 여러 개여도 같은 해시 공간에 함께 들어간다.
from sklearn.feature_extraction import FeatureHasher

h = FeatureHasher(n_features=8, input_type="string")
X = h.transform([["country=KR", "device=ios"], ["country=US", "device=android"]])
print(X.toarray())
# [[ 0.  0. -1.  1.  0.  0.  0.  0.]
#  [ 0. -1.  1.  0.  0.  0.  0.  0.]]
각 행에 0 이 아닌 칸이 두 개씩 있다. 필드 두 개가 각자 한 칸씩 받은 것이다. 값이 과 로 섞인 것은 부호 해시 때문이다. FeatureHasher 는 칸을 정하는 해시와 별도로 부호를 하나 더 정해 곱한다(alternate_sign=True 가 기본값). 한 칸에 여러 값이 더해질 때 부호가 무작위로 섞여 있으면 서로 상쇄되어, 해시한 벡터끼리의 내적이 평균적으로 원래 내적과 같아진다. 계산은 부록 “부호 해시가 없애는 편향과 남는 분산” 에 있다. 여기서는 MurmurHash3 를 쓰므로 칸 번호가 위 그림의 MD5 칸 번호와 다르다. 실제로 쓸 때는 n_features 를 기본값 처럼 크게 둔다.
딥러닝 모델: Keras Hashing 층과 embedding
추천 모델에서는 해시 인덱스를 embedding 테이블의 행 번호로 쓴다.
import keras

hashing = keras.layers.Hashing(num_bins=2**20)
embedding = keras.layers.Embedding(input_dim=2**20, output_dim=64)

ids = hashing([["item_123"], ["item_456"]])   # 정수 칸 번호, shape (2, 1)
vecs = embedding(ids)                          # shape (2, 1, 64)
어제 없던 item_789 가 오늘 들어와도 같은 코드로 바로 행을 얻는다. 그 행의 벡터는 아직 이 아이템에 대해 학습된 것이 아니라는 점은 사전 방식의 OOV 와 같다. 차이는 새 아이템들이 [UNK] 하나로 뭉치지 않고 서로 다른 행으로 흩어져, 이후 학습에서 아이템마다 따로 학습된다는 것이다.
두 필드의 조합은 keras.layers.HashedCrossing(num_bins=...) 이 만든다. 값들을 이어 붙여 해시한 뒤 num_bins 로 나눈 나머지를 내므로, 조합 사전 없이 feature cross 를 쓸 수 있다.
장점과 단점
장점
- 사전이 필요 없다. 사전을 만들고, 배포하고, 학습과 서빙에서 맞추는 일이 사라진다.
- 새 값이 바로 자기 칸을 얻는다. OOV 가 한 번호로 뭉치지 않는다.
- 메모리가 고정된다. 값이 아무리 늘어도 테이블은 행이다. fp32, 차원 일 때 테이블 크기는 바이트이고, , 이면 1 GiB 다.
- 조합 feature 를 만들 수 있다. 종류가 곱으로 늘어나는 feature cross 도 칸 수 안에 들어간다.
단점
가장 큰 단점은 충돌이다. 고유값 100만 개를 해시할 때 칸 수에 따라 다른 값과 칸을 나누는 값의 비율이 어떻게 바뀌는지 그렸다. 선은 부록 “충돌 확률 계산” 의 식이고, 점은 실제 문자열을 MD5 로 해시해 센 값이다.
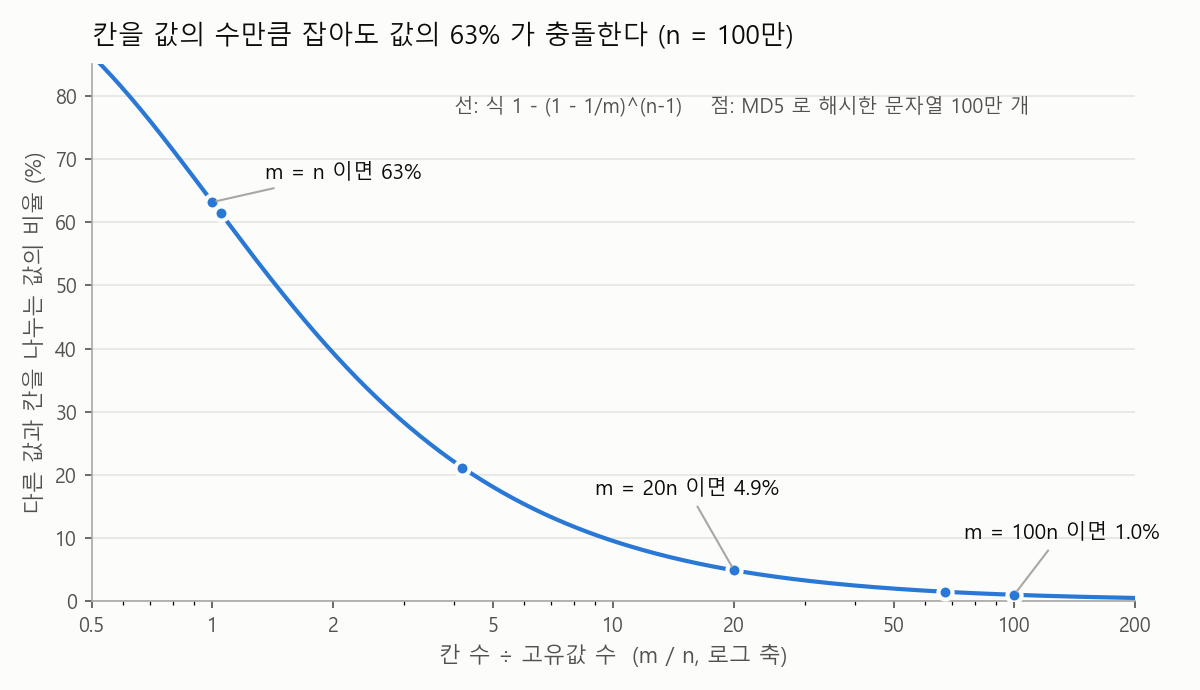
- 칸을 넉넉히 잡아도 충돌이 많다. 고유값 개를 칸 개에 넣으면, 칸을 값의 수만큼 잡아도() 값의 63% 가 다른 값과 칸을 나눈다. 이 비율은 대략 이라서 5% 로 낮추려면 , 1% 로 낮추려면 이 필요하다(부록 “충돌 확률 계산”).
- 충돌만큼 성능이 조금 떨어진다. 충돌 비율이 수십 % 여도 예측 성능은 조금만 떨어지지만 0 은 아니다. Booking.com 의 실험에서는 feature 의 50% 가 충돌해도 log loss 증가가 0.5% 보다 훨씬 작았고, ByteDance 의 Monolith 는 충돌을 없앤 embedding 테이블이 AUC 가 꾸준히 높았다고 보고했다. 흔한 값이 학습 예시 대부분을 차지하므로, 충돌의 영향은 원래 예시가 적던 드문 값에 몰린다(부록 “보고된 실험 결과”, “빈도가 치우친 분포에서의 충돌 영향”).
- 값이 적은 필드에서는 사전보다 비싸다. 국가 200 개처럼 충돌이 하나도 없어야 하는 필드에서, 충돌이 없을 확률을 95% 이상으로 올리려면 이 의 약 10배 필요하다. 항목 200 개짜리 사전이 훨씬 싸다.
- 모델을 해석할 수 없다. 어떤 칸이 어떤 값의 것인지 거꾸로 찾을 수 없다. 호텔 가격 모델에서 덴마크와 그리스가 같은 칸에 들면 두 나라 가중치가 같아진다. 특정 아이템의 가중치만 골라 지우거나 초기화할 수도 없다.
- 칸 수를 미리 정해야 한다. 사전이라는 파라미터가 사라진 대신 이 하이퍼파라미터로 남고, 학습을 시작한 뒤에는 바꿀 수 없다. 바꾸면 모든 값의 칸이 달라진다.
- 해시 함수가 프로세스마다 같아야 한다. Python 의 내장
hash()는 문자열에 프로세스마다 다른 무작위 값을 섞는다. 같은 머신에서print(hash('country=KR'))를 두 번 실행하면-8498896366992136375와-8478133275379407693이 나온다. 라이브러리는 그래서 입력만으로 출력이 정해지는 해시를 쓴다. scikit-learn 은 MurmurHash3, Keras 는 FarmHash64 다.
사용처
대규모 텍스트 분류와 온라인 학습
단어 수가 수천만이고 데이터를 한 줄씩 읽으며 학습하는 선형 모델에서 많이 쓴다. Vowpal Wabbit 이 기본으로 이 방식을 쓴다. Weinberger et al. (2009) 는 사용자별 스팸 필터를 위해 사용자 ID 와 단어를 이어 붙인 feature 까지 칸 하나에 해시했고, 놓친 스팸이 전체 공통 분류기보다 최대 30% 줄었다. 약 17조 가지 조합을 사전에 담는 대신 약 400만 칸에 넣은 것이다.
추천·광고 모델의 ID embedding
CTR prediction 과 추천 모델은 user ID, 아이템 ID 처럼 종류가 많고 계속 늘어나는 필드를 embedding 으로 받는다. 해시 인덱스를 embedding 행 번호로 쓰면 새 아이템도 바로 학습에 들어간다. 해시를 하나만 쓰면 충돌이 많으므로, 독립 해시 여러 개로 행 여러 개를 뽑아 합치는 hash-based embedding 으로 확장해 쓰기도 한다. X 의 추천 모델 Phoenix 가 이 방식을 쓴다.
필드마다 해시 공간을 따로 둘 수도 있고 하나를 함께 쓸 수도 있다. Bernardi (2018) 에 따르면 Vowpal Wabbit 은 모든 필드가 공간 하나를 함께 써서 국가 코드와 user ID 가 서로 충돌할 수 있고, TensorFlow 는 필드마다 따로 둔다. 따로 두면 필드별 고유값 수에 맞춰 을 다르게 줄 수 있다.
칸 수 고르기
- 필드마다 모델을 쓰는 동안 보게 될 고유값 수 을 추정한다. 새 값이 쌓인 뒤의 수를 기준으로 한다.
- 허용할 충돌 비율 을 정하고 로 잡는다. Bernardi (2018) 는 종류가 많고 계속 늘어나는 필드에 , 즉 을 권했다.
- 바이트가 메모리 안에 드는지 본다.
- 값이 수백, 수천 개뿐이고 잘 바뀌지 않는 필드는 해시 대신 사전을 쓴다.
- 가능하면 을 두세 가지로 바꿔 validation log loss 나 AUC 를 비교한다. 충돌이 성능에 주는 영향은 데이터마다 다르다.
대안과 비교
| 방법 | 인덱스를 정하는 방식 | 새 값 | 충돌 | 메모리 |
|---|---|---|---|---|
| 전체 사전 | 학습 데이터의 모든 고유값에 번호 | [UNK] 하나로 묶임 | 없음 | 고유값 수만큼의 행과 사전 |
| 빈도 기반 사전 + OOV 버킷 | 상위 개 값에만 번호. 나머지와 새 값은 OOV 칸 개 중 하나로 해시 | OOV 칸 개로 나뉨 | 드문 값끼리만 | 행과 항목 사전 |
| hashing trick | 모든 값을 칸에 해시 | 바로 칸을 얻음 | 모든 값 사이에 무작위로 | 행 |
| 다중 해시 (hash-based embedding) | 독립 해시 개로 행 개를 뽑아 합침 | 바로 표현을 얻음 | 두 값의 개 행이 모두 같을 확률은 | 행과 해시별 projection |
| quotient-remainder trick | 정수 번호 를 과 두 표로 나눠 두 행을 원소별로 곱함 | 번호를 주는 사전이 있어야 함 | 두 번호 조합이 같은 값은 없음 | 행 |
| 충돌 없는 동적 해시 테이블 (Monolith) | 키를 저장하는 Cuckoo 해시맵에 새 ID 를 삽입 | 삽입해서 새 행을 받음 | 없음 | 저장한 ID 수만큼. 빈도 필터와 만료로 줄임 |
- 빈도 기반 사전 + OOV 버킷 은 흔한 값에는 충돌 없는 번호를 주고, 충돌은 드문 값끼리만 남긴다. Keras
StringLookup에max_tokens와num_oov_indices를 주면 이렇게 된다. 사전이 남으므로 사전을 다시 만드는 주기만큼 새 값이 OOV 칸에 머문다. - 다중 해시 는 사전 없이 충돌만 줄인다. 이어도 면 완전히 같은 표현을 갖는 쌍이 거의 사라진다.
- quotient-remainder trick(Shi et al., KDD 2020)은 사전을 없애는 방법이 아니라 메모리를 줄이는 방법이다. 논문은 같은 파라미터 수에서 hashing trick 보다 loss 가 낮았다고 보고했다.
- Monolith(Liu et al., 2022)는 키를 함께 저장해 충돌을 아예 없애고, 일정 횟수 이상 나타난 ID 만 넣는 빈도 필터와 오래 안 쓰인 ID 를 지우는 만료로 메모리를 묶는다. 사전 대신 키를 실시간으로 넣고 빼는 테이블을 운영하는 비용을 치른다.
부록
충돌 확률 계산
해시 함수가 각 값을 칸 중 하나에 균등하고 독립적으로 보낸다고 가정하면, 충돌은 생일 문제와 같은 계산이 된다.
| 기호 | 뜻 |
|---|---|
| 해시할 고유값의 수 | |
| 칸 수 | |
| 어떤 값 하나가 다른 값 하나 이상과 같은 칸에 들 확률. 나머지 개가 모두 다른 칸에 갈 확률을 1 에서 뺀 것이다 |
두 번째 식은 Bernardi (2018) 가 쓴 식이다. 이면 이다. 이면 가 에 가까워진다.
실제 해시로 확인하려고 item_0 부터 item_999999 까지 문자열 100만 개를 MD5 로 해시하고 칸 수만 바꿨다.
| 칸을 나누는 값의 비율: 식 | 실제 | 같은 칸에 든 쌍: 식 | 실제 | ||
|---|---|---|---|---|---|
| 1,000,000 | 1 | 63.2% | 63.2% | 500,000 | 499,860 |
| = 1,048,576 | 1.05 | 61.5% | 61.5% | 476,837 | 476,765 |
| = 4,194,304 | 4.2 | 21.2% | 21.1% | 119,209 | 118,849 |
| 20,000,000 | 20 | 4.9% | 4.9% | 25,000 | 25,248 |
| = 67,108,864 | 67 | 1.5% | 1.4% | 7,451 | 7,265 |
| 100,000,000 | 100 | 1.0% | 1.0% | 5,000 | 5,113 |
충돌이 하나도 없을 확률은 다음과 같다.
| 200 | 4,000 () | 0.6% |
| 200 | 40,000 () | 60.8% |
| 200 | 1,000,000 | 98.0% |
| 1,000 | 1,000,000 () | 60.7% |
| 1,000 | 10,000,000 | 95.1% |
Bernardi (2018) 는 범주가 1,000 개 미만인 필드에 을 권했지만, 이 크기에서도 충돌이 하나 이상 남을 확률이 40% 쯤이다.
부호 해시가 없애는 편향과 남는 분산
Weinberger et al. (2009) 의 부호 해시는 칸을 정하는 해시 와 독립인 두 번째 해시 로 부호를 정해 곱한다(원문 Definition 1, Eq. 2).
| 기호 | 뜻 |
|---|---|
| 원래 feature 벡터. 는 번째 feature(예: 번째 단어)의 값 | |
| 내적을 구할 상대 벡터(예: 다른 문서). 같은 , 로 해시한다 | |
| feature 가 들어갈 칸 | |
| feature 의 부호. 또는 | |
| 해시한 뒤의 차원 벡터. 는 번째 칸의 값 |
를 고정하고 만 무작위로 고른다고 보면, 다른 feature , 가 같은 칸에 들 확률이 이라서 내적의 기댓값에 항이 하나 더 붙는다.
부호가 없으면() 마지막 항이 빈도처럼 음수가 없는 feature 에서 항상 0 보다 크다. 부호를 무작위로 붙이면 의 기댓값이 0 이라서 이 항이 사라진다(원문 Lemma 2). 분산은 남는다.
문서 두 개로 확인했다. 어휘 10,000 개 중 각자 100 단어를 골라 빈도 1, 2, 3 중 하나를 붙였고, 공유하는 단어가 하나라서 실제 내적은 6 이다. 해시 함수를 무작위로 한 번 뽑을 때마다 두 해시 벡터의 내적을 기록하고, 3,000 번 반복해 평균과 표준편차를 냈다.
| 부호 없음: 평균 | 부호 없음: 위 식의 편향 항 | 부호 있음: 평균 | 표준편차 (부호 없음 / 있음) | 분산 식의 표준편차 | |
|---|---|---|---|---|---|
| 256 | 164.4 | 158.6 | 6.5 | 30.0 / 29.8 | 29.7 |
| 1,024 | 45.7 | 39.6 | 6.5 | 14.7 / 14.7 | 14.9 |
| 4,096 | 16.1 | 9.9 | 5.8 | 7.3 / 7.4 | 7.4 |
부호가 없으면 평균이 실제 내적 6 보다 편향 항만큼 크고, 부호를 붙이면 6 근처로 돌아온다. 표준편차는 두 경우가 같고 을 4배로 늘릴 때마다 절반이 된다. 부호 해시는 평균의 쏠림만 고치고, 충돌 자체를 없애지는 않는다. KR 과 US 의 부호가 다르면 같은 가중치 를 KR 은 , US 는 로 읽을 뿐 두 효과의 크기는 묶여 있다. 같은 구성을 밀집 벡터의 차원 축소에 쓰는 것이 Count Sketch 다.
보고된 실험 결과
- Weinberger et al. (2009), 스팸 필터. 사용자 433,167 명의 이메일 320만 통(고유 단어 약 4,000만 개). 기준선은 단어를 칸에 해시한 공통 분류기다. 공통 분류기는 에서 성능이 더 오르지 않았고, 원문은 이 크기에서 충돌이 분류 오차에 영향을 주지 않았다고 썼다(원문 5절, Figure 2). 사용자 ID 와 단어의 개인화 feature 까지 칸에 넣으면 놓친 스팸이 기준선보다 최대 30% 줄었다.
- Bernardi (2018), Booking.com. Vowpal Wabbit 의 logistic regression 을 Booking.com 내부 데이터(feature 약 20만 개, 예시 약 2.5억 개), Criteo(feature 약 3,000만 개, 예시 약 4,000만 개), Avazu(feature 약 4,000만 개, 예시 약 4,000만 개)에서 칸 수를 바꿔 학습했다. feature 의 50% 가 충돌해도 held-out log loss 증가가 0.5% 보다 훨씬 작았다. 같은 50% 에서 Booking.com 데이터의 log loss 증가는 Criteo 의 두 배를 넘었다.
- Liu et al. (2022), Monolith. MovieLens 에서 DeepFM 을 학습하며 ID 를 MD5 로 해시하자 고유 user ID 가 162,541 개에서 149,970 개로(7.73%), movie ID 가 59,047 개에서 57,361 개로(2.86%) 줄었다(원문 Table 1). 충돌 없는 테이블을 쓴 모델이 첫 epoch 부터 AUC 가 꾸준히 높았다. 차이는 그림으로만 나와 있다(원문 3.2.1절).
빈도가 치우친 분포에서의 충돌 영향
충돌 비율에 비해 성능이 조금만 떨어지는 이유를 가상 분포로 확인했다. 고유값 100만 개의 등장 확률을 Zipf 분포로 두었다. Zipf 분포는 번째로 흔한 값의 등장 확률이 에 비례하는 분포로, 가 클수록 상위 값에 쏠린다. 등장 확률은 학습 예시 중 그 값이 나오는 예시의 비율로 읽으면 된다. 이면 상위 1% 값이 전체 등장의 68% 를, 이면 91% 를 차지한다.
시뮬레이션 한 번은 다음 순서로 돈다.
- 값 100만 개를 각각 칸 중 하나에 무작위로 보낸다.
- 각 값의 “자기 칸 안에서의 비중” 을 계산한다. 그 값의 등장 확률을 같은 칸에 든 값들의 등장 확률 합으로 나눈 것이다. 칸을 혼자 쓰면 1 이다.
- 비중이 90% 미만인 값, 50% 미만인 값의 등장 확률을 각각 더한다. 학습 예시 중 몇 % 가 다른 값에 크게 섞인 칸을 쓰는지를 뜻한다.
이것을 10 번 반복해 평균을 냈다.
| 칸을 나누는 값의 비율 | 그 값들의 등장 비중 | 자기 칸 비중 90% 미만인 값의 등장 비중 | 50% 미만 | ||
|---|---|---|---|---|---|
| 1.0 | 1 | 63.2% | 65.5% | 16.0% | 6.4% |
| 1.0 | 4 | 22.1% | 24.2% | 5.1% | 1.7% |
| 1.2 | 1 | 63.2% | 69.1% | 3.6% | 1.4% |
| 1.2 | 4 | 22.1% | 28.3% | 1.1% | 0.4% |
, 에서 고유값의 63% 가 칸을 나누지만, 다른 값에 10% 넘게 섞인 칸을 쓰는 학습 예시는 16% 이고 다른 값이 더 많은 칸을 쓰는 예시는 6.4% 다. 흔한 값은 칸을 나눠도 그 칸의 가중치를 거의 혼자 학습한다. 이 계산은 Zipf 분포를 가정한 것이고 위 실험들의 데이터를 재현한 것은 아니다.
References
- Weinberger, Dasgupta, Attenberg, Langford, Smola. Feature Hashing for Large Scale Multitask Learning (ICML 2009, arXiv:0902.2206) — Definition 1, Lemma 2, 5절 스팸 필터 실험
- Lucas Bernardi. Don’t be tricked by the Hashing Trick (Booking.com Data Science, 2018) — 충돌 기댓값 식, 세 데이터셋 실험, 칸 수 기준
- Shi, Mudigere, Naumov, Yang. Compositional Embeddings Using Complementary Partitions for Memory-Efficient Recommendation Systems (KDD 2020, arXiv:1909.02107) — quotient-remainder trick
- Liu et al. Monolith: Real Time Recommendation System With Collisionless Embedding Table (ORSUM@RecSys 2022, arXiv:2209.07663) — Table 1, 2.1절, 3.2.1절
- scikit-learn FeatureHasher
- Keras Hashing layer, StringLookup layer, HashedCrossing layer