학습 데이터에만 맞춰진 모델
Overfitting(과적합)은 모델이 학습 데이터를 지나치게 잘 맞춘 나머지, 새 데이터에서는 오히려 성능이 떨어지는 상태다.
학습 데이터에는 데이터를 만들어낸 실제 관계와 함께, 그 표본에만 우연히 들어간 잡음이 섞여 있다. 측정 오차, 라벨을 잘못 붙인 샘플, 이번 표본에서만 우연히 나타난 상관관계 같은 것들이다. 모델이 이 잡음까지 외우면 학습 데이터에서의 오차는 줄어든다. 하지만 잡음은 새 데이터에서 똑같이 반복되지 않으므로, 외운 만큼이 그대로 새 데이터에서의 오차가 된다.
학습 알고리즘이 실제로 최소화하는 것은 학습 데이터에서의 평균 loss 다 (empirical risk minimization). 우리가 원하는 것은 학습 데이터와 같은 분포에서 앞으로 들어올 데이터에서의 성능이고, 이를 일반화(generalization) 성능이라고 한다. 학습 오차는 일반화 오차를 대신 재는 값일 뿐이다. 학습 오차와 새 데이터에서의 오차의 차이를 generalization gap 이라고 하며, overfitting 은 이 차이가 크게 벌어진 상태다.
데이터의 분포 자체가 학습 때와 달라져서 성능이 떨어지는 것은 overfitting 과 다른 문제다. 그 경우는 모델을 아무리 잘 학습해도 생긴다.
예제: 점 10 개에 다항식 맞추기
Bishop (2006) 1.1 절의 다항식 예제를 같은 조건으로 직접 실험했다.
- 참 함수를 로 정하고, 를 0–1 구간에 같은 간격으로 10 개 뽑는다.
- 각 에 표준편차 0.3 인 정규분포 잡음을 더해 학습 데이터를 만든다.
- 1 차, 3 차, 9 차 다항식을 최소제곱법으로 학습 데이터에 맞춘다.
- 같은 방식으로 만든 새 점 1,000 개로 test 오차를 잰다.
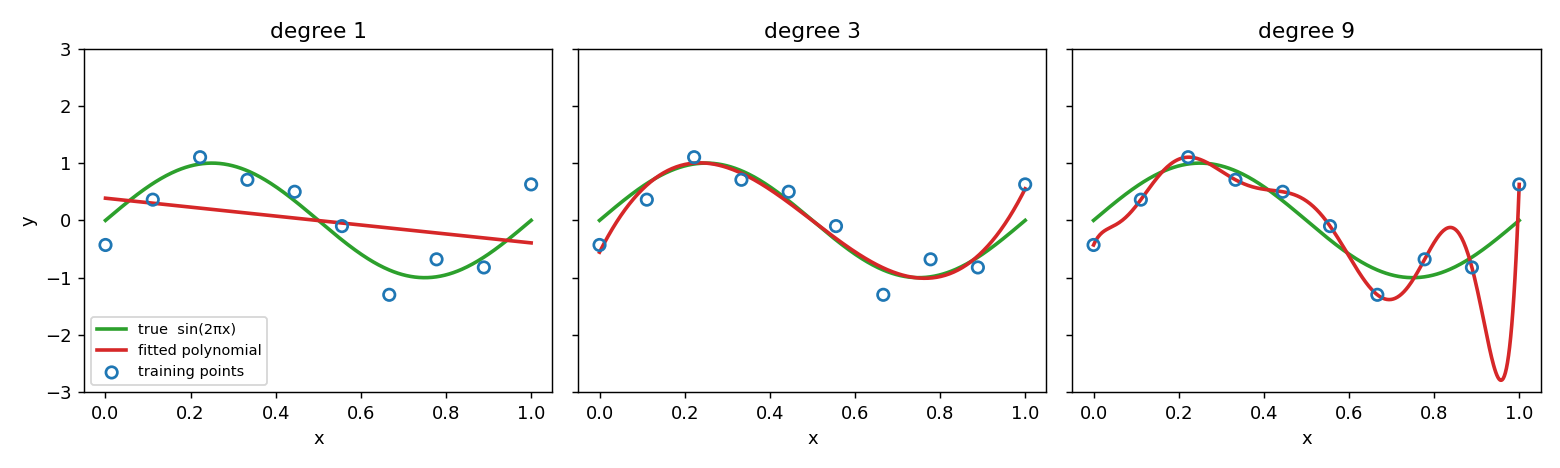
초록 곡선이 참 함수, 파란 원이 학습 데이터, 빨간 곡선이 학습한 다항식이다.
- 1 차 직선은 곡선의 모양을 따라가지 못한다. 학습 데이터조차 맞추지 못하는 underfitting 이다.
- 3 차 다항식은 점을 전부 지나지는 않지만 참 곡선과 거의 겹친다.
- 9 차 다항식은 계수가 10 개다. 미지수 10 개로 점 10 개를 정확히 지나는 다항식은 항상 찾을 수 있으므로 학습 오차가 0 이 된다. 대신 점과 점 사이에서 크게 출렁인다. 근처에서는 까지 내려가는데, 이 위치의 참값은 이다.
학습 데이터를 1,000 번 새로 뽑아 같은 실험을 반복하고 평균을 내면 아래와 같다. RMSE 는 오차 제곱의 평균에 제곱근을 씌운 값으로, 와 같은 단위다.
| 다항식 차수 | 학습 RMSE | test RMSE |
|---|---|---|
| 1 | 0.57 | 0.57 |
| 3 | 0.24 | 0.36 |
| 9 | 0.00 | 0.73 |
잡음의 표준편차가 0.3 이므로, 참 함수를 정확히 알아도 test RMSE 는 0.3 아래로 내려가지 않는다. 3 차의 test RMSE 0.36 은 이 한계에 가깝다.
9 차의 학습 RMSE 0 은 이 한계보다도 낮다. 학습 오차가 잡음 수준보다 낮다는 것은 모델이 잡음까지 맞췄다는 뜻이다. 3 차의 학습 RMSE 0.24 도 0.3 보다 조금 낮은데, 계수 4 개를 맞추는 과정에서 잡음의 일부를 흡수하기 때문이다. 계수가 많을수록 흡수하는 몫이 커지고, 계수가 점의 수와 같은 10 개가 되면 잡음을 전부 흡수한다.
학습 오차와 검증 오차로 진단한다
위 예제에서는 참 함수를 알고 있어서 test 오차를 얼마든지 잴 수 있었다. 실제 문제에서는 새 데이터에서의 오차를 미리 알 수 없으므로, 가진 데이터 일부를 학습에 쓰지 않고 떼어 둔다.
| 데이터 | 쓰임 |
|---|---|
| training set | 모델 파라미터를 학습한다 |
| validation set | 모델 구조와 hyperparameter 를 고르고, overfitting 여부를 진단한다 |
| test set | 모든 선택이 끝난 뒤 최종 성능을 한 번 보고한다 |
데이터가 적어서 validation set 을 따로 떼기 아까우면 cross-validation 으로 여러 번 나눠 평가한다.
판정은 두 오차를 나란히 놓고 한다.
- 학습 오차는 낮은데 검증 오차가 그보다 훨씬 높다 → overfitting. 앞 예제의 9 차 다항식이 그렇다. 학습 RMSE 는 0.00 인데 test RMSE 는 0.73 이다.
- 학습 오차부터 높다 → underfitting. 1 차 직선은 학습 RMSE 도 0.57 이다.
그런데 오차가 낮은지 높은지를 말하려면 비교할 기준값이 있어야 한다. 기준은 그 문제에서 어떤 모델로도 더 내려갈 수 없는 가장 작은 오차다. 데이터 자체에 잡음이 있으면, 정답 규칙을 완벽히 아는 모델도 그 잡음만큼은 틀리기 때문이다.
- 앞 예제는 에 표준편차 0.3 인 잡음을 넣었으므로, 앞에서 본 것처럼 참 함수 로 예측해도 RMSE 가 0.3 이다. 그래서 0.3 이 기준이고, 1 차 직선의 학습 RMSE 0.57 은 기준보다 한참 높으니 높은 것이다.
- 실제 문제에서는 이 최소 오차를 직접 알 수 없어서, 사람의 오류율을 대략적인 기준으로 쓰는 경우가 많다. 사람이 거의 틀리지 않는 선명한 고양이 사진 분류라면 기준은 0% 에 가깝고, 학습 오류율 15% 는 높다. 사진이 흐려서 사람도 20% 를 틀리는 문제라면, 학습 오류율 21% 는 높다고 보기 어렵다.
학습·검증 오차 수치로 판정하는 사례가 Bias-variance tradeoff 에 더 있다.
학습 곡선으로 원인을 좁힌다
오차를 한 번만 재지 않고 무언가를 바꿔 가며 그리면 더 많은 것이 보인다.
epoch 에 따른 곡선. 신경망처럼 반복해서 학습하는 모델은 epoch 이 지날수록 학습 loss 가 계속 내려간다. 검증 loss 는 처음에 같이 내려가다가 어느 시점부터 다시 오른다. 그 시점부터 모델이 학습 데이터에만 있는 세부 사항을 맞추기 시작했다는 뜻이다. 이 지점에서 학습을 멈추는 것이 Early Stopping 이다.
데이터 양에 따른 곡선. 앞 예제의 9 차 다항식에 학습 점의 수만 늘려 보면 다음과 같다. 다른 조건은 그대로 두고 1,000 번 반복한 평균이다.
| 학습 점의 수 | 학습 RMSE | test RMSE |
|---|---|---|
| 10 | 0.00 | 0.73 |
| 15 | 0.17 | 0.40 |
| 30 | 0.24 | 0.35 |
| 100 | 0.28 | 0.32 |
점이 늘수록 학습 오차는 올라가고 test 오차는 내려가서, 둘 다 잡음 수준 0.3 근처로 모인다. 똑같은 9 차 다항식인데 점 100 개를 모두 지나갈 수는 없으니 잡음을 외울 여유가 사라진 것이다. overfitting 은 모델 하나의 성질이 아니라 모델의 자유도와 데이터 양 사이의 관계다.
underfitting 인 모델은 데이터를 늘려도 두 곡선이 높은 오차에서 만난다. 그래서 이 곡선을 그려 보면 데이터를 더 모으는 것이 도움이 될지 판단할 수 있다.
검증 데이터에도 맞춰질 수 있다
validation set 으로 hyperparameter 조합을 수십, 수백 번 비교하면, 그 validation set 에 우연히 잘 맞는 설정이 뽑힐 수 있다. 모델 파라미터가 학습 데이터에 overfitting 하는 것과 같은 일이 모델 선택 단계에서 일어나는 것이다. 이렇게 고른 모델은 validation set 에서 잰 성능이 실제 성능보다 좋게 나온다. test set 을 선택에 쓰지 않고 마지막에 한 번만 보는 이유가 이것이다.
검증 데이터의 정보가 학습에 새어 들어가는 경우(data leakage)에는 overfitting 이 아예 보이지 않게 된다. 같은 사용자나 중복된 샘플이 학습과 검증 양쪽에 들어가 있거나, 시계열 데이터를 시간 순서와 상관없이 무작위로 나눠서 미래 데이터로 학습한 경우가 대표적이다. 이때는 검증 오차가 낮게 나와도 배포 후 성능은 떨어진다.
왜 생기는가
모델의 자유도가 데이터에 비해 클 때
모델이 표현할 수 있는 함수가 얼마나 다양한지를 capacity 라고 한다. 9 차 다항식은 높은 차수의 계수를 0 으로 두면 3 차 다항식이 되므로, 3 차가 표현하는 함수를 모두 표현하고 그보다 더 많이 표현한다. capacity 가 데이터에 담긴 정보에 비해 크면, 모델은 실제 관계를 맞추고 남은 자유도로 잡음을 맞춘다.
이런 상황은 다음과 같은 경우에 생긴다.
- 모델이 데이터 양에 비해 크다. 파라미터 수, 트리 깊이, 다항식 차수가 데이터 수에 비해 많은 경우다.
- 데이터가 적거나 잡음이 많다. 라벨이 잘못 붙은 샘플이 많으면 그만큼 외울 잡음이 많다.
- feature 수가 샘플 수에 비해 많다. feature 가 많으면 그중 몇 개는 순전히 우연으로 target 과 상관이 있어 보인다. 모델은 그 우연한 상관을 실제 관계와 구분하지 못한다 (curse of dimensionality).
- 너무 오래 학습한다. 신경망은 epoch 이 늘어날수록 학습 데이터의 세부 사항까지 맞춘다.
학습 데이터가 바뀌면 예측이 크게 흔들린다
overfitting 한 모델은 학습 데이터를 조금만 바꿔도 예측이 크게 달라진다. 잡음은 표본마다 다르게 뽑히고, 모델이 그 잡음을 따라가기 때문이다.
앞 예제에서 학습 데이터를 1,000 번 새로 뽑아 각각 다항식을 맞춘 뒤, 에서의 예측값을 모아 보았다. 이 위치의 참값은 이다.
| 다항식 차수 | 예측값의 평균 | 예측값의 표준편차 |
|---|---|---|
| 1 | -0.61 | 0.16 |
| 3 | -0.40 | 0.19 |
| 9 | -0.30 | 1.99 |
9 차 다항식의 예측은 평균으로 보면 참값과 거의 같다. 하지만 표준편차가 1.99 라서, 한 번 학습한 모델의 예측은 참값에서 2 가까이 벗어나기 일쑤다. 1 차 직선은 반대다. 어떤 표본으로 학습해도 비슷한 값을 내놓지만, 그 값의 평균이 참값에서 0.3 만큼 벗어나 있다.
예측값들의 평균이 참값에서 벗어난 정도를 bias, 예측값들이 그 평균 주위로 흩어진 정도를 variance 라고 한다. 새 데이터에서의 기대 제곱 오차는 bias 의 제곱, variance, 잡음의 분산을 더한 값으로 나뉜다 (Bias-variance tradeoff).
| 기호 | 뜻 |
|---|---|
| 참 함수. 이 예제에서는 | |
| 에서 관측한 값. 에 잡음이 더해진 것 | |
| 학습 데이터 10 개. 새로 뽑을 때마다 달라진다 | |
| 로 맞춘 다항식의 에서의 예측 | |
| 학습 데이터를 새로 뽑아 가며 낸 평균. 위 표에서는 1,000 번의 평균으로 대신했다 | |
| 잡음의 분산. 이 예제에서는 |
위 표로 에서 계산하면, 9 차 다항식은 bias² 가 이고 variance 가 이다. 1 차 직선은 bias² 가 이고 variance 가 이다. underfitting 은 bias 가 큰 상태이고, overfitting 은 variance 가 큰 상태다.
완화하는 방법
아래 방법은 모두 모델이 잡음까지 맞출 여유를 줄인다. 데이터를 늘리거나, 모델이 표현할 수 있는 범위를 줄이거나, 학습 과정을 방해하거나, 여러 모델의 흔들림을 평균으로 지운다.
각 방법에는 강도를 정하는 값이 있다. 강도가 너무 세면 실제 관계까지 맞추지 못해 underfitting 이 되므로, 이 값은 검증 오차를 보고 정한다.
데이터를 늘린다
가장 확실한 방법이다. 앞의 학습 점 수에 따른 표에서 본 것처럼, 같은 모델이라도 데이터가 많아지면 잡음을 외울 여유가 사라진다. 다만 데이터를 모으고 라벨을 붙이는 데 비용이 든다.
Data Augmentation 은 기존 샘플을 라벨이 바뀌지 않는 방식으로 변형해 학습 샘플을 만든다. 고양이 사진을 좌우로 뒤집거나 일부를 잘라내도 여전히 고양이 사진이다. 모델은 이런 변형과 무관한 특징을 쓰도록 유도된다. 완전히 새로운 정보를 주는 것은 아니어서 실제 데이터를 그만큼 더 모은 것보다는 효과가 작다.
모델이 표현할 수 있는 범위를 줄인다
- 층이나 unit 수를 줄이거나 다항식 차수를 낮춰 모델 자체를 작게 만든다.
- feature selection 으로 target 과 관계없는 feature 를 뺀다.
- Decision Tree 는 최대 깊이나 잎 노드의 최소 샘플 수를 제한하고, 다 키운 뒤 기여가 작은 가지를 잘라낸다.
큰 가중치에 벌점을 준다
학습은 어떤 값 하나를 정해 두고, 그 값이 가장 작아지도록 가중치를 고치는 과정이다. 이 값을 목적 함수 라고 하고 보통 로 쓴다. regularization 이 없으면 는 학습 데이터에서의 평균 loss, 즉 예측이 정답에서 벗어난 정도의 평균이다.
regularization 은 이 에 가중치 크기에 대한 벌점 항을 더한다. 그러면 학습은 loss 와 벌점의 합을 줄여야 하므로, loss 를 조금 줄이려고 가중치를 크게 키우는 쪽을 택하기 어려워진다.
| 기호 | 뜻 |
|---|---|
| 모델의 가중치(파라미터) | |
| 가중치가 인 모델이 번째 입력 에 내놓는 예측 | |
| 번째 샘플의 정답 | |
| 예측과 정답의 차이를 재는 loss 함수 | |
| 학습 샘플 수 | |
| 가중치 크기에 대한 벌점. L2 는 , L1 은 | |
| 벌점의 강도. 0 이면 regularization 이 없다 |
L2 벌점을 쓴 선형 회귀가 ridge regression 이고, 신경망에서는 같은 벌점을 weight decay 라고 부른다. L1 벌점을 쓴 선형 회귀는 lasso regression 으로, 일부 계수를 정확히 0 으로 만들어 feature selection 효과도 낸다.
큰 가중치에 벌점을 주는 것이 왜 overfitting 을 줄이는지, 앞 예제의 9 차 다항식으로 따라가 본다.
점을 모두 지나려면 계수가 커진다
학습 점에는 잡음이 섞여 있어서 위아래로 들쭉날쭉하다. 곡선이 이 점들을 하나도 빠짐없이 지나려면 점과 점 사이에서 급하게 꺾여야 한다. 다항식이 0–1 구간 안에서 급하게 꺾이려면, 차수가 높은 항들이 아주 큰 계수를 가지면서 부호가 번갈아 바뀌어 서로를 거의 지워야 한다.
맨 위 그림의 9 차 다항식이 실제로 그렇다. 계수를 반올림해 적으면 다음과 같다.
에서 각 항의 값을 계산해 보면, 항은 약 , 항은 약 , 항은 약 이다. 수십만 단위의 값들이 더해지고 빠지면서 거의 다 지워지고, 남은 합이 그림에서 곡선이 푹 꺼졌던 다.
이렇게 큰 값끼리 상쇄해서 만든 곡선은 계수가 조금만 달라져도 상쇄가 깨져 크게 움직인다. 학습 데이터의 잡음이 조금만 바뀌어도 곡선 모양이 크게 바뀌는 것, 즉 앞에서 본 높은 variance 가 여기서 나온다.
이 그림 한 장만 우연히 그런 것도 아니다. 학습 데이터를 1,000 번 새로 뽑아 맞출 때마다 상수항을 뺀 계수 9 개 중 절댓값이 가장 큰 것을 기록하면, 그 값들의 중앙값이 약 44 만이다.
벌점이 붙으면 점을 모두 지나는 다항식의 목적 함수 값이 커진다
계수 10 개의 값을 정하면 9 차 다항식이 하나 정해진다. 그러니 학습은 계수 값을 바꿔 가며 만들 수 있는 수많은 후보 다항식 가운데, 목적 함수 의 값이 가장 작은 하나를 고르는 일이다. 를 어떻게 정의하느냐에 따라 뽑히는 다항식이 달라진다.
벌점이 없으면 는 학습 오차(loss)뿐이다. 학습 오차가 가장 작은 다항식은 점을 모두 지나 학습 오차가 0 인 다항식, 즉 맨 위 그림의 출렁이는 곡선이다. 그래서 이 곡선이 뽑힌다.
L2 벌점을 더하면 가 아래와 같이 바뀐다. 앞의 일반식을 이 예제에 맞춰 쓴 것이다.
| 기호 | 뜻 |
|---|---|
| 학습할 9 차 다항식. 는 계수 를 묶어 부른 것 | |
| 번째 학습 점 | |
| 첫째 항 | loss 항. 학습 오차를 오차 제곱의 합으로 잰 값 |
| 둘째 항 | 벌점 항. 계수 제곱의 합에 를 곱한 값 |
일반식에서는 loss 를 평균으로 썼는데 여기서는 합으로 썼다. 이 차이는 의 크기를 10 배 바꾸는 것과 같아서 결론에는 영향이 없다. 상수항 는 벌점에서 뺐다. 상수항은 곡선 전체를 위아래로 옮길 뿐 곡선을 꺾지 않기 때문이다.
로 두고, 그림과 같은 학습 점 10 개에서 두 후보 다항식의 값을 계산하면 다음과 같다.
| 후보 다항식 | loss 항 | 벌점 항 | (두 항의 합) |
|---|---|---|---|
| 점을 모두 지나는 다항식 (위의 계수) | 0 | 약 2,100 만 | 약 2,100 만 |
| 가 가장 작아지도록 다시 맞춘 다항식 | 0.51 | 0.06 | 0.57 |
첫 번째 후보는 loss 항이 0 이라서, 벌점이 없을 때는 가 가장 작은 후보였다. 하지만 계수가 수십만이라 벌점 항이 약 2,100 만이 되고, 도 약 2,100 만으로 커진다.
두 번째 후보는 점을 정확히 지나지 않아서 loss 항이 0.51 남는다. 대신 계수가 모두 18 이하라서 벌점 항은 0.06 뿐이다. 가 0.57 로 훨씬 작으므로 학습은 이 다항식을 고른다.
결국 학습 오차 0.51 을 남기는 대신 곡선이 완만해졌다. 남은 0.51 은 잡음 수준보다 작다. 점 10 개에 섞인 잡음의 제곱합은 평균적으로 이기 때문이다. 실제 관계는 거의 다 맞추고, 잡음만 덜 따라간 셈이다.
벌점의 강도에 따른 결과
를 바꿔 가며, 학습 데이터를 새로 뽑는 실험을 마다 1,000 번씩 반복했다. 마지막 열은 매번 기록한 가장 큰 계수 절댓값의 중앙값이다.
| 학습 RMSE | test RMSE | 가장 큰 계수 절댓값 (중앙값) | |
|---|---|---|---|
| 0 | 0.00 | 0.73 | 약 440,000 |
| 0.16 | 0.38 | 72 | |
| 0.19 | 0.36 | 16.5 | |
| 0.34 | 0.42 | 3.8 | |
| 1 | 0.55 | 0.60 | 0.5 |
를 조금만 줘도 test RMSE 가 0.73 에서 0.38 로 내려가고, 에서는 3 차 다항식과 같은 0.36 이 된다. 차수를 낮추지 않고 계수 크기만 눌러서 같은 효과를 얻은 것이다. 를 더 키우면 학습 RMSE 까지 올라가며 underfitting 쪽으로 넘어간다.
학습 과정에 무작위성을 넣는다
dropout 은 학습 중 매 step 마다 무작위로 고른 일부 unit 의 출력을 0 으로 만든다. 특정 unit 들의 조합에만 기대는 표현을 만들기 어려워지므로, 학습 데이터의 세부 사항을 정밀하게 외우기 어렵다. 추론할 때는 dropout 을 끄고 모든 unit 을 쓴다.
검증 오차가 오르기 전에 멈춘다
Early Stopping 은 epoch 마다 검증 loss 를 확인하다가, 정해 둔 횟수 동안 개선이 없으면 학습을 멈추고 검증 loss 가 가장 낮았던 시점의 가중치를 쓴다. 앞의 epoch 에 따른 학습 곡선에서 검증 loss 가 다시 오르기 시작하는 지점을 자동으로 찾는 셈이다.
여러 모델의 예측을 평균한다
bagging 은 학습 데이터에서 복원추출로 여러 표본을 만들고, 표본마다 모델을 따로 학습한 뒤 예측을 평균한다. 각 모델이 잡음에 반응해 흔들리는 방향은 표본마다 다르므로, 평균을 내면 그 흔들림이 상당 부분 상쇄된다. 앞에서 본 variance 를 직접 줄이는 방법이다. 다만 표본이 모두 같은 학습 데이터에서 나오므로 모델끼리 닮아 있고, 그 공통된 흔들림은 평균해도 남는다 (bagging 노트의 깊은 decision tree 예제에서는 나무 100 개를 평균해도 variance 가 절반으로만 줄었다). 반면 bias 는 개별 모델의 bias 와 거의 같게 남는다. random forest 는 깊은 decision tree 여러 개를 이렇게 묶되, 나무끼리 덜 비슷해지도록 분할마다 쓸 feature 도 무작위로 고른다.
파라미터가 데이터보다 많아도 일반화하는 경우
지금까지의 설명대로라면 capacity 가 커질수록 test 오차는 U 자를 그린다. 처음에는 underfitting 이 풀리며 내려가고, 어느 지점부터는 overfitting 때문에 올라간다. 앞 예제도 그랬다.
이 설명을 그대로 따르면, 파라미터가 학습 샘플보다 많은 모델은 overfitting 할 수밖에 없어 보인다. 9 차 다항식이 계수 10 개로 점 10 개를 그대로 외웠듯이, 파라미터가 충분히 많으면 학습 데이터를 통째로 외울 수 있기 때문이다. 그런데 지금 쓰는 신경망은 대부분 파라미터 수가 학습 샘플 수보다 훨씬 많은데도 새 데이터에서 잘 맞힌다.
무작위 라벨도 외우는 모델이 진짜 라벨로는 일반화한다
Zhang et al. (2017) 은 이 모순을 실험으로 드러냈다.
실험에 쓴 CIFAR-10 은 32×32 크기의 컬러 이미지를 비행기, 자동차, 고양이 같은 10 개 클래스로 분류하는 데이터셋이다. 학습 이미지는 50,000 장이다. 모델은 파라미터가 약 165 만 개인 작은 Inception 구조의 CNN 으로, 파라미터 수가 학습 이미지 수의 30 배가 넘는다.
같은 모델을 두 가지 데이터로 각각 학습했다.
- 진짜 라벨. 고양이 사진에 “고양이” 라벨이 붙어 있는 원래 데이터다.
- 무작위 라벨. 이미지는 그대로 두고, 이미지마다 10 개 클래스 중 하나를 무작위로 골라 라벨을 새로 붙인 데이터다. 고양이 사진에 “트럭” 이 붙어 있을 수도 있다. 이미지와 라벨 사이에 아무 관계가 없으므로 배울 규칙이 없다. 학습 정확도를 올리는 방법은 이미지 50,000 장의 라벨을 한 장씩 외우는 것뿐이다.
결과는 다음과 같다 (논문 Table 1). 두 경우 모두 data augmentation 이나 weight decay 같은 regularization 은 쓰지 않았고, test 정확도는 학습에 쓰지 않은 이미지 10,000 장에서 쟀다.
| 학습 데이터 | 학습 정확도 | test 정확도 |
|---|---|---|
| 진짜 라벨 | 100% | 85.75% |
| 무작위 라벨 | 100% | 9.78% |
무작위 라벨에서도 학습 정확도가 100% 다. 이 모델은 아무 규칙 없이 붙은 라벨 50,000 개를 전부 외울 만큼 capacity 가 크다. 외운 내용은 새 이미지에 아무 쓸모가 없으므로, test 정확도는 10 개 중 하나를 찍는 수준인 10% 근처로 나온다. 논문은 무작위 라벨을 외우는 데 걸린 학습 시간도 진짜 라벨일 때보다 작은 상수배만큼만 길었다고 보고했다. 외우는 것이 이 모델에게 어려운 일이 아니라는 뜻이다.
고전적인 설명과 어긋나는 것은 진짜 라벨의 결과다. 같은 모델, 같은 학습 방법인데 test 정확도가 85.75% 다. 이 모델은 진짜 라벨도 한 장씩 외워서 학습 정확도 100% 를 만들 수 있었다. 그런데 실제로는 새 이미지에도 통하는 규칙을 배웠다.
여기서 따라오는 결론은, 모델이 무엇이든 외울 수 있는지(capacity)만 보고는 overfitting 여부를 예측할 수 없다는 것이다. 같은 모델이 데이터에 따라 외우기도 하고 일반화하기도 한다. 학습 데이터를 100% 맞추는 가중치 조합은 여러 개가 있을 수 있고, 학습이 그중 어느 조합에 도달하느냐가 결과를 가른다.
regularization 의 역할도 다시 보게 된다. 같은 모델에 data augmentation 과 weight decay 를 더하면 test 정확도가 85.75% 에서 89.05% 로 오른다. 도움은 되지만, regularization 없이도 이미 85.75% 였다. 논문은 이를 근거로 regularization 이 일반화를 개선할 수는 있어도 일반화의 주된 원인은 아니라고 해석했다.
모델을 더 키우면 test 오차가 다시 내려간다
고전적인 U 자 곡선은 모델이 학습 데이터를 정확히 맞추게 되는 크기 근처까지만 그린 그림이다. Belkin et al. (2019) 와 Nakkiran et al. (2020) 는 그 너머까지 모델을 계속 키우면서 test 오차를 쟀다. test 오차는 오르다가 한 지점에서 가장 높아진 뒤 다시 내려갔다. 오차가 두 번 내려간다고 해서 이를 double descent 라고 한다.
앞의 다항식 예제를 9 차 너머로 이어 가면 이 모양을 직접 볼 수 있다.
다항식 예제로 재현하기
학습 점 10 개는 그대로 두고 다항식 차수만 계속 올린다. 9 차까지와 10 차 이상은 사정이 다르다.
- 9 차 이하. 계수가 10 개 이하라서, 학습 오차를 가장 작게 만드는 다항식이 하나로 정해진다. 9 차에서는 그 다항식이 점 10 개를 정확히 지난다.
- 10 차 이상. 계수가 11 개 이상이라서, 점 10 개를 정확히 지나는 다항식이 무수히 많다. 그중 하나를 고르는 규칙이 필요하다. 여기서는 계수 제곱의 합이 가장 작은 것을 골랐다. 선형 모델을 계수 0 에서 출발해 경사하강법으로 학습하면 정확히 이 다항식에 도달한다는 것이 알려져 있다. 즉 학습 알고리즘이 실제로 고르는 다항식과 같다.
한 가지를 바꿨다. 를 그대로 쓰면 차수가 높은 항끼리 0–1 구간에서 모양이 거의 같아져서, 계수가 가장 작은 다항식을 계산으로 안정적으로 찾지 못한다. 그래서 같은 다항식을 Legendre 다항식들의 합으로 바꿔 적었다. Legendre 다항식은 구간 위에서 서로 직교하도록(두 개를 곱해 구간 전체로 적분하면 0 이 되도록) 만든 다항식 묶음이라, 차수가 높아져도 서로 모양이 겹치지 않는다. 표현 방식만 바꾼 것이라 9 차 이하에서는 맞춘 곡선이 앞 절과 똑같다.
학습 데이터를 1,000 번 새로 뽑아 반복한 평균이다.
| 다항식 차수 | 계수 수 | 학습 RMSE | test RMSE |
|---|---|---|---|
| 3 | 4 | 0.24 | 0.36 |
| 7 | 8 | 0.12 | 0.41 |
| 8 | 9 | 0.08 | 0.47 |
| 9 | 10 | 0.00 | 0.73 |
| 10 | 11 | 0.00 | 0.70 |
| 11 | 12 | 0.00 | 0.44 |
| 15 | 16 | 0.00 | 0.41 |
| 50 | 51 | 0.00 | 0.41 |
| 200 | 201 | 0.00 | 0.43 |
표를 위에서부터 읽으면 세 구간으로 나뉜다.
- 3 차에서 9 차까지 test 오차가 0.36 에서 0.73 으로 오른다. 고전적인 U 자의 오른쪽 절반이다.
- 9 차에서 test 오차가 가장 높다. 계수 수와 점의 수가 같아서, 모델이 학습 데이터를 겨우 정확히 맞출 수 있게 되는 크기다. 이 크기를 interpolation threshold 라고 한다. 점 10 개를 정확히 지나는 9 차 다항식은 딱 하나뿐이므로, 그 다항식이 아무리 크게 출렁여도 모델은 그것을 받아들일 수밖에 없다.
- 10 차를 넘으면 test 오차가 다시 내려간다. 학습 오차는 계속 0 인데 test 오차는 0.44, 0.41 로 떨어진다. 점을 정확히 지나는 다항식이 많아지면서, 그중에 계수가 작고 완만한 것을 고를 여지가 생겼기 때문이다. 앞의 regularization 실험에서 본 것처럼 계수가 작은 다항식은 덜 출렁인다. 200 차처럼 계수가 점보다 20 배 많아도 test 오차는 0.43 에 머문다.
이 예제에서는 두 번째 하강이 3 차의 0.36 까지 내려오지는 않았다. double descent 는 경계를 넘으면 오차가 다시 내려간다는 현상이지, 큰 모델이 늘 작은 모델보다 낫다는 뜻은 아니다. 다만 두 논문은 큰 신경망에서 두 번째 하강이 첫 번째 최저점보다 더 낮게 내려가는 경우를 보고했다.
데이터를 늘렸는데 오히려 나빠지는 경우
interpolation threshold 는 “계수 수 = 점의 수” 인 지점이다. 그래서 모델을 키우지 않고 데이터만 늘려도 이 경계에 도달할 수 있다.
14 차 다항식(계수 15 개)을 고정하고 학습 점의 수만 바꿔 보면 다음과 같다. 나머지 조건은 앞 표와 같다.
| 학습 점의 수 | 학습 RMSE | test RMSE |
|---|---|---|
| 10 | 0.00 | 0.42 |
| 12 | 0.00 | 0.46 |
| 15 | 0.00 | 6.56 |
| 18 | 0.11 | 0.91 |
| 25 | 0.19 | 0.41 |
| 40 | 0.24 | 0.36 |
점을 10 개에서 15 개로 늘렸더니 test 오차가 0.42 에서 6.56 으로 폭등했다. 점이 15 개가 되면 계수 수와 같아져서, 모델이 경계 위에 올라서기 때문이다. 점을 더 늘려 경계를 지나가면 다시 내려가서, 40 개에서는 0.36 이 된다.
Nakkiran et al. 은 신경망에서도 같은 일을 관찰했다. 데이터를 늘리면 경계에 해당하는 모델 크기도 커지므로, 경계 근처 크기의 모델은 데이터를 늘렸을 때 test 오차가 오히려 오를 수 있다. 같은 논문은 학습 epoch 수를 늘려 갈 때도 test 오차가 오르다 다시 내려가는 모양이 나타난다고 보고했다.
실무에서 overfitting 을 판단하는 기준
큰 신경망에서 이런 일이 왜 생기는지는 아직 완전히 설명되지 않았다. 실무에서 따라오는 결론은 판단 기준을 바꾸지 않는 것이다. 파라미터가 많다는 이유만으로 overfitting 이라고 단정하지 않고, 반대로 큰 모델이니 overfitting 걱정이 없다고 보지도 않는다. 어느 쪽이든 학습 오차와 검증 오차를 함께 보고 판단한다. 큰 신경망에서도 weight decay, data augmentation, early stopping 은 여전히 기본으로 쓴다.
References
- Christopher M. Bishop, Pattern Recognition and Machine Learning, Springer, 2006. 1.1 절 Example: Polynomial Curve Fitting.
- Ian Goodfellow, Yoshua Bengio, Aaron Courville, Deep Learning, MIT Press, 2016. 5.2 절 Capacity, Overfitting and Underfitting, 7 장 Regularization for Deep Learning.
- Chiyuan Zhang, Samy Bengio, Moritz Hardt, Benjamin Recht, Oriol Vinyals, “Understanding deep learning requires rethinking generalization”, ICLR 2017.
- Mikhail Belkin, Daniel Hsu, Siyuan Ma, Soumik Mandal, “Reconciling modern machine-learning practice and the classical bias–variance trade-off”, PNAS 2019.
- Preetum Nakkiran, Gal Kaplun, Yamini Bansal, Tristan Yang, Boaz Barak, Ilya Sutskever, “Deep Double Descent: Where Bigger Models and More Data Hurt”, ICLR 2020.