보상을 이용해 행동 확률을 바꾸기
REINFORCE는 직접 시도한 행동과 그 보상을 이용해, 기대 보상이 커지는 방향으로 행동 확률을 조정하는 방법 이다.
행동을 고르는 확률 분포를 policy라고 하고, 그 분포의 parameter를 gradient로 학습하는 계열을 policy gradient라고 한다.
REINFORCE는 실제로 뽑은 샘플로 gradient를 추정하는 대표적인 방법이다. Williams, 1992
고객 문의를 ‘환불 담당’과 ‘일반 담당’ 중 어디로 보낼지 고르는 가상 문제를 생각해 보자. 모델이 [0.6, 0.4]를 출력했다면, 학습 중에는 이 확률로 담당 부서를 뽑아 처리 결과를 관찰한다.
처리가 잘됐는지는 외부 시스템에서 점수로 받아도 된다. 그 점수를 계산하는 과정 전체가 미분 가능할 필요는 없다. 모델은 자신이 고른 행동의 확률을 미분할 수 있으면 된다.
액션에 따른 업데이트
REINFORCE의 기본 업데이트는 다음과 같다.
| 기호 | 의미 |
|---|---|
| 문의 내용 등 모델에 주어진 입력 | |
| policy에서 뽑은 행동 | |
| policy를 만드는 모델 parameter | |
| 입력 에서 행동 를 뽑을 확률 | |
| 뽑은 행동으로 얻은 보상 | |
| 양수 learning rate | |
| parameter에 대한 미분 |
로그 확률의 gradient는 방금 뽑은 행동의 확률을 높이는 방향을 가리킨다. 보상이 양수이면 그 방향으로, 음수이면 반대로 움직인다. 다만 이것은 샘플 하나가 주는 방향이다. 다른 샘플과 공유 parameter의 영향까지 합친 최종 업데이트가 모든 행동 확률을 같은 방식으로 바꾸지는 않는다.
숫자로 보면 더 분명하다. 환불 담당을 선택할 확률을 sigmoid 출력 으로 두자. 는 학습할 logit이고, 환불 담당을 실제로 뽑았다고 하자.
보상이 2, learning rate가 0.1이면 logit 변화는 이다. 원래 logit은 이므로 새 확률은 이다. 확률에 보상 2를 더하는 것이 아니라, logit을 조금 바꿔 같은 선택이 더 잘 나오게 한다.
| 기호 | 의미 |
|---|---|
| logit을 0–1 확률로 바꾸는 sigmoid 함수 | |
| 환불 담당 선택 확률 | |
| 그 확률을 결정하는 단일 logit |
실제 신경망에서는 logit을 만드는 여러 parameter까지 chain rule로 업데이트한다.
보상의 미분 없이 gradient를 얻는 이유
기대 보상은 가능한 행동의 보상을 그 행동을 고를 확률로 가중 평균한 값이다. 아래 유도는 입력 를 고정하고, 보상 함수가 에 직접 의존하지 않는 한 번짜리 선택 문제를 가정한다.
| 기호 | 의미 |
|---|---|
| 최대화하려는 기대 보상 | |
| 입력과 행동으로 정해지는 보상. 보상이 확률적이면 그 조건부 평균 | |
| 현재 policy로 행동을 뽑았을 때의 평균 | |
| 가능한 모든 행동에 대한 합 |
핵심 변형은 다. 이를 log-derivative trick이라고 한다. 마지막 식이 평균 형태이므로, 모든 행동의 보상을 알지 못해도 뽑은 행동과 관측 보상들을 모아 추정할 수 있다. 이때 미분하는 것은 보상이 아니라 샘플을 만들어 낸 확률 이다. Policy gradient 유도
같은 모델에서도 뽑히는 행동과 관측 보상은 매번 달라진다. 따라서 샘플로 추정한 gradient도 흔들린다. 이것이 REINFORCE에서 말하는 높은 분산의 원인이고, 다음의 baseline은 그 흔들림을 줄이기 위한 장치다.
Baseline은 보상을 비교할 기준
어떤 문의는 어느 부서로 보내도 쉽게 처리되고, 다른 문의는 어느 쪽이 맡아도 어렵다. 절대 점수만 쓰면 쉬운 문의에서 얻은 점수가 업데이트를 크게 좌우할 수 있다. 입력별 기준점인 baseline을 빼면 ‘이 조건에서 평소보다 얼마나 잘했는가’를 반영할 수 있다.
| 기호 | 의미 |
|---|---|
| 입력 에서 보상을 비교할 기준값 | |
| 관측 보상에서 기준을 뺀 가중치. 기대 보상을 baseline으로 쓰면 advantage의 샘플 추정값 |
앞의 보상 2를 얻었더라도 baseline이 3이면 가중치는 -1이다. 같은 단일 logit 예제에서는 변화가 이고, 선택 확률은 약 0.5904로 내려간다. 양의 보상을 받았더라도 기준보다 못하면 그 선택을 줄일 수 있다. Advantage는 이처럼 상태의 평균적인 가치와 행동의 가치를 비교하는 개념이다.
입력을 고정했을 때 baseline이 뽑힌 행동에 의존하지 않으면, baseline 항의 기대 gradient는 0이다.
따라서 적절한 baseline은 원래 기대 gradient를 유지하면서 분산을 줄일 수 있다. 아무 기준값이나 쓰면 분산이 줄어드는 것은 아니다. 보상을 예측하는 별도 모델을 baseline으로 쓰더라도, policy 업데이트에서는 그 값을 고정해 취급한다. Baseline의 조건
그룹 평균을 baseline으로 쓰는 경우
같은 입력에서 여러 번 샘플링하고 보상을 비교할 수도 있다. 예를 들어 세 번 얻은 보상이 [2, 0, 1]이면 그룹 평균은 1이고, 가중치는 [1, -1, 0]이다. 첫 샘플은 강화하고, 두 번째는 줄이며, 세 번째는 이 항에서 업데이트하지 않는다.
자기 보상까지 포함한 평균은 엄밀히는 자기 행동과 독립인 baseline이 아니다. 같은 입력에서 개의 행동을 독립적으로 뽑고, 각 보상이 자기 행동에만 의존하는 경우를 계산하면 다음과 같다.
| 기호 | 의미 |
|---|---|
| 같은 입력에서 뽑은 독립 샘플 수 | |
| 번째 행동과 그 보상 | |
| 자기 보상도 포함한 개 보상의 평균 |
이 식은 앞의 baseline 조건을 적용해 전개한 결과다. 자기 보상 항이 원래 gradient의 만큼을 빼므로, 기대 방향은 같지만 크기가 줄어든다. 자기 샘플을 제외한 나머지 보상의 평균을 쓰는 leave-one-out baseline은 이 조건에서 그 축소를 피한다. 샘플 간 상호작용으로 보상이 정해지거나 그룹 표준편차로 나누는 경우에는 위 식을 그대로 적용할 수 없다.
코드의 loss와 실제 학습 목표
Optimizer는 대개 loss를 최소화하므로, 기대 보상을 높이는 방향에 음수를 붙여 다음과 같이 구현한다. 아래는 독립적인 한 번짜리 선택들의 batch를 학습하는 최소 예시다. model은 선택지별 logit을 출력하고, score는 샘플별 보상을 반환하며, baseline은 현재 행동과 독립적인 기준값이라고 가정한다.
from torch.distributions import Categorical

dist = Categorical(logits=model(inputs))
actions = dist.sample()
rewards = score(inputs, actions)
weights = (rewards - baseline).detach()
loss = -(weights * dist.log_prob(actions)).mean()

optimizer.zero_grad()
loss.backward()
optimizer.step()detach()는 reward와 baseline을 이 업데이트에서 상수로 취급한다는 뜻이다. Gradient는 log_prob에서 모델로 흐른다. 보상에도 parameter가 직접 들어가는 별도 목적함수라면, 이 코드만으로 그 목적의 전체 gradient를 계산했다고 할 수 없다.
이 loss의 숫자는 보상 자체가 아니다. 동일 batch에서 loss만 계속 낮춘다고 실제 기대 보상이 좋아진다는 보장도 없다. 기본 REINFORCE는 현재 policy에서 새 샘플을 모아 업데이트하며, 오래된 샘플을 재사용하려면 추가 보정이 필요하다. 구현과 loss 해석
여러 행동 뒤에 보상을 받는 경우
대화나 게임에서는 행동 하나로 끝나지 않는다. 이때는 각 행동 이후에 얻은 보상을 합한 return을 사용한다. 에피소드의 끝까지 실제 결과를 관찰해 계산하므로 Monte Carlo 방식이라고 부른다.
유한한 에피소드에서 시작 시점의 할인 누적 보상을 최대화한다면 다음과 같이 쓸 수 있다.
| 기호 | 의미 |
|---|---|
| 현재 단계와 에피소드 종료 단계 | |
| 현재 상태, 선택한 행동, 그 다음에 받은 보상 | |
| 먼 미래의 보상을 줄여 반영하는 discount factor | |
| 현재 행동 이후 에피소드 끝까지의 할인 return | |
| 에피소드 하나에서 추정한 policy gradient |
할인하지 않으면 이므로 두 곳의 할인 계수가 사라진다. 한 번짜리 선택은 이 식에서 인 경우다. Value 예측으로 미래 return 일부를 대신하는 actor–critic과 달리, 기본 episodic REINFORCE는 끝까지 관찰한 return을 쓴다. Value 모델을 baseline으로 쓴다는 사실만으로 return까지 예측값으로 대체하는 것은 아니다.
교재의 유도와 알고리즘 표기
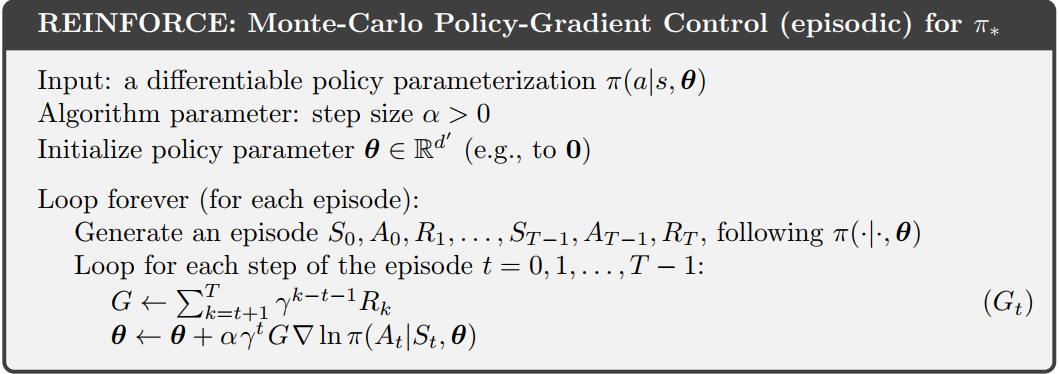
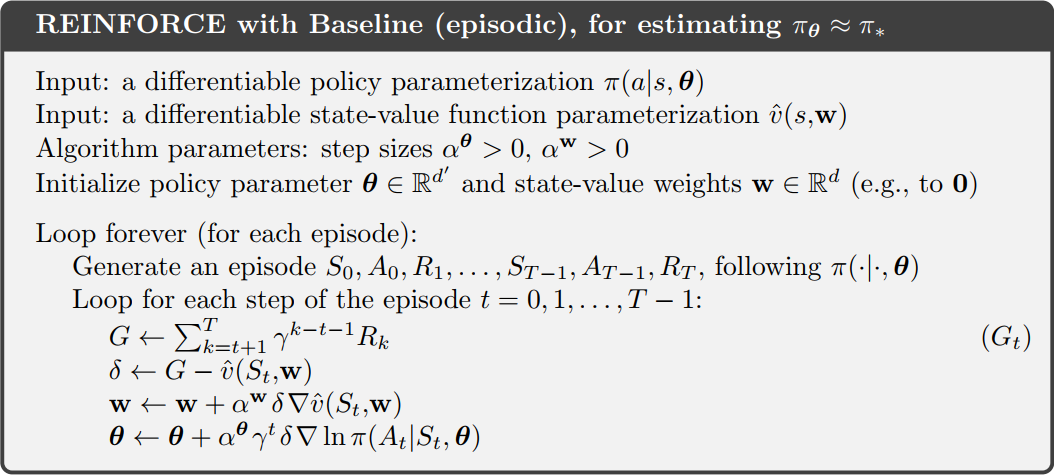
Sutton과 Barto 교재의 다음 그림은 전체 행동에 대한 평균을 실제 행동과 return의 샘플로 바꾸는 과정이다. 이어지는 두 알고리즘은 baseline이 없는 경우와 value 예측을 baseline으로 쓰는 경우를 보여준다.
그림의 표기 의미 에피소드에서 관측한 상태, 행동, 보상 해당 상태에서 행동한 뒤 policy를 따를 때의 기대 return parameter 로 예측하는 state value. Baseline 역할 실제 return과 baseline의 차이 policy와 value 모델의 learning rate 두 parameter 벡터의 차원 최적 policy 마지막 알고리즘은 value 예측을 관측 return 쪽으로 맞추고, policy는 그 return이 기준보다 높았는지에 따라 조정한다. 두 모델을 학습하더라도 policy에 쓰는 return은 에피소드 끝까지 관찰한 값이다.
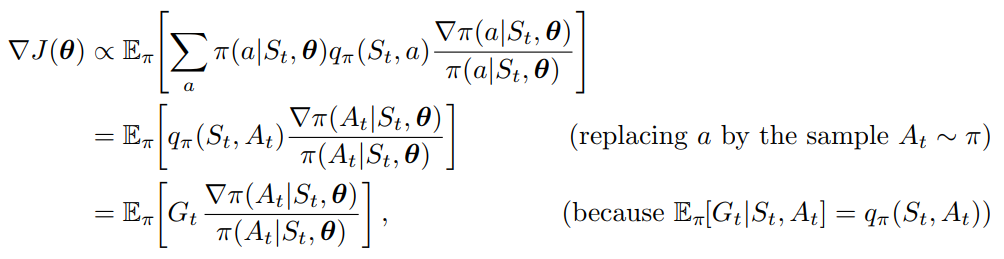
Brier loss·Jev 노트와 연결해서 읽기
Brier loss는 예측 확률이 실제 결과와 얼마나 다른지 정하는 평가 목표 다. REINFORCE는 샘플과 보상에서 업데이트 방향을 추정하는 방법 이다. 두 개념은 역할이 다르다.
정답 label과 전체 예측 확률이 있고 Brier loss를 직접 계산할 수 있다면, 그 loss를 바로 미분할 수 있다. REINFORCE로 같은 목표를 학습하려면 기대 보상이 그 목표와 대응하도록 샘플링과 보상을 설계해야 한다. 단순히 loss 이름을 reward로 바꾸는 것으로는 충분하지 않다.
Jev와 RLCD 노트의 Laya 예시는 선택지 label 하나 대신 noise를 더한 logit 벡터를 샘플로 취급 한다. 그 결과 만들어진 확률 분포를 채점하고, 좋은 점수를 얻은 logit 벡터가 더 잘 나오도록 업데이트한다. 이때 policy-gradient 항의 로그는 정답 선택지 확률의 로그가 아니라 해당 noisy logit을 샘플링한 분포의 log density 에 해당한다. 공개 notebook은 이 항과 cross-entropy를 함께 사용한다. Laya 학습 코드
NanoJev의 독립 실험은 선택지 label을 여러 번 뽑고, 정답 일치 보상과 샘플 간 일치 페널티를 조합해 기대 Brier 목표와 연결한다. 샘플들이 보상을 함께 결정하므로, 독립적인 개별 보상을 가정한 그룹 평균 예제를 그대로 대입해서는 안 된다. NanoJev의 목적함수와 조건
두 사례 모두 원본 Jev의 공개된 학습법은 아니다. REINFORCE의 원리를 이해하면 공개 구현이 무엇을 샘플링하고 어떻게 보상을 주는지 읽을 수 있지만, 미공개 모델의 학습 알고리즘까지 알 수 있는 것은 아니다.
References
- Ronald J. Williams. Simple statistical gradient-following algorithms for connectionist reinforcement learning, 1992.
- Sutton and Barto. Reinforcement Learning: An Introduction, 2nd edition, Chapter 13.3–13.4: REINFORCE와 baseline.
- OpenAI Spinning Up. Intro to Policy Optimization: log-probability gradient, baseline, 구현.