두 벡터가 서로 유사할수록, Cosine similarity 값은 커진다.
Vs. MSE
MSE 와 차이점은 두 벡터 크기를 이용해 유사도의 정도를 Normalization 할 수 있다는 점이다.
Cosine Similarity 의 범위
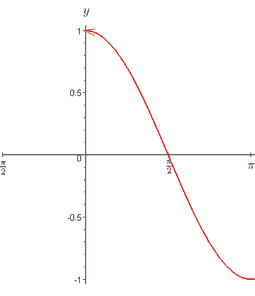
두 벡터가 서로 유사할수록, Cosine similarity 값은 커진다.
MSE 와 차이점은 두 벡터 크기를 이용해 유사도의 정도를 Normalization 할 수 있다는 점이다.
주어진 유저의 다양성을 수치적으로 측정하는 metric: GS-score 는 어떤 한 노래의 vector 와 사용자들의 vector 들 간 cosine similarity 의 평균을 측정한다. specialist 들에게는 이 평균이 높게 나올것이고, generalist 들에게는 이 평균이 낮게 나올것이다.
또한, embedding 들의 type 간, price range 간 평균 cosine similarity 를 계산한 결과, 동일한 type 그리고 price range 는 비교할만한 높은 유사도를 보였음
...고 이를 평점 예측 또는 Top-K ranking 에 활용하는 방법이다. Similarity 값을 계산하는 metric 은 여러 종류가 있으며, Jaccard Similarity, cosine similarity, Pearson Similarity 등이 활용된다. 유저 기반 Top-N 추천 알고리즘 유저 기반 Top-N 추천 알고리즘은 유사도 기반 벡터 모델을 사용하여, 특정 유저와 가장 ...
유사도를 최대로 하는 vector ew 를 찾는 것이다. Embedding vector 간 유사도를 계산할 때, 일반적으로 cosine similarity 를 사용한다.
MSE of the estimates
Normalization 은 데이터의 scale 을 맞추는 전처리를 넓게 부르는 말이다. 문맥에 따라 의미가 조금 달라서, 실제로 어떤 변환을 말하는지 확인해야 한다.
norm V 이란, 벡터 공간에 존재하는 벡터의 크기를 측정하기 위한 함수를 의미한다.
각 단어에 대한 n 차원 feature 를 만들고 적절한 값을 부여하는 방식을 의미한다.
estimation 과 실제 값의 차이의 제곱에 대한 합을 나타낸다.
우리가 예측 모형을 build 하는 이유는 불확실성을 제어하고자 하는 것이다.
dot product 를 활용한 증명
Related KL-Divergence Jensen–Shannon divergence 정의 f-divergence 종류 중 하나로, 두 확률 분포 P,Q 의 거리를 계산하기 위해 사용함 H^{2}(P,Q)=\frac{1}{2}\int(\sqrt{dP}-\sqrt{dQ})^{2} KL-Divergence 의 관계 Hellinger 거리가 d_{H}(p,q) 라고 한다면,...
스팸 탐지를 예로 들면, 스팸은 찾으려는 클래스인 positive이고 정상 메일은 negative다. 분류 모델은 보통 이 판정을 바로 출력하지 않는다. 먼저 각 클래스에 속할 확률이나 점수를 계산한다. 그다음 threshold(판정 기준값)를 적용해 positive와 negative를 나눈다. 예를 들어 스팸...
기계 학습 방식에서 scale invariant 란, feature 들을 rescaling 하는 경우에도 prediction 에 영향을 주지 않는 특성을 의미한다.