추천 영역의 후보 생성 모델 B 를 AB Test 로 2주 동안 시험했다. 그룹마다 31,300 명이 모였고, 판정 지표인 클릭률은 A 5.00%, B 5.27% 로 p-값 0.12 였다. 유의하지 않다.
아쉬운 마음에 결과를 이리저리 다시 보고 싶어진다. 세그먼트별로 쪼개 보거나, 실험 중간에 유의했던 날을 찾거나, 첫 며칠의 큰 상승을 근거로 삼고 싶어진다. 그렇게 하면 판정이 흐려진다. 두 그룹이 자원을 나눠 쓰는 경우까지 더하면 대표적인 함정은 넷이다.
한눈에 보기
- 검정을 여러 번 하면 우연한 유의가 늘어난다: 세그먼트 10 개를 검정하면 B 가 아무 효과 없어도 40% 확률로 어딘가 “유의” 가 나온다.
- 매일 보다가 유의한 날 멈추면 오판이 네 배 넘게 늘어난다: 같은 모델끼리 비교해도 약 22% 가 “차이 있음” 으로 끝난다.
- 초반 상승은 새로움 때문일 수 있다: 날짜별 차이가 계속 줄어들면 실험 평균은 장기 효과보다 크다.
- 두 그룹이 자원을 나눠 쓰면 실험 결과가 전체 적용 결과와 다르다: 영향이 퍼지는 범위를 한 덩어리로 묶어 배정한다.
지표와 세그먼트를 여러 개 검정할 때
클릭률 전체로는 유의하지 않았다. 그래서 신규/재방문, 기기, 연령대로 세그먼트 10 개를 만들어 하나씩 검정했더니 “20대 iOS 사용자” 에서 p-값 0.03 이 나왔다.
유의수준 0.05 는 검정 하나에서 우연히 유의가 나올 확률이다. 검정을 여러 번 하면 그중 하나라도 우연히 유의할 확률이 커진다.
- 검정 1 번: 5%
- 검정 5 번: 23%
- 검정 10 번: 40%
- 검정 20 번: 64%
그래서 세그먼트 하나의 “유의” 는 B 가 그 세그먼트에 효과가 있다는 증거가 못 된다.
- 세그먼트 10 개를 보면, B 가 A 와 완전히 같아도 열 번 중 네 번은 이런 세그먼트가 하나쯤 나온다.
- 세그먼트로 나눠 보는 것 자체는 결과를 이해하는 데 유용하다. 다만 거기서 승패를 정하지 않는다.
대책은 둘이다.
- 승패는 실험 전에 정한 판정 지표 하나로 가린다. 나머지 지표와 세그먼트는 다음 실험의 가설로 쓴다.
- 여러 검정에서 결론을 내야 하면 검정마다 기준을 낮춘다. 10 개를 보면 기준을 0.05 대신 0.005 로 둔다 (Bonferroni 보정). 그러면 위의 p-값 0.03 은 유의하지 않다.
매일 들여다보다 유의해진 날 멈출 때
p-값은 표본 크기를 미리 정하고 끝에서 한 번 계산한다는 전제로 만든 값이다. 매일 결과를 보다가 처음 p-값이 0.05 아래로 내려간 날 멈추면(peeking), 우연한 흔들림이 잠깐 기준을 넘은 순간을 결론으로 삼게 된다.
아래 그림은 두 그룹에 같은 모델을 보여 준 A/A 실험 하나에서, 매일 그때까지 쌓인 데이터로 계산한 p-값이다. 실제 클릭률은 둘 다 5% 다.
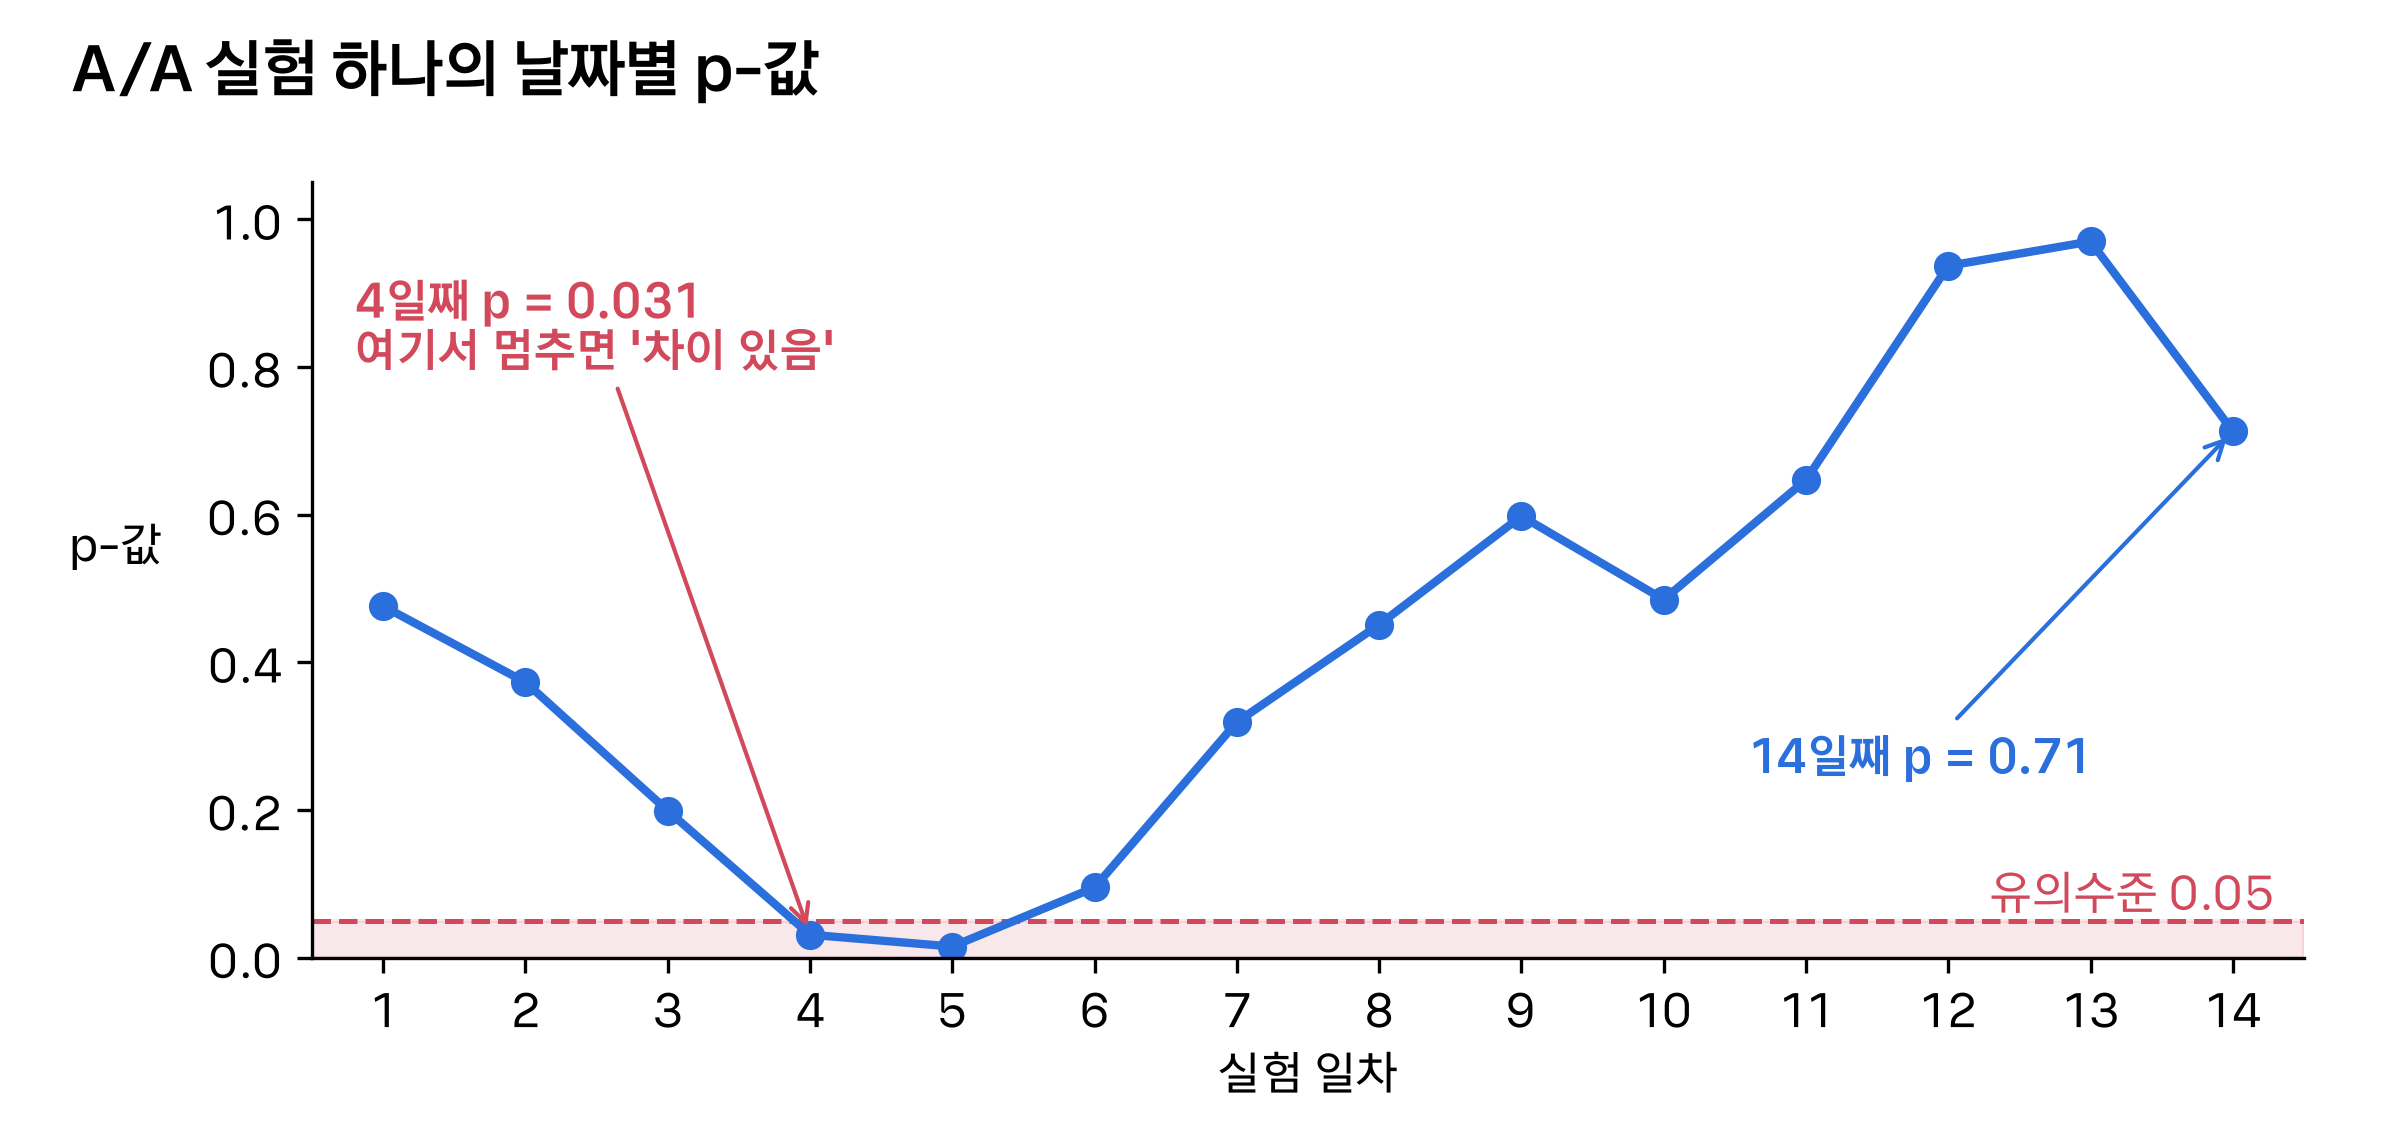
같은 모델끼리인데 4일째에 멈췄다면 “차이 있음” 으로 결론 냈을 것이다.
- 4–5일째 p-값이 0.05 아래로 내려갔다가 다시 올라와 14일째에는 0.71 이다.
- 실험 초반에는 표본이 적어 차이가 크게 흔들리므로 이런 순간이 자주 생긴다.
얼마나 자주인지 같은 A/A 실험을 2만 번 시뮬레이션했다.
- 14일째에 한 번만 판정하면: 5.0% 가 “유의” 로 나온다. 유의수준과 같다.
- 매일 보다가 유의한 날 멈추면: 약 22% 가 “유의” 로 나온다. 같은 모델끼리 다섯 번에 한 번 이상 차이가 있다고 판정하는 셈이다.
그래서 표본 크기와 기간을 실험 전에 정하고, 끝난 뒤에 판정한다.
- 장애나 큰 손실처럼 중간에 멈춰야 할 이유가 있으면, 여러 번 보는 것을 전제로 기준을 조정한 검정(sequential test)을 쓴다.
- 예를 들어 언제 멈춰도 오판 확률이 유의수준을 넘지 않게 만든 always-valid p-value 가 있다 (Johari et al., 2017).
새로움 효과로 초반 지표가 오를 때
추천 결과가 바뀌면 사용자는 낯선 아이템을 호기심에 클릭한다. 이 상승은 B 가 취향을 더 잘 맞춰서가 아니라 화면이 바뀌어서 생긴 것이라, 사용자가 익숙해지면 사라진다. 이를 새로움 효과(novelty effect)라 한다.
반대 경우도 있다. 익숙한 화면이 바뀌어 처음 며칠은 클릭률이 떨어졌다가, 사용자가 적응하면 회복된다. 이를 primacy effect 라 한다.
날짜별 B − A 차이를 그려 보면 둘을 구분할 수 있다.
- 예를 들어 첫 3일은 +1.0%p 였는데 둘째 주에는 +0.2%p 로 계속 줄어든다면 새로움 효과다. 2주 평균은 장기 효과보다 크게 나온 값이다.
- 반대로 처음에 마이너스였다가 점점 올라온다면 primacy effect 다. 2주 평균은 장기 효과보다 작게 나온 값이다.
- 차이가 처음부터 일정하면 오래 가는 효과로 본다.
실험 기간에 처음 들어온 사용자만 따로 보는 방법도 있다.
- 이들은 바뀌기 전 화면을 본 적이 없으므로, 새로움 효과도 primacy effect 도 생기지 않는다.
- 대신 기존 사용자와 성향이 달라 결론을 전체로 넓힐 때 조심해야 한다.
두 그룹이 자원을 나눠 쓸 때
AB Test 의 판정은 한 사용자의 결과가 그 사용자가 받은 모델에만 달려 있다고 가정한다. 두 그룹이 같은 자원을 나눠 쓰면 이 가정이 깨진다. B 가 내린 추천이 A 그룹의 결과까지 바꾼다(interference).
그러면 실험에서 본 B − A 차이는 B 를 전체 사용자에게 적용했을 때의 효과와 달라진다.
재고와 예산을 나눠 쓰면
- B 가 특정 상품을 많이 추천해 재고가 떨어지면, A 그룹 사용자는 그 상품을 살 수 없다. A 의 구매가 줄어 B 가 실제보다 좋아 보인다.
- 광고에서는 B 가 광고주 예산을 빨리 소진하면 A 그룹에 나갈 광고가 줄어든다.
사용자끼리 연결돼 있으면
- 공유, 팔로우, 댓글이 있는 서비스에서는 B 그룹 사용자의 행동이 친구인 A 그룹 사용자의 피드에 나타난다.
학습 데이터를 나눠 쓰면
- 두 모델을 실험 기간의 전체 로그로 다시 학습한다고 하자. 트래픽 대부분을 가진 A 가 만든 로그가 B 의 학습 데이터 대부분이 된다.
- B 를 전체에 적용했다면 B 가 노출한 아이템의 반응이 쌓였을 것이다. 실험 중의 B 는 실제로 적용됐을 때와 다른 데이터로 학습된다.
대책은 영향이 퍼지는 범위를 한 덩어리로 묶어 배정하는 것이다 (cluster randomization).
- 지역이나 시장 단위로 나누거나, 사용자 연결망을 덩어리로 잘라 덩어리째 배정한다.
- 광고처럼 예산을 공유하면 예산도 그룹별로 나눈다.
- 덩어리가 커지면 배정 단위의 수가 줄어든다. 그만큼 흔들림이 커지므로 표본 크기를 다시 계산한다.
부록: 식과 시뮬레이션 설정
여러 번 검정할 때 하나 이상 우연히 유의할 확률
서로 독립인 검정 개를 유의수준 로 하면, 효과가 전혀 없을 때 하나 이상 유의할 확률은 다음과 같다.
| 검정 수 | 하나 이상 우연히 유의할 확률 | Bonferroni 기준 |
|---|---|---|
| 1 | 5.0% | 0.05 |
| 5 | 22.6% | 0.01 |
| 10 | 40.1% | 0.005 |
| 20 | 64.2% | 0.0025 |
Bonferroni 보정은 검정마다 기준을 으로 낮춰, 하나 이상 우연히 유의할 확률을 이하로 묶는다.
peeking 시뮬레이션
- 두 그룹 모두 실제 클릭률이 5% 인 A/A 실험을 만든다. 그룹마다 하루 2,236 명씩 14일이면 약 31,300 명이다.
- 매일 그때까지 쌓인 데이터로 두 비율의 z-검정을 한다 (양측, ).
- 이 실험을 2만 번 반복해, 14일째에만 판정한 경우와 14일 중 하루라도 유의하면 그날 멈춘 경우의 “유의” 비율을 센다.
결과는 14일째에만 판정하면 4.9–5.0%, 매일 보면 21.7–22.1% 다 (난수 시드 세 개).
관련 노트
References
- Kohavi, Tang, Xu, Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing (Cambridge University Press, 2020)
- Johari, Pekelis, Walsh, Always Valid Inference: Bringing Sequential Analysis to A/B Testing (2015), KDD 2017 발표 “Peeking at A/B Tests”: https://arxiv.org/abs/1512.04922