A/B Test 는 두 로직을 같은 기간에 나눠 보여 주고 비교한다
A/B Test 는 사용자를 무작위로 두 그룹으로 나눠, 한 그룹에는 기존 로직(A, 대조군 control)을, 다른 그룹에는 새 로직(B, 실험군 treatment)을 같은 기간에 보여 준 뒤 지표를 비교하는 실험이다. 추천 시스템에서는 실제 사용자의 반응으로 모델을 평가하는 online evaluation 의 대표적인 방법이다. offline 지표로 고른 후보를 서비스에 낼지는 보통 A/B Test 로 마지막에 결정한다. Deep Neural Networks for YouTube Recommendations 도 개발 중에는 offline 지표로 모델을 개선하고, 최종 결정은 A/B Test 로 내린다고 적었다.
결과를 믿을 수 있게 만드는 조건은 두 가지다.
- 같은 기간에 노출한다. 지표는 로직 말고도 순간적인 유행, 새 콘텐츠의 등장, 요일·시간대별 행동 차이에 따라 움직인다. A 를 이번 주에, B 를 다음 주에 보여 주면 두 주의 차이가 로직의 차이와 섞인다.
- 사용자를 무작위로 배정한다. 무작위로 나누면 두 그룹의 연령, 활동량, 취향 같은 성질이 평균적으로 같아진다. 그러면 두 그룹 사이에 체계적으로 다른 것은 로직뿐이고, 나머지 차이는 누가 어느 그룹에 뽑혔느냐에서 오는 우연한 변동이다. 이 우연한 변동이 얼마나 클 수 있는지를 따지는 것이 뒤에 나오는 표본 크기 계산과 검정이다.
일부 추천 플랫폼은 새 로직을 전체 트래픽의 5–10% 에만 노출해 기존 로직과 비교한다. 새 로직이 더 나으면 그것이 기본 로직이 되고, 다음 후보와 다시 A/B Test 를 한다.
실험 설계
가설과 판정 지표는 실험 전에 정한다
무엇을 바꾸면 어떤 지표가 얼마나 움직일지를 실험 전에 문장으로 정한다. 예를 들면 “후보 생성 모델을 B 로 바꾸면, 추천 영역을 한 번 이상 클릭한 사용자의 비율(이하 클릭률)이 5% 에서 5.5% 이상으로 오른다” 같은 문장이다. 표본 크기와 검정의 수치 예제는 이 가설을 이어서 쓴다.
- 판정 지표(primary metric)는 하나로 정한다. 결과를 본 뒤 유리한 지표를 고르면, 지표를 여러 개 볼수록 우연히 좋아 보이는 지표가 생긴다. 얼마나 자주 생기는지는 결과 판정의 다중 비교 절에서 계산한다.
- 보호 지표(guardrail metric)를 함께 정한다. 클릭률이 올라도 체류 시간이나 구매가 줄 수 있다. 보호 지표는 B 의 승패를 가리는 데 쓰지 않고, B 가 다른 곳을 해치지 않는지 확인하는 데 쓴다.
- 한 실험에서는 한 가지만 바꾼다. 모델과 UI 를 동시에 바꾸면 지표가 움직여도 어느 변경 때문인지 알 수 없다.
- 대상 사용자를 정한다. 신규 사용자만, 모바일 사용자만처럼 범위를 좁혔다면 결과도 그 범위에서만 성립한다.
무작위 배정 단위는 보통 사용자다
배정 단위는 무엇을 A 와 B 로 나누느냐다. 요청(request)마다 그룹을 새로 뽑으면 한 사용자가 A 와 B 의 추천을 번갈아 보게 된다. 그러면 B 화면에서 본 아이템을 나중에 A 화면에서 클릭하는 식으로 두 로직의 효과가 섞인다. 그래서 추천 시스템에서는 보통 사용자 ID 를 해시(hash)해 그룹을 정하고, 실험 기간 내내 한 사용자를 같은 그룹에 둔다.
배정을 사용자 단위로 했으면 분산도 사용자 단위로 계산한다. 지표를 노출 단위로 세면(노출 대비 클릭 비율, CTR) 같은 사용자의 노출들은 서로 비슷하게 반응한다. 클릭을 잘 하는 사용자는 여러 노출에서 클릭하기 때문이다. 이 노출들을 서로 독립인 표본으로 취급하면 실제보다 표본이 많은 것처럼 계산되어 분산이 작게 나오고, 우연한 차이도 유의하게 보인다. 사용자별 지표를 먼저 구해 그 평균을 비교하거나, 노출 단위 지표의 분산을 사용자 단위로 보정하는 방법(delta method)을 쓴다.
실험 기간에는 두 그룹의 경험을 로직 외에는 같게 유지한다. 한 그룹에만 프로모션을 하거나 UI 를 크게 바꾸면 그 차이가 로직의 차이와 섞인다. 대규모 마케팅, 언론 보도, 서비스 장애, 공휴일처럼 두 그룹에 함께 영향을 주는 사건은 막을 수 없으니, 기록해 두었다가 결과를 해석할 때 고려한다.
표본 크기는 찾고 싶은 최소 차이와 검정력으로 정한다
표본이 작으면 두 로직이 같아도 클릭률이 우연히 꽤 다르게 나오고, 실제 차이가 있어도 우연한 변동에 묻힌다. 그룹마다 필요한 사용자 수는 아래 네 값으로 정해진다.
| 값 | 뜻 | 흔히 쓰는 값 |
|---|---|---|
| 기준 비율 | 기존 로직의 지표 값 | 과거 데이터에서 구함 |
| 최소 검출 효과(MDE, minimum detectable effect) | 놓치지 않고 찾고 싶은 가장 작은 차이 | 사업상 의미가 있는 크기 |
| 유의수준 | 실제 차이가 없는데 “차이가 있다” 고 판정할 확률의 상한 (1종 오류) | 0.05 |
| 검정력 | 실제 차이가 MDE 만큼 있을 때 “차이가 있다” 고 판정할 확률 | 0.8 |
유의수준의 정의는 significance level 에 있다. 비율 지표에서 그룹당 표본 크기는 다음 식으로 근사한다.
| 기호 | 뜻 |
|---|---|
| 그룹 하나에 필요한 사용자 수 | |
| 기존 로직의 비율 | |
| 에서 MDE 만큼 달라진 비율 | |
| 표준정규분포에서 아래쪽 누적확률이 인 값. , |
분자의 는 사용자 한 명의 클릭 여부(0 또는 1)의 분산이고, 분모는 찾으려는 차이의 제곱이다. 찾으려는 차이가 절반이 되면 분모가 4분의 1 이 되므로 필요한 표본은 네 배 가까이 늘어난다.
설명용 수치로, 기존 클릭률이 5% 이고 상대적으로 10% 오른 5.5% 를 찾고 싶다고 하자. , 검정력 0.8 을 넣으면:
값을 반올림하지 않고 계산하면 31,231 명이다. 상대 5% 개선(5.25%)을 찾으려면 약 12만 2천 명이 필요하다. 31,231 명의 3.9 배다.
실험 기간은 필요한 표본을 하루 유입량으로 나눠 정하되, 요일에 따른 차이가 결과에 고르게 들어가도록 최소 1주를 채운다. 위 예에서 그룹마다 하루 약 2,240 명이 들어온다면 14일이 걸린다. 기간이 너무 짧으면 요일·계절 편차를 놓치고, 너무 길면 경쟁사 활동이나 시장 변화 같은 외부 요인이 끼어든다. 보통 1–2주, 그리고 사업 주기(예: 주간 판매 패턴)를 한 번 이상 포함하는 기간을 권한다.
결과 판정
검정 전에 그룹 크기가 계획한 비율대로인지 본다
50:50 으로 나눴는데 두 그룹의 크기가 우연으로 보기 어려울 만큼 다르면, 배정이나 로그 수집에 버그가 있다는 신호다(sample ratio mismatch, SRM). 예를 들어 B 로직이 느려서 기다리다 떠난 사용자의 로그가 빠지면, B 그룹에는 끝까지 기다린 사용자만 남아 지표가 왜곡된다.
설명용 수치로, 10만 명을 50:50 으로 나눴는데 A 에 50,600 명, B 에 49,400 명이 들어왔다고 하자. 무작위 배정이라면 한 그룹의 크기는 평균 5만 명, 표준편차 명이다. A 가 계획한 5만 명에서 600 명 벗어난 것은 표준편차의 3.8 배이고, 무작위 배정에서 어느 쪽으로든 이만큼 벗어날 확률은 약 0.015% 다. 계획보다 1.2% 많을 뿐이라 작아 보여도 우연이 아니므로, 지표를 비교하기 전에 원인부터 찾는다.
두 비율의 차이는 z-검정으로 판정한다
검정은 “두 로직의 실제 클릭률이 같다” 는 귀무가설(null hypothesis)에서 출발한다. 귀무가설이 참이라고 할 때 관측한 차이가 얼마나 드문지 계산하고, 충분히 드물면 귀무가설을 기각한다.
사용자마다 클릭 여부가 0 또는 1 이므로 각 사용자의 값은 statistic/Bernoulli distribution 를 따른다. 표본이 크면 central limit theorem 에 따라 각 그룹의 클릭률은 정규분포에 가깝게 흔들린다. 두 그룹은 서로 독립이므로 차이의 분산은 두 분산의 합이고, 차이를 그 표준오차로 나눈 값 를 표준정규분포와 비교한다(Z-test).
| 기호 | 뜻 |
|---|---|
| , | 각 그룹의 사용자 수 |
| , | 각 그룹에서 클릭한 사용자 수 |
| , | 관측한 클릭률 |
| 차이 의 표준오차(standard error). 같은 실험을 반복할 때 이 차이가 흔들리는 폭 |
p-value 는 귀무가설이 참일 때 가 관측한 값 이상으로 나올 확률이다. p-value 가 미리 정한 유의수준 0.05 이하이면 차이가 통계적으로 유의하다(statistical significance)고 판정한다. B 가 나은 쪽과 못한 쪽을 모두 보는 양측 검정(hypothesis test)이므로, 과 같은 조건이다.
설명용 수치로, 표본 크기 절의 설계대로 그룹마다 31,300 명을 모았고 A 에서는 1,565 명(5.00%)이 클릭했다고 하자. B 의 결과가 두 가지로 나온 경우를 비교한다. 표의 %p(퍼센트포인트)는 비율끼리 뺀 차이로, 5.00% 에서 5.50% 로 오르면 +0.50%p 다.
| B 의 클릭 수 | 차이 | SE | p-value | 차이의 95% 신뢰구간 | ||
|---|---|---|---|---|---|---|
| 1,722 | 5.50% | +0.50%p | 0.178%p | 2.81 | 0.005 | [+0.15%p, +0.85%p] |
| 1,650 | 5.27% | +0.27%p | 0.176%p | 1.54 | 0.12 | [−0.07%p, +0.62%p] |
첫 번째 경우 이 1.96 보다 커서 유의하고, 두 번째 경우는 유의하지 않다. 신뢰구간 열은 다음 절에서 읽는다.
p-value 와 유의수준은 다른 값이다. 유의수준은 실험 전에 정하는 기준이고, p-value 는 데이터에서 계산한 값이다. p-value 는 “B 가 A 보다 나을 확률” 도 아니다. 그 확률을 직접 구하려면 베이지안 방법을 쓴다. 표본 크기와 p-value 를 쿠키 예제로 풀어 쓴 입문 설명과 베타 분포를 쓰는 베이지안 A/B Test 는 통계적 유의성 계산법 에 있다.
클릭률처럼 0 또는 1 이 아닌 지표(체류 시간, 구매 금액)는 Student’s t-test 로 평균을 비교하거나, 분포를 가정하지 않고 두 그룹의 라벨을 섞어 보는 Permutation Test 를 쓴다.
신뢰구간으로 차이가 얼마나 큰지 본다
p-value 는 차이가 0 인지 아닌지에만 답한다. 차이가 얼마나 큰지는 confidence interval (신뢰구간)로 본다. 차이의 95% 신뢰구간은 이다. 같은 방식으로 실험을 반복해 매번 이 구간을 만들면, 그 구간들의 95% 가 실제 차이를 포함한다.
z-검정 절 표의 두 경우를 신뢰구간으로 읽으면 다음과 같다.
- 첫 번째 경우 [+0.15%p, +0.85%p] 는 0 을 포함하지 않는다. p-value 가 0.05 보다 작은 것과 같은 말이다. 하지만 하한 0.15%p 는 기준 5% 의 상대 3% 이고 상한 0.85%p 는 상대 17% 다. B 가 A 보다 낫다는 결론은 유의수준 0.05 에서 성립하지만, 가설에 적은 “상대 10% 이상” 이 맞는지는 이 데이터로 확정할 수 없다.
- 두 번째 경우 [−0.07%p, +0.62%p] 는 0 을 포함하므로 유의하지 않다. 그런데 이 구간은 설계 때 찾으려던 +0.5%p 도 포함한다. 그래서 결론은 “B 는 효과가 없다” 가 아니라 “효과가 0 일 수도, 0.5%p 이상일 수도 있어서 이 표본으로는 가릴 수 없다” 이다.
반대로 표본이 아주 크면 사업상 의미 없는 차이도 유의하게 나온다. SE 는 에 비례해 줄어들기 때문이다. 같은 클릭률에서 그룹당 1,000만 명을 모으면 SE 가 약 0.01%p 가 되어, 0.02%p(상대 0.4%) 차이도 로 유의하다. 그래서 유의한지와 별개로 신뢰구간이 MDE 와 비교해 어디에 있는지를 함께 본다.
지표와 세그먼트를 여러 개 검정하면 우연한 유의가 늘어난다
유의수준 0.05 는 검정 하나에서 우연히 유의가 나올 확률이다. 서로 독립인 검정을 개 하면 그중 하나 이상이 우연히 유의할 확률은 이다.
| 검정 수 | 하나 이상 우연히 유의할 확률 | Bonferroni 보정 후 검정마다의 기준 |
|---|---|---|
| 1 | 5.0% | 0.05 |
| 5 | 22.6% | 0.01 |
| 10 | 40.1% | 0.005 |
| 20 | 64.2% | 0.0025 |
결과가 왜 그렇게 나왔는지 보려고 신규/재방문, 기기, 지역 같은 세그먼트로 나눠 보는 것은 유용하다. 하지만 세그먼트 10 개를 각각 검정하면, B 가 아무 효과가 없어도 40% 확률로 어딘가에서 “유의한” 세그먼트가 나온다. 그래서 승패는 실험 전에 정한 판정 지표 하나로 가린다. 다른 지표와 세그먼트에서 결론을 내려면 검정마다의 기준을 으로 낮추고(Bonferroni 보정), 그렇지 않으면 다음 실험의 가설로만 쓴다.
매일 결과를 보다가 유의해진 날 멈추면 1종 오류가 커진다
p-value 는 표본 크기를 미리 정하고 끝에서 한 번 계산한다는 전제로 만든 값이다. 매일 결과를 보다가 처음 p-value 가 0.05 아래로 내려간 날 멈추면, 우연한 변동이 잠깐 기준을 넘은 순간을 결론으로 삼게 된다. 실험 초반에는 표본이 적어 차이가 크게 흔들리므로 이런 순간이 자주 생긴다.
얼마나 자주인지 직접 시뮬레이션했다(실제 실험이 아니라 설명용 계산이다).
- 두 그룹 모두 실제 클릭률이 5% 인 A/A 실험(같은 로직끼리 비교하는 실험)을 만든다. 그룹마다 하루 2,236 명씩 14일이면 표본 크기 절에서 계산한 약 31,300 명이다.
- 매일 그때까지 쌓인 데이터로 z-검정을 한다.
- 이 실험을 2만 번 반복하며, 14일째에 한 번만 판정한 경우와 14일 중 하루라도 유의하면 그날 멈춘 경우의 “유의” 판정 비율을 센다.
14일째에 한 번만 판정하면 유의 판정 비율은 5.0% 로 유의수준과 같다. 매일 보다가 멈추면 약 22% 다(난수 시드 세 개에서 21.5–22.6%). 두 로직이 같은데도 다섯 번에 한 번 이상 차이가 있다고 판정하는 셈이다.
그래서 표본 크기와 기간을 실험 전에 정하고, 끝난 뒤에 판정한다. 장애나 큰 손실처럼 중간에 멈춰야 할 이유가 있다면, 여러 번 보는 것을 전제로 기준을 조정한 검정(sequential test)을 쓴다.
추천 시스템에서 흔한 함정
앞의 설계와 판정은 두 가지를 가정한다. 실험 기간의 효과가 실험이 끝난 뒤에도 유지되고, 한 사용자의 결과는 그 사용자가 받은 로직에만 달려 있다는 것이다. 추천 시스템에서는 둘 다 자주 깨진다.
새로움 효과는 초반에 지표를 올렸다가 사라진다
추천 결과가 바뀌면 사용자는 낯선 아이템을 호기심에 클릭한다(novelty effect). 이 상승은 새 로직이 취향을 더 잘 맞춰서가 아니라 화면이 바뀌어서 생긴 것이라, 사용자가 익숙해지면 사라진다. 반대로 익숙한 화면이 바뀌어 처음 며칠은 지표가 떨어졌다가 회복되기도 한다(primacy effect).
날짜별로 B 와 A 의 차이를 그려 보면 새로움 효과인지 오래 가는 효과인지 구분할 수 있다. 차이가 첫 며칠에 크고 계속 줄어들면, 실험 기간 전체의 평균 차이는 장기 효과보다 크게 나온 값이다. 실험 기간에 처음 가입한 사용자만 따로 보는 방법도 있다. 이들은 바뀌기 전 화면을 본 적이 없으므로 새로움 효과가 생기지 않는다.
두 그룹이 재고·예산·학습 데이터를 공유하면 서로 영향을 준다
두 그룹이 같은 자원을 나눠 쓰면 B 로직이 내린 추천이 A 그룹의 결과까지 바꾼다(interference). 그러면 실험에서 본 B 와 A 의 차이는 B 를 전체 사용자에게 적용했을 때의 효과와 달라진다.
- 재고와 예산: B 가 특정 상품을 많이 추천해 재고가 떨어지면 A 그룹 사용자는 그 상품을 살 수 없다. 광고에서는 B 가 광고주 예산을 빨리 소진하면 A 그룹에 나갈 광고가 줄어든다.
- 사용자 사이의 연결: 공유, 팔로우, 댓글이 있는 서비스에서는 B 그룹 사용자의 행동이 친구인 A 그룹 사용자의 피드에 나타난다.
- 학습 데이터: 두 모델을 실험 기간의 전체 로그로 다시 학습하면, 트래픽 대부분을 가진 A 가 만든 로그가 B 의 학습 데이터 대부분이 된다. B 를 전체에 적용했다면 B 가 노출한 아이템의 반응이 쌓였을 것이므로, 실험 중의 B 는 실제로 적용됐을 때의 B 와 다른 데이터로 학습된다.
대책은 영향이 퍼지는 범위를 한 단위로 묶어 배정하는 것이다(cluster randomization). 지역이나 시장 단위로 나누거나, 사용자 연결망을 덩어리로 잘라 덩어리째 배정한다. 광고처럼 예산을 공유하면 예산도 그룹별로 나눈다. 단위가 커지면 배정 단위의 수가 줄어 표본 크기를 다시 계산해야 한다.
Offline A/B Test: 서비스에 내기 전에 로그로 후보를 거른다
이 절은 NDC21 의 추천 알고리즘 offline A/B Test 발표를 정리한 것이다.
online A/B Test 는 비용이 크다
- 새 로직이 나쁘면 그 그룹의 사용자는 실제로 나쁜 추천을 본다. 최악의 경우 부정적인 경험을 한 사용자가 서비스를 떠난다.
- 광고는 클릭이 곧 수익이라 매출이 바로 떨어질 수 있다.
- 표본 크기 절의 예처럼 후보 하나를 판정하는 데 그룹마다 수만 명과 1–2주가 든다.
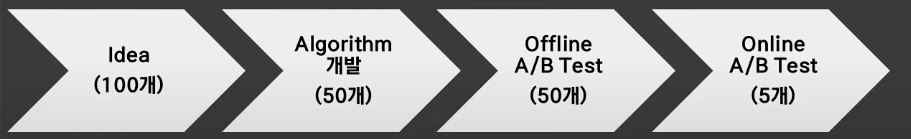
Offline A/B Test 는 과거에 A 가 서비스되며 쌓인 로그로 B 가 서비스됐다면 나왔을 성능을 추정한다. 그 결과로 성능이 떨어지는 후보를 online A/B Test 전에 걸러내고, 추정 성능이 좋은 후보만 사용자에게 내보낸다. 아래 그림은 발표가 보여 준 걸러내기 흐름이다. 아이디어 100 개 중 50 개가 알고리즘으로 구현되고, 50 개 모두 offline A/B Test 를 거쳐 5 개만 online A/B Test 에 들어간다.
로그에는 A 가 보여 준 아이템의 반응만 있다
로그로 B 를 바로 평가할 수는 없다. 사용자는 A 가 노출한 아이템에만 반응할 수 있었으므로, B 가 새로 추천할 아이템에 대한 반응은 로그에 없다. 반응이 기록되지 않은 아이템을 사용자가 원하지 않은 아이템으로 취급하면, 싫어해서 반응하지 않은 것과 노출되지 않아 반응할 수 없었던 것이 섞인다(exposure bias). 그래서 offline 추정은 많은 가정 위에 서 있고, online 결과와 다를 수 있다.
발표는 이 문제를 반사실(counterfactual) 질문으로 바꾼다. “X 음악이 A 가 아니라 B 에 의해 추천되었다면, 20% 확률로 클릭되었을 것이다” 같은 질문이다. 로그에 있는 반응은 그대로 쓰되, B 가 그 아이템을 추천했을 확률에 따라 반응에 가중치를 다시 매긴다(re-weighting).
importance weight 로 로그의 반응을 다시 가중한다
| 기호 | 뜻 |
|---|---|
| 로그의 한 행. A 가 어떤 순위 에 추천한 아이템 하나와 그 반응 | |
| , | A, B 가 그 아이템을 순위 에 추천할 확률 |
| 분모가 0 이 되지 않게 더하는 작은 수 | |
| importance weight. 1 보다 크면 B 가 A 보다 그 아이템을 그 순위에 더 자주 추천하고, 1 이면 같고, 1 보다 작으면 덜 추천한다 | |
| 반응. 클릭이면 1, 아니면 0 | |
| 로그의 행 수 | |
| B 의 추정 반응률 |
A 의 실제 반응률은 의 단순 평균이다. 여기에 B 가 더 자주 추천할 아이템의 반응은 크게, 덜 추천할 아이템의 반응은 작게 세어 평균을 내면 B 가 서비스되었을 때의 반응률 추정이 된다. 이 방법이 importance sampling (IS) 이고, 추천 시스템에서는 inverse propensity score (IPS) 라고도 부른다.
추천 확률은 대개 식으로 바로 구할 수 없어서 Monte Carlo simulation 으로 구한다. 같은 사용자에게 추천 목록을 번 생성하고, 각 아이템이 순위 에 나온 비율을 그 순위에 추천될 확률로 쓴다.
음악 추천 로그 세 행으로 계산한 예
발표의 예제다. A 가 추천한 세 곡에 대한 사용자의 반응과 두 알고리즘의 추천 확률이 있다.
| 순위 | A 가 추천한 음악 | 반응 | ||||
|---|---|---|---|---|---|---|
| 1 | 어떻게 지내 (오반) | 0 | 0.8 | 0.2 | 0.25 | 0 |
| 2 | 주저하는 연인들을 위해 (잔나비) | 1 | 0.6 | 0.2 | 0.33 | 0.33 |
| 3 | 여행 (볼빨간 사춘기) | 1 | 0.7 | 0.9 | 1.3 | 1.3 |
A 의 실제 반응률은 세 곡 중 두 곡이 클릭됐으므로 66.7% 다. B 의 추정 반응률은 다음과 같다.
반올림하지 않은 가중치 0.333 과 1.286 으로 계산하면 54.0% 다. B 는 클릭된 3번 곡을 A 보다 자주 추천하지만(가중치 1.3), 역시 클릭된 2번 곡은 A 의 3분의 1 만큼만 추천한다(가중치 0.33). 2번 곡에서 줄어드는 몫이 3번 곡에서 늘어나는 몫보다 커서, B 를 서비스하면 반응률이 A 보다 낮을 것으로 추정된다.
A 가 거의 추천하지 않은 아이템은 가중치가 폭주한다: CIS 와 NCIS
IS 추정의 약점은 A 가 아주 낮은 확률로 추천한 아이템에서 드러난다. 예를 들어 , 이면 이다. 이 아이템에 클릭이 하나 있으면 그 행 하나가 클릭 50 번으로 계산되어 전체 추정을 좌우한다. 그런 행이 로그에 우연히 들어왔는지에 따라 추정값이 크게 흔들린다(분산이 크다).
CIS (Capped Importance Sampling) 는 가중치에 상한 를 둔다.
상한을 두면 흔들림은 줄지만, 상한에 걸린 행은 원래보다 작게 세므로 추정값이 실제보다 낮은 쪽으로 치우친다(bias).
NCIS (Normalized CIS) 는 행 수 대신 잘린 가중치의 합으로 나눈다.
이렇게 하면 추정값이 반응 의 가중평균이 되어 항상 0 과 1 사이에 있다. 상한 때문에 가중치가 전체적으로 작게 잡혀도 분자와 분모가 함께 작아지므로, CIS 에서 생긴 치우침이 일부 상쇄된다.
발표에서 확인한 내용은 다음과 같다.
- offline A/B Test 추정 방법 중 NCIS 의 성능이 가장 좋았다.
- NCIS 에 두 변형을 더 적용할 수 있다. pieceNCIS 는 데이터를 적절한 그룹으로 나눠 그룹마다 정규화하고, pointNCIS 는 데이터 각각을 정규화한다.
- NCIS 같은 방법은 추천 확률이 있어야 하므로, 같은 입력에 늘 같은 목록을 내는 deterministic 알고리즘에는 적용하기 어렵다. 추천 확률이 0 아니면 1 이 되기 때문이다. 이때는 ranking score 에 비례해 아이템을 뽑는 weighted sampling 으로 stochastic 모델처럼 근사해 추천 확률을 만든다.
- 반응을 예측하는 모델과 importance weight 를 함께 써서, 둘 중 하나만 정확해도 추정이 치우치지 않게 하는 Doubly Robust 방법도 적용해 볼 수 있다.
같은 추정 방법을 정식으로 다룬 논문은 Offline AB testing for Recommender Systems 이고, 로그로 추천 정책을 평가하는 방법(Replay, IPS, SNIPS)의 비교는 Unbiased Offline Evaluation for RecSys 에 있다.
References
- NDC21, 추천 알고리즘 Offline A/B Test 발표: youtube link
- Gilotte et al., Offline A/B testing for Recommender Systems (2018): https://arxiv.org/abs/1801.07030