추천 영역의 후보 생성 모델을 B 로 바꾸려 한다. AB Test 로 확인하려면 그룹마다 3만 명 넘는 사용자에게 2주 동안 B 의 추천을 보여 줘야 한다. 그런데 후보가 B 하나가 아니라 B1 부터 B50 까지 50 개라면?
- 50 개를 전부 online 실험에 올리면 몇 달이 걸린다.
- 그중 나쁜 후보를 받은 사용자는 그 기간 내내 나쁜 추천을 본다.
그래서 지금 모델 A 가 서비스되며 쌓인 로그로 “B 가 서비스됐다면 클릭률이 얼마였을까” 를 먼저 추정하고, 가망 있는 후보만 online 실험에 올린다. 이것이 Offline A/B Test 다. 아래 내용은 NDC21 의 추천 알고리즘 Offline A/B Test 발표와, 같은 방법을 다룬 Offline AB testing for Recommender Systems 논문을 바탕으로 한다.
한눈에 보기
- 목적은 online 실험에 올릴 후보를 거르는 것이다: offline 추정이 online 실험을 대신하지는 않는다.
- 로그에는 A 가 보여 준 아이템의 반응만 있다: B 가 새로 추천할 아이템의 반응은 로그에 없다.
- 그래서 로그의 반응에 가중치를 다시 매긴다: B 가 A 보다 자주 추천할 아이템의 반응은 크게, 덜 추천할 아이템의 반응은 작게 센다.
- A 가 거의 추천하지 않은 아이템은 가중치가 지나치게 커진다: 가중치에 상한을 두고(CIS), 가중치 합으로 나눠(NCIS) 흔들림을 줄인다.
online 실험이 비싼 이유
- 새 로직이 나쁘면 그 그룹의 사용자는 실제로 나쁜 추천을 본다. 최악의 경우 서비스를 떠난다.
- 광고는 클릭이 곧 수익이라 매출이 바로 떨어질 수 있다.
- 후보 하나를 판정하는 데 그룹마다 수만 명과 1–2주가 든다.
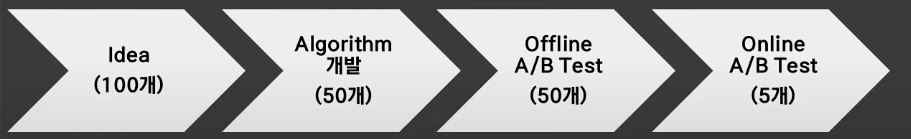
발표는 Offline A/B Test 로 후보를 거르는 흐름을 아래처럼 보였다. 아이디어 100 개 중 50 개가 알고리즘으로 구현되고, 50 개 모두 Offline A/B Test 를 거쳐 5 개만 online A/B Test 에 들어간다.
로그로 바로 평가할 수 없는 이유
로그에는 A 가 노출한 아이템의 반응만 있다.
- 사용자는 A 가 보여 준 아이템에만 반응할 수 있었다.
- B 가 새로 추천할 아이템에 사용자가 어떻게 반응했을지는 로그에 없다.
반응이 없는 아이템을 “원하지 않은 아이템” 으로 취급하면 두 경우가 섞인다.
- 보고 싫어서 반응하지 않은 아이템
- 노출되지 않아 반응할 수 없었던 아이템
이 섞임을 노출 편향(exposure bias)이라 한다. 그래서 offline 추정은 여러 가정 위에 서 있고, online 결과와 다를 수 있다.
발표는 이 문제를 반사실(counterfactual) 질문으로 바꾼다. “이 노래를 A 가 아니라 B 가 추천했다면 클릭됐을까” 같은 질문이다. 로그에 있는 반응은 그대로 쓰되, B 가 그 아이템을 추천했을 확률에 따라 반응에 가중치를 다시 매긴다.
importance weight 로 반응을 다시 센다
로그의 한 행은 A 가 어떤 순위에 추천한 아이템 하나와 그 반응(클릭 1, 아니면 0)이다. 행마다 가중치 w 를 매긴다.
-
w = B 의 추천 확률 ÷ A 의 추천 확률: 여기서 추천 확률은 그 모델이 그 아이템을 그 순위에 추천할 확률이다.
-
w 가 1 보다 크면: B 가 A 보다 그 아이템을 더 자주 추천한다. 그 행의 반응을 더 크게 센다.
-
w 가 1 보다 작으면: B 가 덜 추천한다. 그 행의 반응을 작게 센다.
A 의 실제 클릭률은 반응의 단순 평균이다. 반응에 w 를 곱해 평균을 내면 B 가 서비스됐을 때의 클릭률 추정이 된다. 이 방법이 importance sampling (IS) 이고, 추천 시스템에서는 inverse propensity score (IPS) 라고도 부른다. 정확한 식은 부록에 있다.
추천 확률은 대개 식으로 바로 구할 수 없다. 그래서 같은 사용자에게 추천 목록을 여러 번 생성해(Monte Carlo simulation), 각 아이템이 그 순위에 나온 비율을 추천 확률로 쓴다.
Step by Step 예시: 로그 세 행
발표의 예제다. A 가 한 사용자에게 추천한 세 곡과 그 반응, 두 모델의 추천 확률이 있다.
| 순위 | A 가 추천한 음악 | 반응 | A 의 추천 확률 | B 의 추천 확률 | 가중치 w | w × 반응 |
|---|---|---|---|---|---|---|
| 1 | 어떻게 지내 (오반) | 0 | 0.8 | 0.2 | 0.25 | 0 |
| 2 | 주저하는 연인들을 위해 (잔나비) | 1 | 0.6 | 0.2 | 0.33 | 0.33 |
| 3 | 여행 (볼빨간 사춘기) | 1 | 0.7 | 0.9 | 1.29 | 1.29 |
A 의 실제 클릭률은 세 곡 중 두 곡이 클릭됐으므로 66.7% 다.
B 의 추정 클릭률은 마지막 열의 평균이다.
- (0 + 0.33 + 1.29) ÷ 3 = 54.0%
B 를 서비스하면 클릭률이 A 보다 낮을 것으로 추정된다.
- B 는 클릭된 3번 곡을 A 보다 자주 추천한다 (가중치 1.29).
- 하지만 역시 클릭된 2번 곡은 A 의 3분의 1 만큼만 추천한다 (가중치 0.33).
- 2번 곡에서 줄어드는 몫이 3번 곡에서 늘어나는 몫보다 크다.
이 후보는 online 실험에 올리기 전에 걸러진다.
가중치가 지나치게 커질 때: CIS 와 NCIS
A 가 아주 드물게 추천한 아이템에서 가중치가 지나치게 커진다.
- A 의 추천 확률 0.01, B 의 추천 확률 0.5 면 가중치는 50 이다.
- 이 행에 클릭이 하나 있으면 그 클릭 하나가 50 번으로 계산되어 전체 추정을 좌우한다.
- 그런 행이 로그에 우연히 들어왔는지에 따라 추정값이 크게 흔들린다 (분산이 크다).
CIS (Capped Importance Sampling) 는 가중치에 상한을 둔다.
- 상한을 10 으로 두면 가중치 50 도 10 으로 센다. 흔들림은 줄어든다.
- 대신 상한에 걸린 행은 원래보다 작게 세므로, 추정값이 실제보다 낮은 쪽으로 치우친다 (bias).
NCIS (Normalized CIS) 는 행 수 대신 잘린 가중치의 합으로 나눈다.
- 추정값이 반응의 가중평균이 되어 항상 0 과 1 사이에 있다.
- 상한 때문에 가중치가 전체적으로 작게 잡혀도 분자와 분모가 함께 작아지므로, CIS 의 치우침이 일부 상쇄된다.
발표에서 확인한 내용은 다음과 같다.
- 시험한 추정 방법 중 NCIS 의 성능이 가장 좋았다.
- NCIS 에 두 변형을 더 적용할 수 있다. pieceNCIS 는 데이터를 그룹으로 나눠 그룹마다 정규화하고, pointNCIS 는 데이터 하나하나를 정규화한다.
- 같은 입력에 늘 같은 목록을 내는 deterministic 모델은 추천 확률이 0 아니면 1 이라 그대로는 쓰기 어렵다. 이때는 ranking score 에 비례해 아이템을 뽑아(weighted sampling) 추천 확률을 만든다.
- 반응을 예측하는 모델과 importance weight 를 함께 써서, 둘 중 하나만 정확해도 추정이 치우치지 않게 하는 Doubly Robust 방법도 적용해 볼 수 있다.
부록: 식
로그의 행 마다 A 와 B 가 그 아이템을 그 순위에 추천할 확률을 , , 반응을 (클릭 1, 아니면 0), 행 수를 이라 하자.
IS: 분모가 0 이 되지 않게 작은 수 을 더한다.
본문 예시는 , 이므로 이다.
CIS: 가중치에 상한 를 둔다.
NCIS: 행 수 대신 잘린 가중치의 합으로 나눈다.
로그로 추천 정책을 평가하는 다른 방법(Replay, IPS, SNIPS)의 비교는 Unbiased Offline Evaluation for RecSys 에 있다.
관련 노트
- AB Test
- AB Test 함정
- Offline AB testing for Recommender Systems
- Unbiased Offline Evaluation for RecSys
- inverse propensity score
- exposure bias
References
- NDC21, 추천 알고리즘 Offline A/B Test 발표: youtube link
- Gilotte et al., Offline A/B testing for Recommender Systems (WSDM 2018): https://arxiv.org/abs/1801.07030