deep Learning 과 달리 structured data 가 필요한 학습 모델
Machine Learning Model Representation
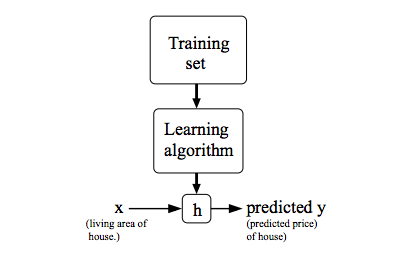
위 그림의 는 가설 (hypothesis) 을 뜻함
는 입력 데이터 공간 (space), 는 출력 데이터 공간
deep Learning 과 달리 structured data 가 필요한 학습 모델
위 그림의 h 는 가설 (hypothesis) 을 뜻함
h:X→YX 는 입력 데이터 공간 (space), Y 는 출력 데이터 공간
...s in POI recommendation primarily focused on feature engineering and conventional (non-deep learning) machine learning-based methods.
...plicit feedback 은 implicit feedback 보다 훨씬 개수가 떨어지기 때문이다. 이 논문에서는 이를 constrained regression라고 부르고, 이러한 방법을 종종 ML 에서는 transfer learning 이라고 부른다. Implementation offline model 학습으로 진행했으며, 빠른 학습을 위해 coordinate gradient descen...
covariate shift 는 ML 에서 종종 마주치는 특수한 형태의 데이터 변화를 의미한다. References
이 값이 작을수록 모델의 성능이 좋다고 판단합니다. Application machine learning 에서 cross-entropy 는 실제 확률 분포와 모델의 예측 분포의 차이 (dissimilarity) 를 계산하는데 활용할 수 있다. cross-entropy 는 상당히 자주 쓰...
Applying ML techniques to dig into large amounts of data can help discover patterns that were not immediately apparent.
여러 층을 쌓은 신경망으로 표현 자체를 데이터에서 학습하는 방식이다. machine learning 의 한 갈래이고, “deep” 은 층이 여러 겹이라는 뜻이다. 특징 설계를 학습으로 대체한다 전통적인 머신러닝은 사람이 특징을 만들어 넣는 단계를 전제로 한다. 이미지에서 모서리를 ...
Probabilistic Machine Learning - An Introduction, 4.5: regularization
...(Optimization problems) 란 여러개의 선택가능한 후보 중에서 최적의 해 (Optimal value) 또는 최적의 해에 근접한 값을 찾는 문제를 일컫는다. 일반적으로 machine learning 분야에서는 비용함수 (Cost function) 를 최소화 또는 최대화 시키는 모델의 파라미터 (parameter) 를 구하게 되는데, 이것은 최적화 문제로 정의될 수 있다. 수학적...
machine learning 기법 중 하나. For RS A Survey on Reinforcement Learning for Recommender Systems Related
여러 층을 쌓은 신경망으로 표현 자체를 데이터에서 학습하는 방식이다. machine learning 의 한 갈래이고, "deep" 은 층이 여러 겹이라는 뜻이다.
covariate shift 는 ML 에서 종종 마주치는 특수한 형태의 데이터 변화를 의미한다.
Applying ML techniques to dig into large amounts of data can help discover patterns that were not immediately apparent.
Negative Log Likelihood(NLL)는 "모델이 정답에 부여한 확률이 낮을수록 커지는 벌점" 이다. 모델이 정답을 확률 1로 맞히면 벌점 0, 정답에 확률을 거의 안 줬으면 벌점이 무한대로 치솟는다.
구글에서 제공하는 머신러닝을 활용할때 알아야할 규칙들
우리가 예측 모형을 build 하는 이유는 불확실성을 제어하고자 하는 것이다.
강한 수학적 백그라운드와 경험 3 년 이상 경력 (비즈니스 문제를 해결 & 머신러닝 적용) 높은 이해력 통계적 접근법 Operations Research 머신러닝 알고리즘에 대한 수학적 기초 논문이나 기술들을 빠르게 프로토타이핑할 수 있는 문제해결 능력 주로 빠르게 변화하는 비즈니스 및 데이터 프로덕션 환경에서...
최적화 문제 (Optimization problems) 란 여러개의 선택가능한 후보 중에서 최적의 해 (Optimal value) 또는 최적의 해에 근접한 값을 찾는 문제를 일컫는다.
machine learning 기법 중 하나.
Semi-supervised learning은 label이 있는 데이터와 label이 없는 데이터를 함께 써서 모델을 학습하는 설정이다. label은 비싸고 unlabeled data는 많은 상황에서 자주 등장한다.