중고거래 앱에 게시글이 3,000 만 건 쌓여 있고, 매일 20 만 건이 새로 올라온다고 하자.
- 게시글마다 카테고리 하나를 붙이려 한다.
- 카테고리는 「아웃도어 > 캠핑 > 캠핑의자」 같은 경로로 1,500 개다.
- 속성도 붙이려 한다.
- 브랜드, 색상, 상품 상태 같은 것이다.
- 사람이 붙이기엔 너무 많고, 분류 모델을 학습할 라벨도 없다.
LLM 에게 게시글과 카테고리 목록을 주고 고르게 하면 라벨 없이도 꽤 잘 붙인다 (llm_as_classifier). 남는 문제는 두 가지다. 3,000 만 번 부르는 돈이 얼마나 드는지, 그리고 붙인 결과가 맞았는지 어떻게 아는지다.
한눈에 보기
- 비용은 건수 × 한 건당 토큰이다.
- 한 건당 토큰의 대부분은 게시글이 아니라 매번 같이 보내는 카테고리 목록이다.
- 비용을 줄이는 길은 세 갈래다.
- 보내는 토큰을 줄인다: 후보 카테고리 좁히기, 이미지 줄이기.
- 같은 토큰을 싸게 받는다: 프롬프트 캐싱, 배치 추론.
- LLM 을 부르는 건수를 줄인다: cascade, distillation.
- 품질은 정답 없이 측정해야 한다.
- 여러 LLM 의 다수결로 정답을 만들고, 그 정답이 사람 판정과 맞는지 따로 확인한다.
- 카테고리는 precision@1, 속성은 precision 과 recall 로 측정한다.
비용 구성
게시글 한 건을 LLM 에 보낼 때 들어가는 입력 토큰을 어림해 보자. 숫자는 설명을 위한 가정이다.
- 지시문: 500 토큰.
- 카테고리 목록: 경로까지 적으면 카테고리 하나에 8 토큰쯤이라 1,500 개면 12,000 토큰.
- 게시글 제목과 본문: 300 토큰.
- 사진 3 장: 장당 1,032 토큰이라 3,096 토큰 (Gemini 2.0 Flash 에서 512×512 사진 한 장 기준).
합치면 한 건에 15,896 토큰이다. 3,000 만 건이면 약 4,770 억 토큰이고, 매일 들어오는 20 만 건에도 하루 약 32 억 토큰이 든다.
한 건 토큰의 79% 가 매번 똑같은 지시문과 카테고리 목록이다.
- 게시글마다 달라지는 글은 2% 도 안 된다.
- 그래서 비용을 줄이는 방법 대부분이 이 고정된 부분을 겨냥한다.
몇 가지를 더 짚어 둔다.
- 출력은 카테고리 id 하나와 속성 몇 개라 입력보다 훨씬 짧다.
- API 대신 GPU 에 모델을 직접 띄워도 원리는 같다.
- 비용은 GPU 를 쓴 시간이고, 그 시간은 입력 토큰을 읽는 단계(prefill)와 출력을 만드는 단계에 비례한다.
- 한 번 다 붙이고 끝나지 않는다.
- 새 게시글은 매일 들어온다.
- 카테고리 체계를 바꾸면 쌓인 게시글을 다시 붙여야 할 수도 있다.
보내는 토큰 줄이기
아래 그림은 같은 게시글 한 건에 보내는 입력 토큰이 방법마다 어떻게 줄어드는지 보여 준다. 막대 길이가 토큰 수이고, 색은 그 토큰이 무엇인지다.
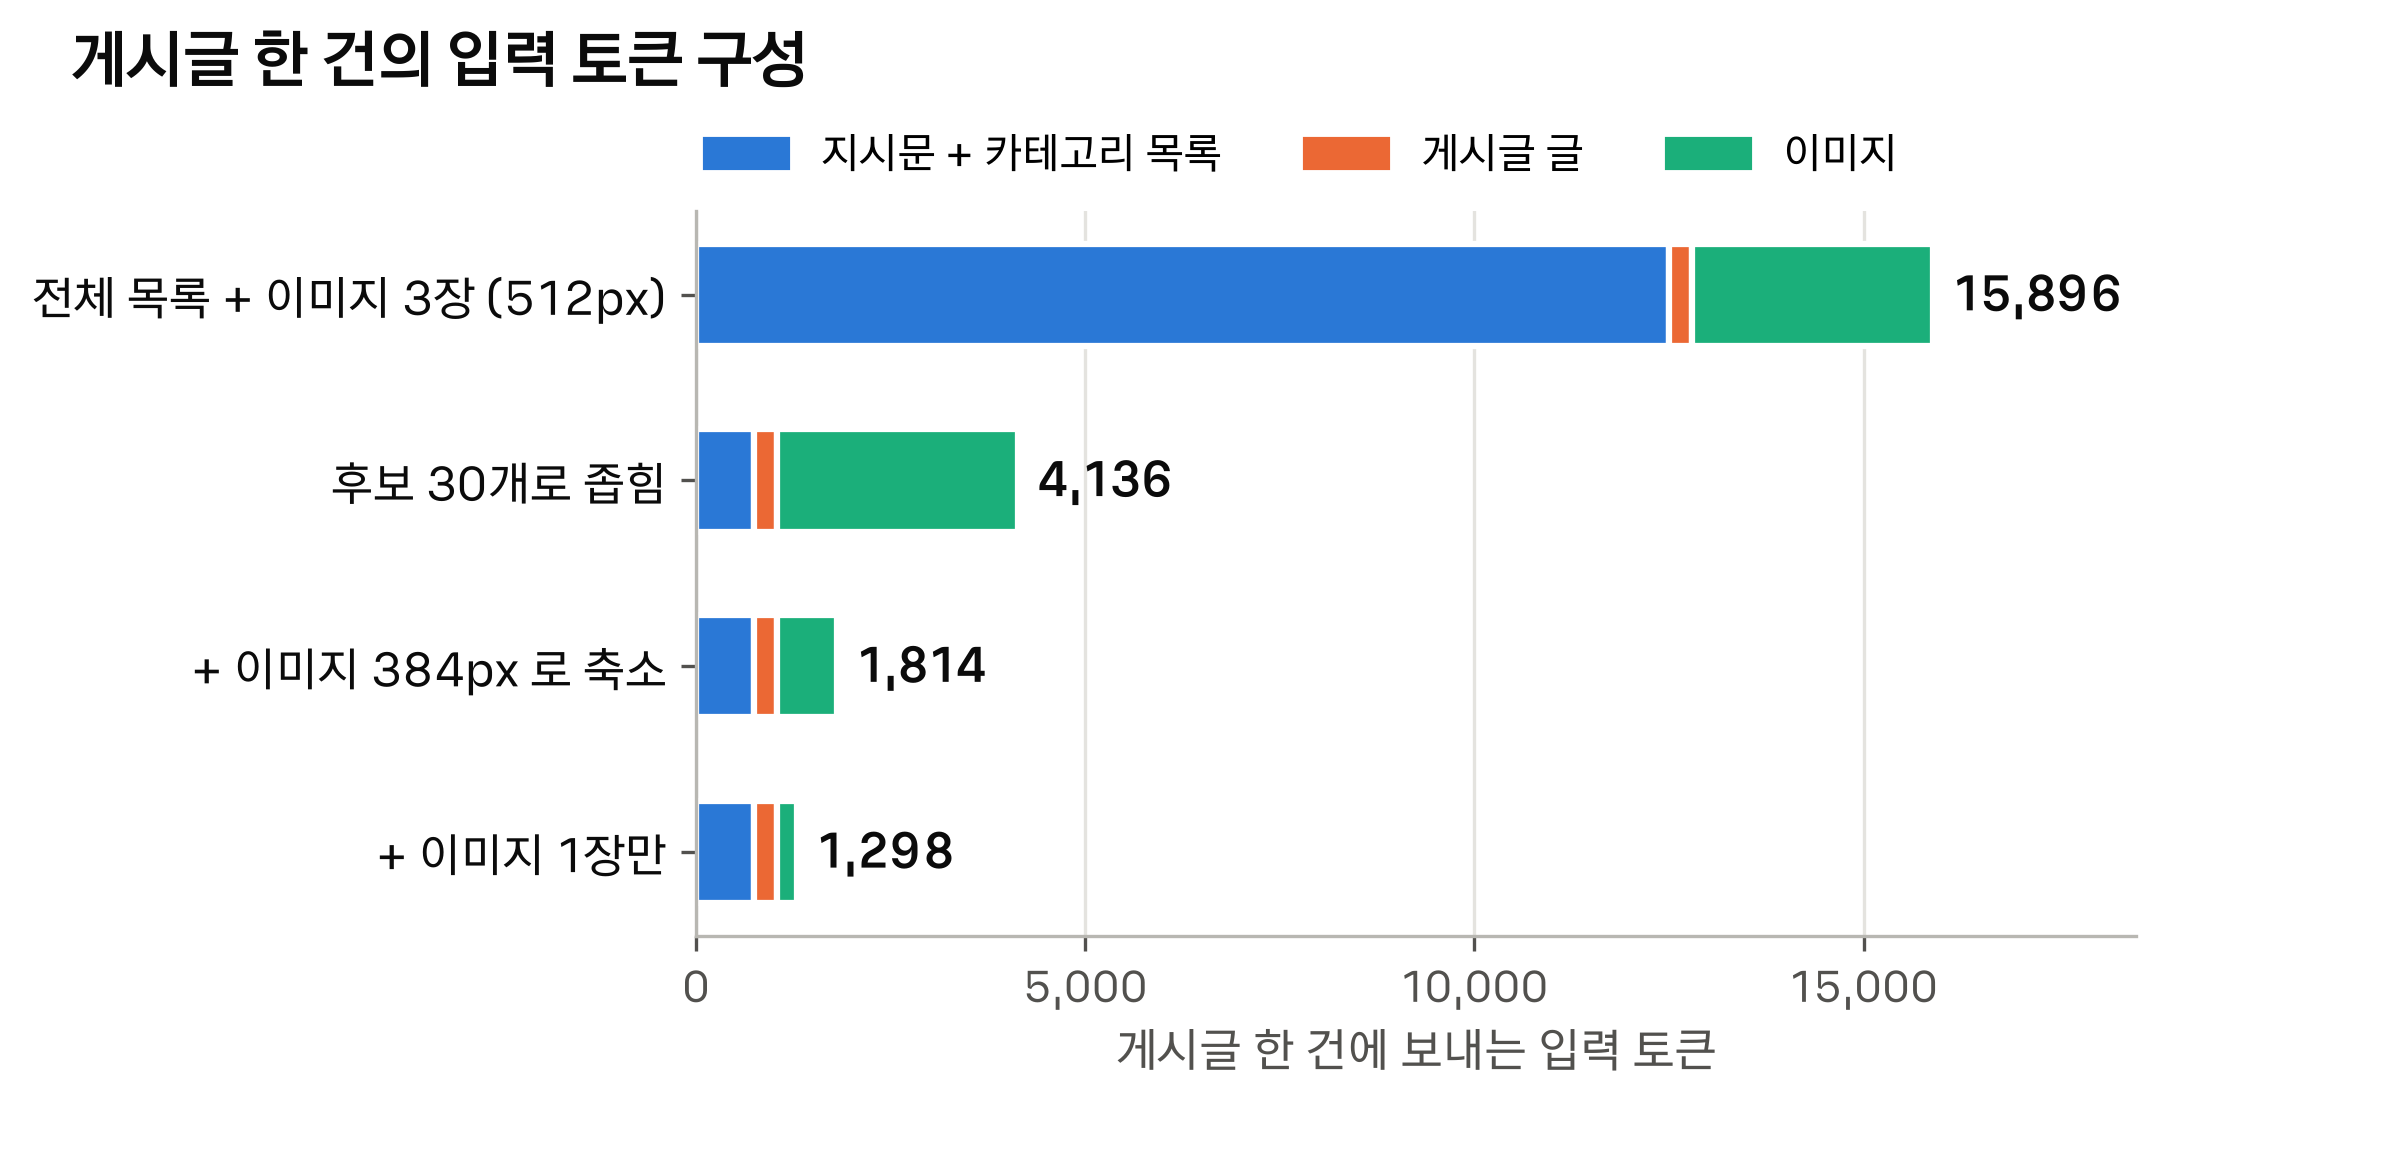
- 후보를 30 개로 좁히면 카테고리 목록이 12,000 토큰에서 240 토큰이 된다.
- 사진을 384×384 로 줄이고 한 장만 보내면 사진이 3,096 토큰에서 258 토큰이 된다.
- 둘을 다 하면 15,896 토큰이 1,298 토큰으로, 약 12 분의 1 이 된다.
후보 카테고리 좁히기
1,500 개 목록을 매번 다 보내는 대신, 게시글과 관련 있어 보이는 카테고리만 골라 보낸다. 방법은 세 가지가 흔하다.
- 전체 목록을 한 번에 보낸다 (single shot): 가장 단순하고 LLM 을 한 번만 부른다.
- 카테고리가 수백 개를 넘으면 긴 목록 속에서 정확도가 떨어진다.
- 위 단계부터 하나씩 고른다 (hierarchical): 「아웃도어」 를 고른 뒤 그 아래 「캠핑」, 다시 그 아래 「캠핑의자」 를 고른다.
- 단계마다 그 층의 카테고리만 보내서 토큰이 적다.
- 처음에 잘못 고르면 아래 단계에서 되돌릴 수 없다.
- 검색으로 먼저 좁힌 뒤 고른다: 카테고리 이름을 문서처럼 보고, 게시글을 검색어처럼 써서 상위 N 개를 찾는다.
- 게시글과 카테고리 이름의 임베딩 유사도로 찾는다 (Embedding-based Retrieval).
- 게시글에서 뽑은 키워드로 카테고리 목록을 BM25 검색한다.
- 두 순위를 Reciprocal Rank Fusion 으로 합친다.
- LLM 은 이렇게 남은 N 개 가운데서만 고른다.
좁히는 단계에서 정답이 빠지면 LLM 이 아무리 좋아도 못 고른다.
- 그래서 좁히는 단계는 “정답이 상위 N 개 안에 들었는가”(recall@N)로 따로 측정한다.
- 검색의 Cascade Ranking System 에서 앞 단계가 후보를 놓치면 뒤 단계가 못 살리는 것과 같다.
당근 기술 블로그의 공개 사례도 이 순서로 바꿔 왔다 (카테고리 분류에 2조 토큰을 쓰면서 알게 된 것들, 2026-02).
- 게시글을 LLM 으로 한 줄 요약한 뒤 그 요약문으로 임베딩 유사도를 계산했다.
- 중고거래 글에는 분류와 상관없는 말이 많아서, 원문 그대로보다 요약문이 후보를 더 정확히 골랐다.
- BM25 만으로는 키워드가 정확히 안 맞는 정답을 놓쳐 recall 이 낮았다.
- 요약문 임베딩 검색과 RRF 로 합쳐서 보완했다.
- 과거 정답으로 키워드 → 카테고리 규칙을 만들어 쉬운 건 LLM 없이 처리하는 방법도 시도했지만 접었다.
- 게시글이 롱테일 분포라 규칙이 맡을 수 있는 범위가 좁았다.
이미지 줄이기
사진을 빼는 것이 아니라 작게, 적게 보낸다.
- 중고거래 글은 글만으로는 무엇을 파는지 안 드러나는 경우가 많아서, 사진을 넣으면 정확도가 오른다 (당근 사례).
- Gemini 2.0 Flash 는 512×512 사진을 타일 4 개로 나눠 약 1,032 토큰을 쓴다.
- 384×384 로 줄이면 타일 1 개라서 토큰이 4 분의 1 로 준다 (당근 사례).
- 사진 장수를 줄여도 정확도가 크게 떨어지지 않았다 (당근 사례).
같은 토큰을 싸게 받기
프롬프트 캐싱
LLM API 는 요청의 앞부분이 이전 요청과 글자 하나까지 같으면, 그 부분을 계산한 결과(KV Cache)를 다시 쓰고 값을 싸게 받는다. 이것을 프롬프트 캐싱(prompt caching)이라 한다. 할인 폭과 조건은 제공자마다 다르다.
고정된 부분을 앞에, 게시글을 뒤에 둔다.
- 지시문과 카테고리 목록을 앞에 두면 모든 요청의 앞부분이 똑같아서 캐시에 걸린다.
- 게시글을 앞에 두면 요청마다 첫 글자부터 달라서 캐시가 하나도 안 걸린다.
- GPU 에 직접 띄운 경우도 같다. vLLM 같은 서빙 엔진의 prefix caching 이 같은 일을 한다 (vllm).
후보 좁히기와 캐싱은 서로 부딪힌다.
- 게시글마다 후보 목록이 다르면 그 목록은 캐시에 안 걸린다.
- 전체 목록을 보내는 single shot 은 목록이 매번 같아서 캐싱에 유리하다 (당근 사례).
- 그래서 “캐시 할인을 받은 긴 목록” 과 “할인 없는 짧은 목록” 가운데 무엇이 싼지는 실제 단가로 계산해 봐야 한다.
배치 추론
바로 결과가 필요 없는 일은 모아서 한꺼번에 보낸다.
- 쌓여 있는 3,000 만 건은 오늘 안에 끝날 필요가 없다.
- 주요 LLM API 는 결과를 늦게(대개 하루 안에) 받는 대신 값을 깎아 주는 배치 API 를 둔다.
- 매일 들어오는 새 글도 몇 시간 늦어도 되면 모아서 배치로 보낸다.
- 올리자마자 카테고리가 필요하면 실시간으로 부른다.
- GPU 에 직접 띄운 경우에는 요청을 모아 함께 돌릴수록 GPU 를 놀리지 않아서 건당 비용이 준다 (Batch Decoding).
LLM 을 부르는 건수 줄이기
Cascade
쉬운 글은 작은 분류기가 맡고, 작은 분류기가 확신하지 못하는 글만 LLM 에 보낸다.
캠핑의자 팝니다처럼 흔한 글은 작은 분류기(예: 작은 BERT 분류기)도 쉽게 맞힌다.- 작은 분류기를 학습할 라벨은 LLM 이 먼저 붙여 둔 결과를 쓴다.
- 작은 분류기가 70% 를 맡으면 LLM 호출은 3,000 만 건에서 900 만 건으로 준다.
어디까지 맡길지는 확신도 기준값으로 정한다.
- 작은 분류기의 확신도가 기준값 이상인 글만 맡긴다.
- 기준값을 올리면 맡기는 글이 줄고, 맡긴 글의 정확도는 오른다.
- 기준값을 내리면 맡기는 글이 늘고, 맡긴 글의 정확도는 떨어진다.
- 확신도 0.9 가 정말 90% 맞는다는 뜻이어야 기준값을 믿을 수 있다 (probability calibration).
작은 분류기는 흔한 카테고리에 강하고 드문 카테고리와 새 카테고리에 약하다.
- 학습 라벨이 흔한 카테고리에 몰려 있기 때문이다.
- 그래서 드문 카테고리로 보이는 글과 새로 만든 카테고리는 LLM 몫으로 남긴다.
Distillation
LLM 이 붙여 쌓은 결과로 작은 모델을 학습해 LLM 을 대신하게 한다 (knowledge distillation).
- cascade 의 작은 분류기도 이렇게 만든다.
- 카테고리 체계가 자주 안 바뀔 때 맞는다.
- 체계를 바꾸면 작은 모델을 다시 학습해야 한다.
- 당근 사례는 체계가 안정된 카테고리에 대해 6 개월 넘게 쌓인 분류 결과로 모델을 학습하는 것을 다음 계획으로 밝혔다 (2026-02 기준).
- 일부는 모델이 처리하고 나머지는 LLM 에 남겨, 새 카테고리 대응과 품질 점검을 계속하는 방식이다.
작은 모델은 LLM 이 틀린 것도 그대로 배운다.
- 작은 모델의 정확도는 대개 LLM 정확도를 넘지 못한다.
- 그래서 LLM 결과의 품질을 따로 측정하는 체계가 먼저 있어야 한다.
품질 관리
정답 라벨이 없는 상태에서 LLM 이 붙인 카테고리가 맞았는지 알아야 한다. 네 단계로 쌓는다.
- 사람 골드셋: 수백에서 천 건쯤을 사람이 직접 붙인다.
- 비싸서 작게 만들지만, 나머지 단계를 검증하는 기준이 된다.
- LLM-as-a-judge 다수결: 매일 처리한 글의 일부(예: 1%)를 서로 다른 LLM 여러 개에 다시 분류시키고, 다수결로 정답을 만든다.
- 주로 쓰는 모델(주 모델)의 정확도를 이 정답 기준으로 매일 측정한다.
- 프롬프트, 모델, 후보 좁히기 방식을 바꿀 때마다 이 정확도가 나빠지지 않았는지 본다.
- 당근 사례가 이 방식이다. 글에 실린 설정 예시는 주 모델 하나, 평가 모델 셋, 샘플 비율 1% 다.
- judge 와 사람의 일치도 검증: 골드셋에서 다수결 정답과 사람 정답이 얼마나 맞는지 본다.
- 우연히 맞는 몫을 빼려면 Cohen’s kappa 를 쓴다.
- 한 카테고리가 대부분이면 전부 그 카테고리로 붙여도 일치율이 높게 나오기 때문이다.
- 일치도가 낮으면 2 단계에서 낸 정확도 숫자를 믿을 수 없다.
- 서비스 지표: 결국 이 라벨을 쓰는 검색과 추천이 좋아졌는지 본다.
- 카테고리로 결과를 좁히는 검색에서 원하는 글이 빠지지 않는지, 같은 카테고리만 줄줄이 나오지 않는지를 A/B 테스트로 확인한다.
모델끼리 의견이 같다고 해서 정답인 것은 아니다.
- 비슷하게 학습한 모델은 같은 글에서 같은 실수를 한다.
- 주 모델과 같은 계열을 judge 로 넣으면 그 실수가 다수결로 정답이 된다.
- 그래서 judge 는 주 모델과 다른 계열로 고르고, 사람 골드셋으로 주기적으로 확인한다.
- LLM judge 가 엉뚱한 입력에 속는 사례는 One Token to Fool LLM-as-a-Judge 에 있다.
카테고리 정확도와 속성 precision · recall
카테고리는 precision@1 로 측정한다.
- 주 모델이 고른 카테고리 하나가 정답과 같은 비율이다.
- 100 건 가운데 87 건이 같으면 0.87 이다.
- 평균 하나만 보면 드문 카테고리에서 많이 틀리는 것이 가려진다.
- 카테고리 층(대분류, 중분류, 소분류)별, 카테고리별 정확도를 함께 본다.
속성은 한 글에 정답이 여러 개라서 precision 과 recall 을 따로 본다.
- precision 은 모델이 붙인 속성 가운데 맞은 비율이고, recall 은 정답 속성 가운데 모델이 찾아낸 비율이다.
- 게시글 하나의 예를 보자.
- 정답: 브랜드 = 노스페이스, 색상 = 블랙, 상태 = 거의 새것.
- 모델: 브랜드 = 노스페이스, 색상 = 블랙, 상태 = 새상품, 크기 = 미니.
- 맞은 것은 브랜드와 색상 두 개다.
- precision 은 모델이 붙인 4 개 가운데 2 개라 0.5, recall 은 정답 3 개 가운데 2 개라 0.67 이다.
- 글마다 precision 과 recall 을 구해서 전체 글에 대해 평균 낸다 (당근 사례).
precision 과 recall 은 한쪽을 올리면 다른 쪽이 떨어지기 쉽다.
- 확실한 속성만 붙이게 하면 precision 은 오르고 recall 은 떨어진다.
- 보이는 대로 다 붙이게 하면 반대가 된다.
상품 상태처럼 판단이 주관적인 속성은 precision 이 낮게 나온다.
- 「사용감 적음」 이 「거의 새것」 인지 「상태 좋음」 인지 경계가 모호하다.
- 당근 사례는 속성 설명에 값마다 기준 표현(예: 「미개봉」, 「택 달린」 은 새상품)을 적어 프롬프트에 넣어 precision 을 올렸다.