KV cache 는 이미 계산한 key·value 를 저장해 두는 캐시다
LLM 은 답변을 한 번에 만들지 않고 토큰을 하나씩 만든다. 방금 만든 토큰을 입력 끝에 붙이고, 다시 모델을 돌려 그다음 토큰을 고른다. 이런 생성 방식을 autoregressive decoding 이라 한다.
KV cache 는 이 과정에서 각 층의 attention 이 이미 계산한 key 벡터와 value 벡터를 GPU 메모리에 저장해 두는 캐시다. 새 토큰을 만들 때는 그 토큰 하나의 query·key·value 만 계산하고, 과거 토큰의 key·value 는 캐시에서 읽는다.
query·key·value, causal mask, multi-head attention 이 무엇인지는 Attention 노트에서 설명했다. 이 노트는 그 위에서 캐시가 왜 필요한지, 얼마나 큰지, attention 최적화 기법들이 캐시를 어떻게 바꾸는지를 다룬다.
캐시가 없으면 같은 계산을 매 스텝 반복한다
과거 토큰의 key·value 는 바뀌지 않는다
LLM 의 attention 은 causal mask 때문에 토큰 의 출력이 번째 토큰에만 의존한다. 그래서 시퀀스 끝에 토큰이 붙어도 앞 토큰들의 hidden vector 는 모든 층에서 그대로이고, 거기서 만든 key·value 도 그대로다. 한 번 계산한 값을 다시 쓸 수 있는 근거가 이것이다.
캐시 없이 생성하면 매 스텝 지금까지의 시퀀스 전체를 모델에 다시 넣는다. 결과는 같지만, 마지막 토큰을 뺀 나머지의 계산은 직전 스텝과 똑같다.
모델에 넣는 토큰 수로 비교한 중복
prompt 1,000 토큰을 넣고 답변 1,000 토큰을 만드는 경우를 세어 본다. 모델에 넣는 토큰 위치 하나당 모든 층의 projection 과 feed-forward 를 한 번씩 계산하므로, 넣는 토큰 위치 수가 attention 행렬 계산을 뺀 나머지 연산량에 비례한다.
| 방식 | 스텝 에서 모델에 넣는 토큰 수 | 1,000 스텝의 합 |
|---|---|---|
| 캐시 없음 | 지금까지의 시퀀스 전체 | |
| 캐시 있음 | 첫 스텝은 prompt 1,000 개, 이후는 새 토큰 1 개 |
캐시가 있으면 처리하는 토큰 위치가 약 750 분의 1 로 준다. 캐시가 없을 때의 합은 답변 길이의 제곱에 비례해 늘고, 캐시가 있을 때는 길이에 비례한다.
캐시가 있어도 attention 자체는 남는다. 스텝 에서 새 query 하나가 캐시의 key 개 전부와 내적하고, value 전부를 가중 평균한다. 그래서 한 스텝의 attention 비용은 문맥 길이에 비례하고, 그 key·value 를 매번 메모리에서 읽어야 한다.
Prefill 은 캐시를 만들고 decode 는 캐시를 읽는다
생성은 두 단계로 나뉜다. 자세한 비교는 Prefill 노트에 있다.
- prefill. prompt 토큰 전체를 한 번에 모델에 넣어 모든 층의 key·value 를 계산하고 캐시에 쓴다. 이 스텝 끝에 첫 출력 토큰이 나온다.
- decode. 새 토큰 하나를 넣어 그 토큰의 key·value 를 캐시 끝에 붙이고, 캐시 전체를 읽어 attention 을 계산한 뒤 다음 토큰을 고른다. 답변이 끝날 때까지 반복한다.
prefill 은 많은 토큰을 한꺼번에 처리해 큰 행렬곱이 되므로 연산 속도가 병목이다. decode 는 토큰 하나를 만들 때마다 가중치와 캐시 전체를 메모리에서 읽지만 계산할 양은 적어서 메모리 대역폭이 병목이다 (Sarathi-Serve 1장·3.1절, DistServe 2.1절). DistServe 부록 A 의 계산으로는 decode 의 attention 이 head 하나에서 메모리를 번 읽고 쓰는 동안 연산은 번 한다( 는 head 길이, 은 문맥 길이). 그래서 캐시가 크면 decode 가 그만큼 느려진다.
캐시 크기는 층·key/value head·head 길이에 비례한다
토큰당 크기를 계산하는 식
토큰 하나가 차지하는 캐시는 층마다, key·value head 마다 길이 짜리 벡터 두 개(key 와 value)다. 요청 전체의 캐시는 여기에 토큰 수와 배치 크기를 곱한다.
| 기호 | 뜻 |
|---|---|
| 토큰 하나의 KV cache 바이트 수 | |
| key 와 value | |
| 층 수 | |
| key·value head 수. 원래의 multi-head attention(MHA)이면 query head 수와 같고, GQA 면 그룹 수, MQA 면 1 | |
| head 하나의 key·value 길이 | |
| 원소 하나의 바이트 수. BF16·FP16 은 2, FP8 은 1 | |
| 시퀀스의 토큰 수 (prompt + 지금까지 만든 답변) | |
| 동시에 처리하는 시퀀스 수 |
NVIDIA 의 추론 최적화 글은 자리에 query head 수를 쓴 MHA 형태로 이 식을 적었다. GQA 와 MQA 에서는 key·value head 수로 바꾸면 되고, DeepSeek-V2 보고서의 Table 1 이 같은 식을 원소 수로 적었다.
Llama 3 로 직접 계산하기
Llama 3 논문 Table 3 의 설정으로 계산한다. head 길이는 hidden 크기를 query head 수로 나눈 값이다.
| 모델 | 층 | query head | key·value head | 토큰당 캐시 (BF16) | MHA 였다면 | |
|---|---|---|---|---|---|---|
| Llama 3 8B | 32 | 32 | 8 | 128 | B = 128 KiB | 512 KiB |
| Llama 3 70B | 80 | 64 | 8 | 128 | B = 320 KiB | 2.5 MiB |
캐시 크기는 문맥 길이와 동시 요청 수의 곱, 즉 캐시에 들고 있는 토큰 수에 비례한다. Llama 3 8B 로 그려 보면 다음과 같다.
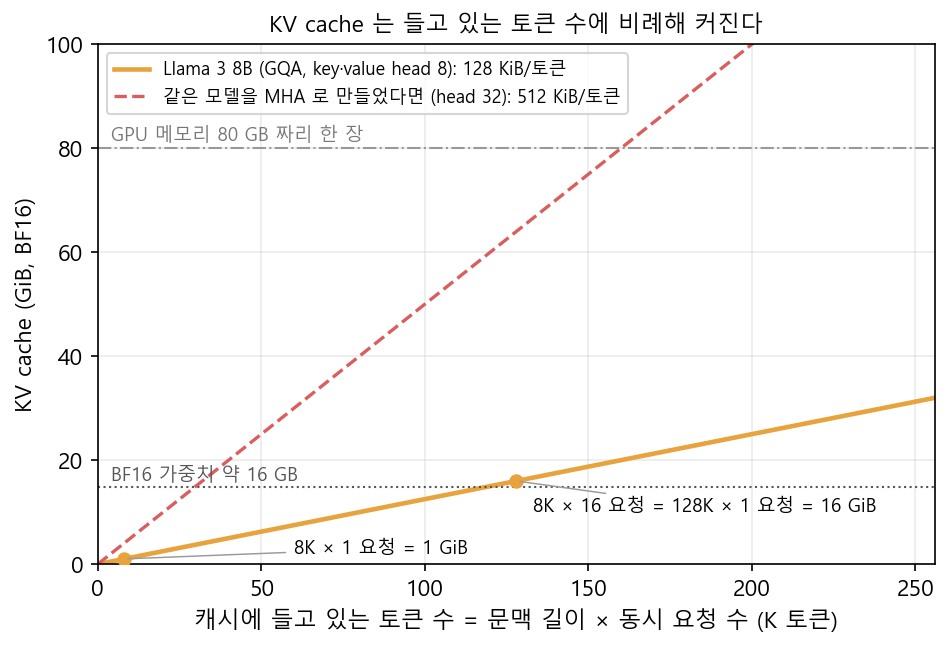
가로축은 캐시에 들고 있는 토큰 수, 세로축은 KV cache 크기다. 주황 실선이 실제 Llama 3 8B(토큰당 128 KiB)이고, 빨간 점선은 같은 모델을 key·value head 32 개짜리 MHA 로 만들었을 때(토큰당 512 KiB)다. 8K 문맥 요청 하나는 1 GiB 지만, 8K 요청 16 개를 동시에 받거나 128K 문맥 요청 하나를 받으면 16 GiB 가 된다. 128K 문맥은 같은 구조로 문맥을 늘린 Llama 3.1 8B 기준이다. 아래쪽 가로 점선이 BF16 가중치 약 16 GB(약 80 억 개 × 2 바이트)라서, 이 지점에서 캐시가 가중치만큼 커진다. MHA 였다면 그 4 분의 1 인 32K 토큰에서 이미 가중치만큼 커진다.
서빙에서 한 GPU 가 동시에 처리할 수 있는 요청 수는 대개 이 캐시가 정한다. Kwon et al. (2023, Figure 1) 은 A100 40GB 에서 13B 모델을 서빙할 때 메모리의 약 65% 가 가중치, 약 30% 가 KV cache 라고 적었다. GPU 메모리에서 가중치를 뺀 나머지를 로 나눈 만큼만 시퀀스를 담을 수 있다.
key·value head 를 8 개로 줄인 GQA 가 없었다면 같은 계산이 4 배(8B), 8 배(70B)로 커진다. 다음 절은 이 head 수를 어떻게 줄이는지를 비교한다.
MHA, GQA, MQA, MLA 의 토큰당 캐시 비교
Attention 노트가 각 방식의 원리를 설명한다. 여기서는 크기만 비교한다. 비교 조건을 같게 하려고 DeepSeek-V3 의 attention 크기(층 61 개, query head , head 길이 )를 고정하고 key·value 를 저장하는 방식만 바꿨다. 원소당 2 바이트로 가정했다.
| 방식 | 층 하나의 토큰당 원소 수 | 61 층 합계 | 바이트 (원소당 2 B) | MHA 대비 |
|---|---|---|---|---|
| MHA | 1,998,848 | 3.81 MiB | 100% | |
| GQA, 그룹 8 개 | 124,928 | 244 KiB | 6.25% | |
| MQA | 15,616 | 30.5 KiB | 0.78% | |
| MLA | 35,136 | 68.6 KiB | 1.76% |
| 기호 | 뜻 |
|---|---|
| GQA 의 그룹 수 = key·value head 수 | |
| MLA 가 key·value 를 함께 압축한 latent 벡터의 길이 | |
| MLA 에서 RoPE 위치 정보만 따로 담는 key 의 길이 |
MLA 의 캐시는 MQA 보다 크고 GQA-8 보다 훨씬 작다. DeepSeek-V2 보고서 (Table 1) 는 , 이므로 MLA 의 캐시가 로, 그룹이 2.25 개인 GQA 와 같다고 적었다. 캐시 크기만 보면 GQA 와 MQA 사이지만, 같은 보고서의 MoE 모델 비교(부록 D.2)에서 MLA 는 MHA 의 14%(약 16B 모델), 4%(약 250B 모델) 크기 캐시로 MHA 보다 좋은 성능을 냈다. 반면 GQA 와 MQA 는 원 논문들에서 MHA 와 비슷하거나 조금 낮은 품질을 보고했다 (Attention 노트).
Attention 최적화 기법이 캐시를 바꾸는 방식
기법마다 토큰당 크기 식에서 건드리는 항이 다르다. 캐시 크기는 그대로 두고 읽는 양이나 낭비만 줄이는 기법도 있다. 각 기법의 원리와 출처는 Attention 노트의 최적화 기법 절에 있다.
| 기법 | 바뀌는 항 | 캐시에 남는 것 | 크기 변화 |
|---|---|---|---|
| MQA, GQA | 그룹마다 key·value 한 벌 | 배로 준다 (Llama 3 8B 는 4 배) | |
| MLA | 전체 | 층마다 latent 512 + RoPE key 64 | 같은 크기 MHA 의 1.76% (위 비교표) |
| KV cache 양자화 | 같은 key·value 를 낮은 정밀도로 | FP8 이면 절반, 2 비트면 8 분의 1 (양자화 상수와 원래 정밀도로 남기는 최근 토큰은 제외한 계산) | |
| sliding window | 를 층마다 로 제한 | 최근 개 토큰. 고정 크기 버퍼에 돌려 가며 덮어쓴다 | Mistral 7B 는 , 32K 시퀀스에서 8 배 감소 (Jiang et al., 2023, 2절) |
| hybrid (linear attention·Mamba 층 + softmax attention 층) | 를 softmax attention 층 수로 | softmax attention 층의 key·value 와, 나머지 층의 고정 크기 상태 | Jamba(8 층 중 1 층만 attention): 256K 문맥에서 4 GB, Mixtral 은 32 GB (Lieber et al., 2024, Table 1) |
| NSA, DSA | 없음 | 모든 토큰의 key·value. DSA 는 indexer 의 key 가 추가된다 | 줄지 않는다. decode 한 스텝에서 읽는 양이 준다 |
| PagedAttention | 없음 | 같은 내용을 16 토큰 블록에 나눠 담는다 | 토큰당 크기는 그대로. 미리 잡아 두고 안 쓰는 메모리가 사라져 같은 GPU 에 더 많은 요청이 들어간다 |
| FlashAttention, Flash-Decoding | 없음 | 같다 | 같다. 캐시를 읽는 커널이 빨라진다 |
마지막 세 줄처럼 캐시 크기가 그대로인 기법도 decode 를 빠르게 한다. decode 의 비용은 캐시의 크기 자체가 아니라 한 스텝에 메모리에서 읽는 바이트와, 한 번에 담을 수 있는 요청 수가 정하기 때문이다.
PagedAttention 의 효과는 vllm 노트에 더 있다. Kwon et al. (2023, Figure 2) 의 측정에서 기존 시스템은 KV cache 용 메모리의 20.4–38.2% 에만 실제 토큰의 key·value 를 담았고, vLLM 은 96.3% 를 담았다. 같은 prompt 에서 여러 답변을 뽑을 때는 공통 앞부분 블록을 함께 쓴다.
References
- Attention — query·key·value, causal mask, 최적화 기법의 원리
- Prefill, vllm
- Llama Team, Meta, 2024, The Llama 3 Herd of Models — Table 3
- DeepSeek-AI, 2024, DeepSeek-V2 — Table 1, 부록 D.2
- DeepSeek-AI, 2024, DeepSeek-V3 Technical Report — 4.2절 설정
- NVIDIA, 2023, Mastering LLM Techniques: Inference Optimization — “LLM memory requirement”
- Agrawal et al., 2024, Sarathi-Serve
- Zhong et al., 2024, DistServe
- Kwon et al., 2023, Efficient Memory Management for Large Language Model Serving with PagedAttention
- Jiang et al., 2023, Mistral 7B
- Lieber et al., 2024, Jamba: A Hybrid Transformer-Mamba Language Model