검색 랭킹 서버에 요청이 초당 수백 건씩 들어온다고 하자. 요청 하나는 검색어 하나와 후보 상품 수백 개이고, 서버는 GPU 위의 랭킹 모델로 후보마다 점수를 낸다.
- 요청이 오는 대로 하나씩 GPU 에 보내면, GPU 는 매번 작은 일만 하고 대부분 시간을 논다.
- 요청 몇 개를 모아 한 번에 보내면, 비슷한 시간에 여러 요청을 처리한다.
- 대신 모으려고 기다리는 시간만큼 응답이 늦어진다.
동적 배치 (Dynamic Batching) 는 서버가 요청을 짧게 모아 묶되, 기다리는 시간에 상한을 두는 방식이다. 추론 최적화 전체에서의 자리는 Inference Optimization 에 있다.
묶으면 빨라지는 이유
GPU 는 큰 행렬 곱을 한 번에 할 때 효율이 나는데, 요청 하나로는 그만큼 일이 안 된다.
- GPU 에는 동시에 도는 연산 장치가 수천 개 있다. 후보 몇백 개짜리 요청 하나로는 이 장치를 다 채우지 못한다.
- 모델의 weight 를 메모리에서 읽어 오는 비용은 배치 크기와 상관없이 한 번 든다. 요청 여러 개를 묶으면 이 비용을 나눠 낸다.
- 그래서 배치가 작은 구간에서는 요청 1 개를 처리하는 시간과 4 개를 묶어 처리하는 시간이 거의 비슷하다. 같은 시간에 4 배를 처리하는 셈이다.
배치를 계속 키운다고 계속 빨라지지는 않는다.
- GPU 연산 장치가 다 차면, 그 뒤로는 배치를 키운 만큼 실행 시간도 같이 늘어난다.
- 배치가 너무 크면 GPU 메모리가 모자란다.
정적 배치와 동적 배치
정적 배치는 정해진 개수가 찰 때까지 기다리고, 동적 배치는 개수나 시간 중 먼저 닿는 쪽에서 실행한다.
- 정적 배치 (static batching): 배치 크기를 정해 두고 그만큼 모일 때까지 기다린다. 요청이 적은 시간대에는 개수가 찰 때까지 계속 기다리므로 실시간 서빙에는 맞지 않다. 미리 모아 둔 데이터를 한꺼번에 처리하는 오프라인 추론 (batch inference) 에서 쓴다.
- 동적 배치 (dynamic batching): 서버가 도착한 요청을 대기열에 모은다. 최대 배치 크기만큼 모이거나, 첫 요청이 최대 대기 시간만큼 기다렸으면, 그때까지 모인 요청을 묶어 실행한다.
아래 그림은 최대 배치 크기 4, 최대 대기 시간 2 ms 인 동적 배치가 두 경우에 언제 실행되는지 보여 준다. 주황 점은 요청이 도착한 시각이고, 회색 띠는 첫 요청부터 2 ms 동안의 대기 구간이다.
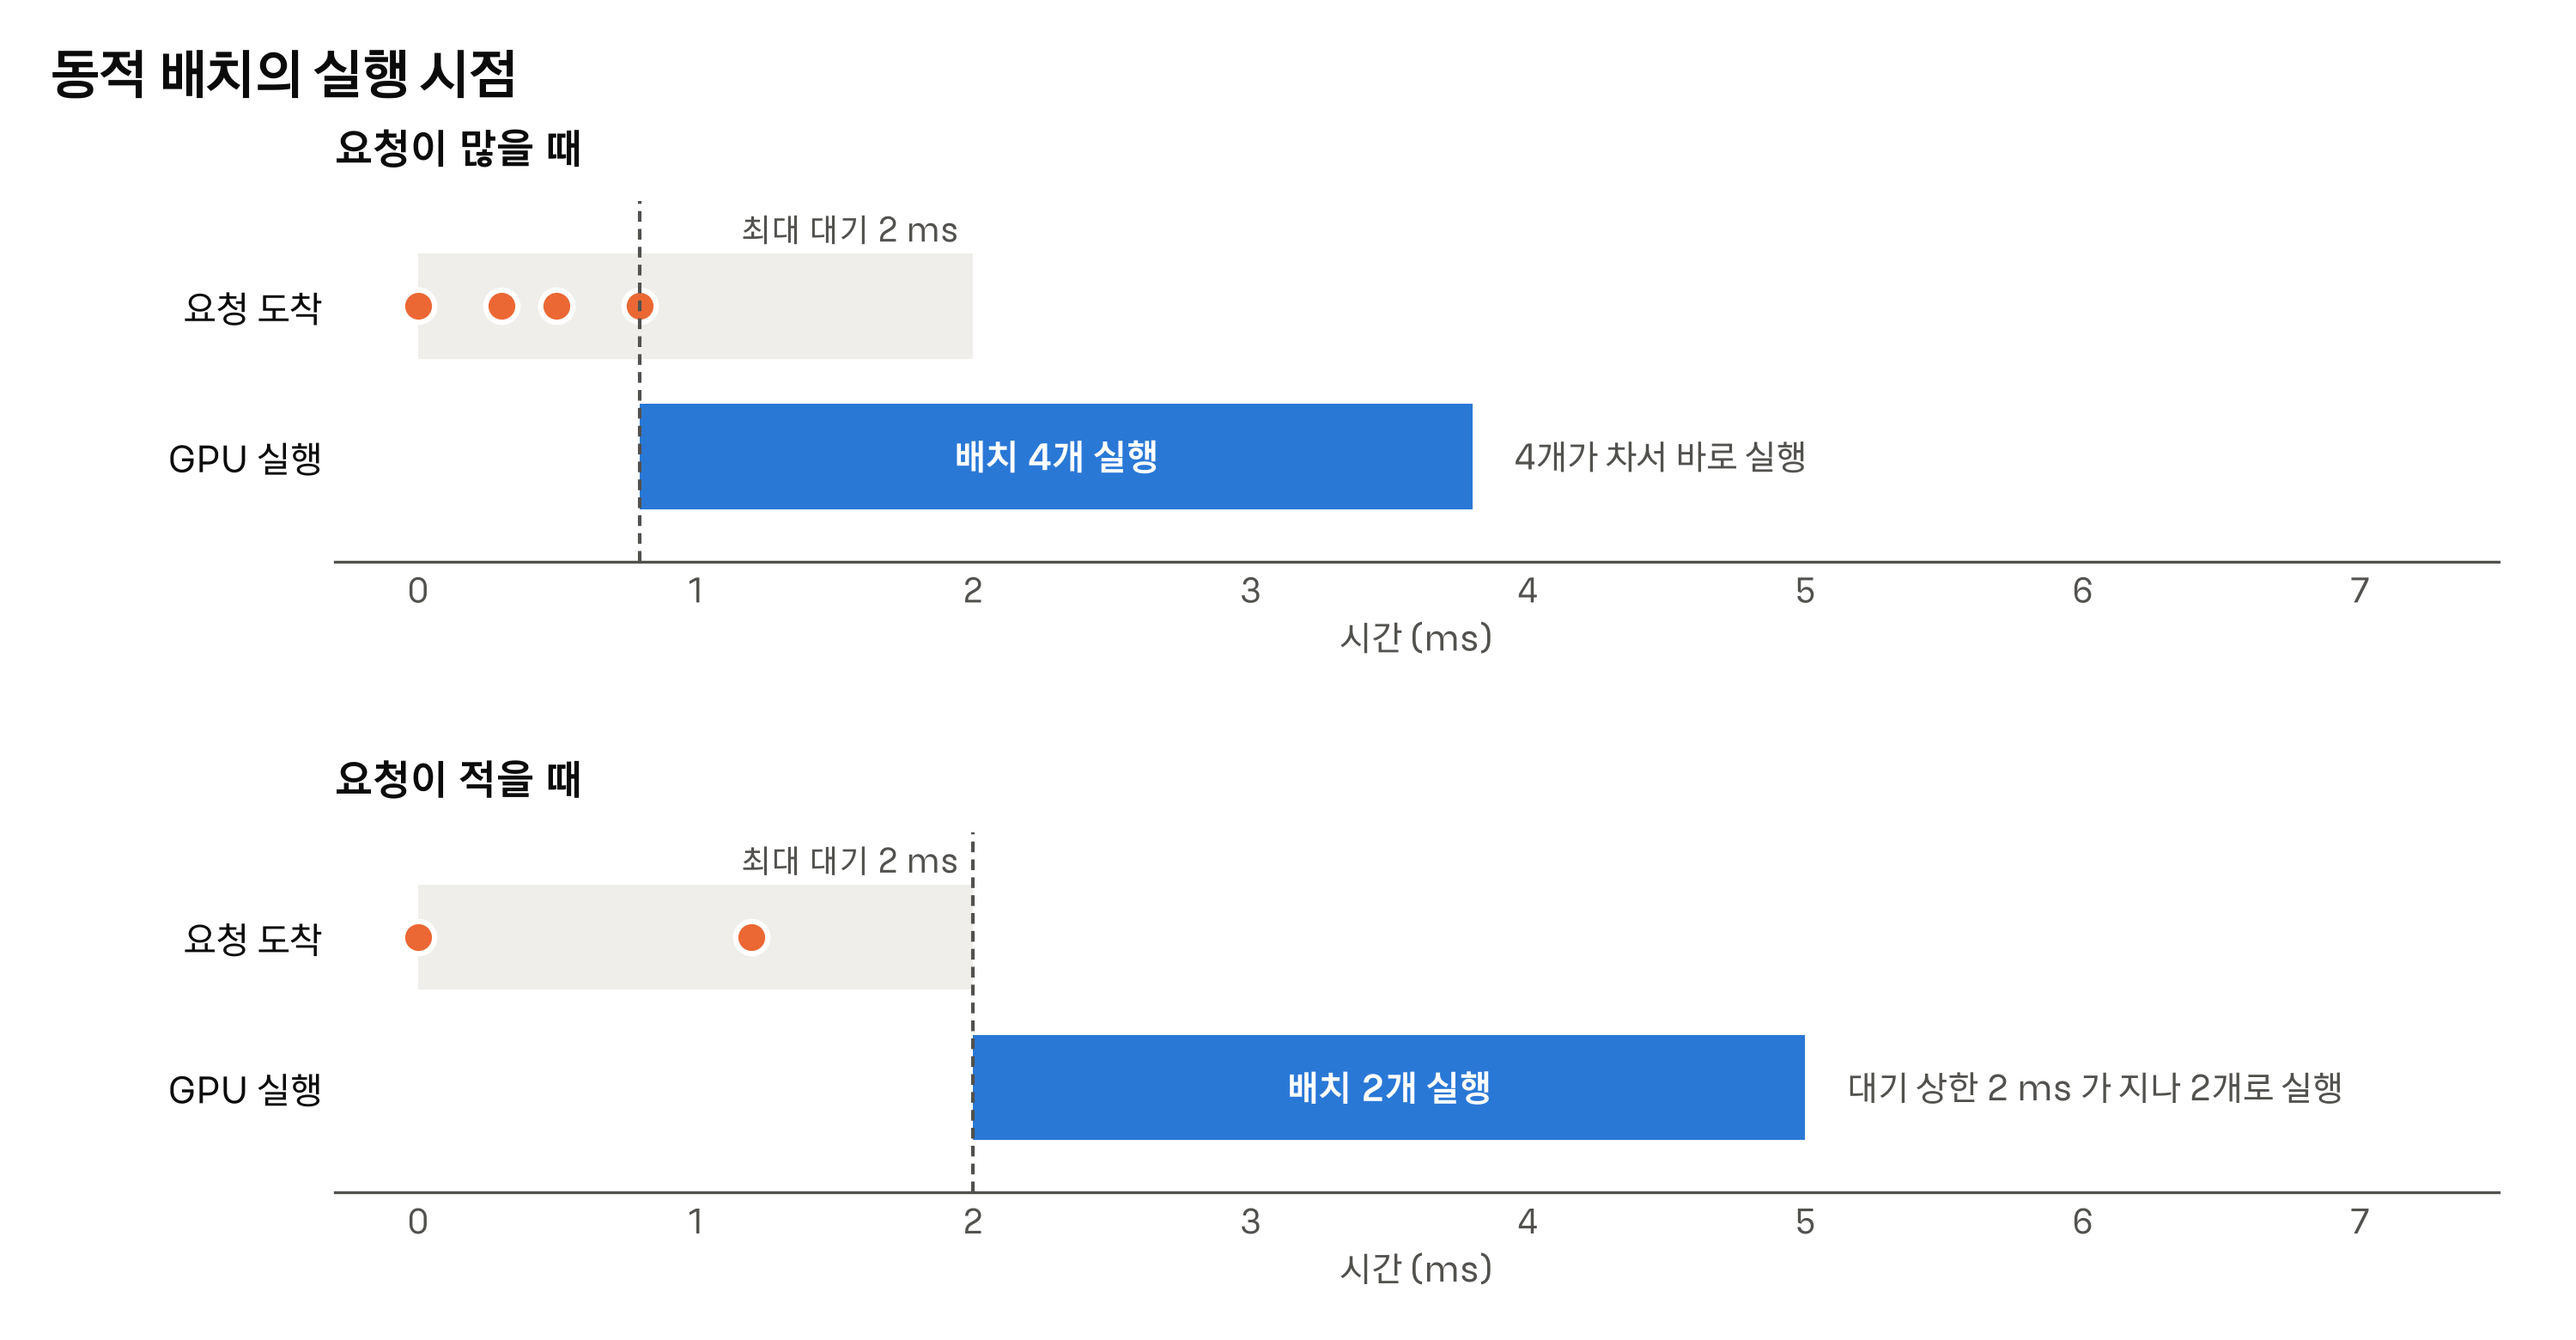
- 요청이 많을 때는 0.8 ms 만에 4 개가 차서 바로 실행한다. 기다리는 시간이 거의 없다.
- 요청이 적을 때는 2 ms 동안 2 개만 모인다. 상한에 닿아 2 개로 실행한다.
- 두 경우 모두 실행 시간은 3 ms 로 같다. 배치가 작은 구간이라 개수가 달라도 시간이 비슷하다.
대기 시간 상한과 처리량
대기 시간 상한을 늘리면 배치가 커져 처리량이 오르지만, 요청마다 그만큼 응답이 늦어질 수 있다.
- 요청의 응답 시간은 대기열에서 기다린 시간과 GPU 실행 시간을 더한 값이다.
- 요청이 많은 시간대에는 상한에 닿기 전에 배치가 차서, 상한을 늘려도 응답 시간은 거의 그대로다.
- 요청이 적은 시간대에는 매번 상한만큼 기다리므로, 상한이 곧 응답 시간에 더해진다.
그래서 상한은 응답 예산에서 거꾸로 정한다.
- 랭킹 모델 몫이 30 ms 이고 실행에 10 ms 가 든다면, 대기에 쓸 수 있는 몫은 그 차이 안에서 정한다.
- 상한을 몇 가지로 바꿔 가며 요청을 흘려 보고, p99 응답 시간이 예산 안에 드는 가장 큰 값을 고른다.
최대 배치 크기는 GPU 메모리와 실행 시간이 정한다.
- 배치가 크면 한 번 실행하는 시간도 길어진다. 실행 시간만으로 예산을 넘으면 안 된다.
- TensorRT 엔진처럼 특정 배치 크기에서 가장 빠르게 만들어진 모델은, 그 크기를 우선 채우도록 설정하기도 한다.
입력 길이가 요청마다 다르면 묶을 때 빈 자리가 생긴다.
- 랭킹 모델은 후보 하나가 한 행이라, 요청 여러 개의 후보를 그대로 이어 붙여 한 배치로 만들 수 있다.
- 문장처럼 길이가 다른 입력은 가장 긴 것에 맞춰 나머지를 빈 값으로 채워야 한다 (padding). 채운 자리도 계산되므로 길이가 많이 다르면 낭비가 크다.
continuous batching (LLM 서빙)
LLM 은 토큰을 하나씩 생성하고 요청마다 끝나는 시점이 달라서, 한 번 묶은 배치를 끝까지 유지하면 자리가 빈다.
- 랭킹 모델은 forward 한 번이면 점수가 나온다. LLM 은 답변 길이만큼 forward 를 반복한다.
- 요청 넷을 묶어 시작하면, 3 토큰만에 끝난 요청의 자리는 8 토큰짜리 요청이 끝날 때까지 빈 채로 돈다.
- continuous batching 은 매 토큰 단계마다 끝난 요청을 빼고 대기 중인 요청을 그 자리에 넣는다. Orca 논문 (2022) 이 제안했고, vLLM 같은 LLM 서빙 엔진이 기본으로 쓴다.
아래 그림은 출력 길이가 다른 요청 7 개 (괄호 안이 토큰 수) 를 자리 4 개로 처리한 결과다. 빗금은 요청이 먼저 끝나 비어 있는 자리다.
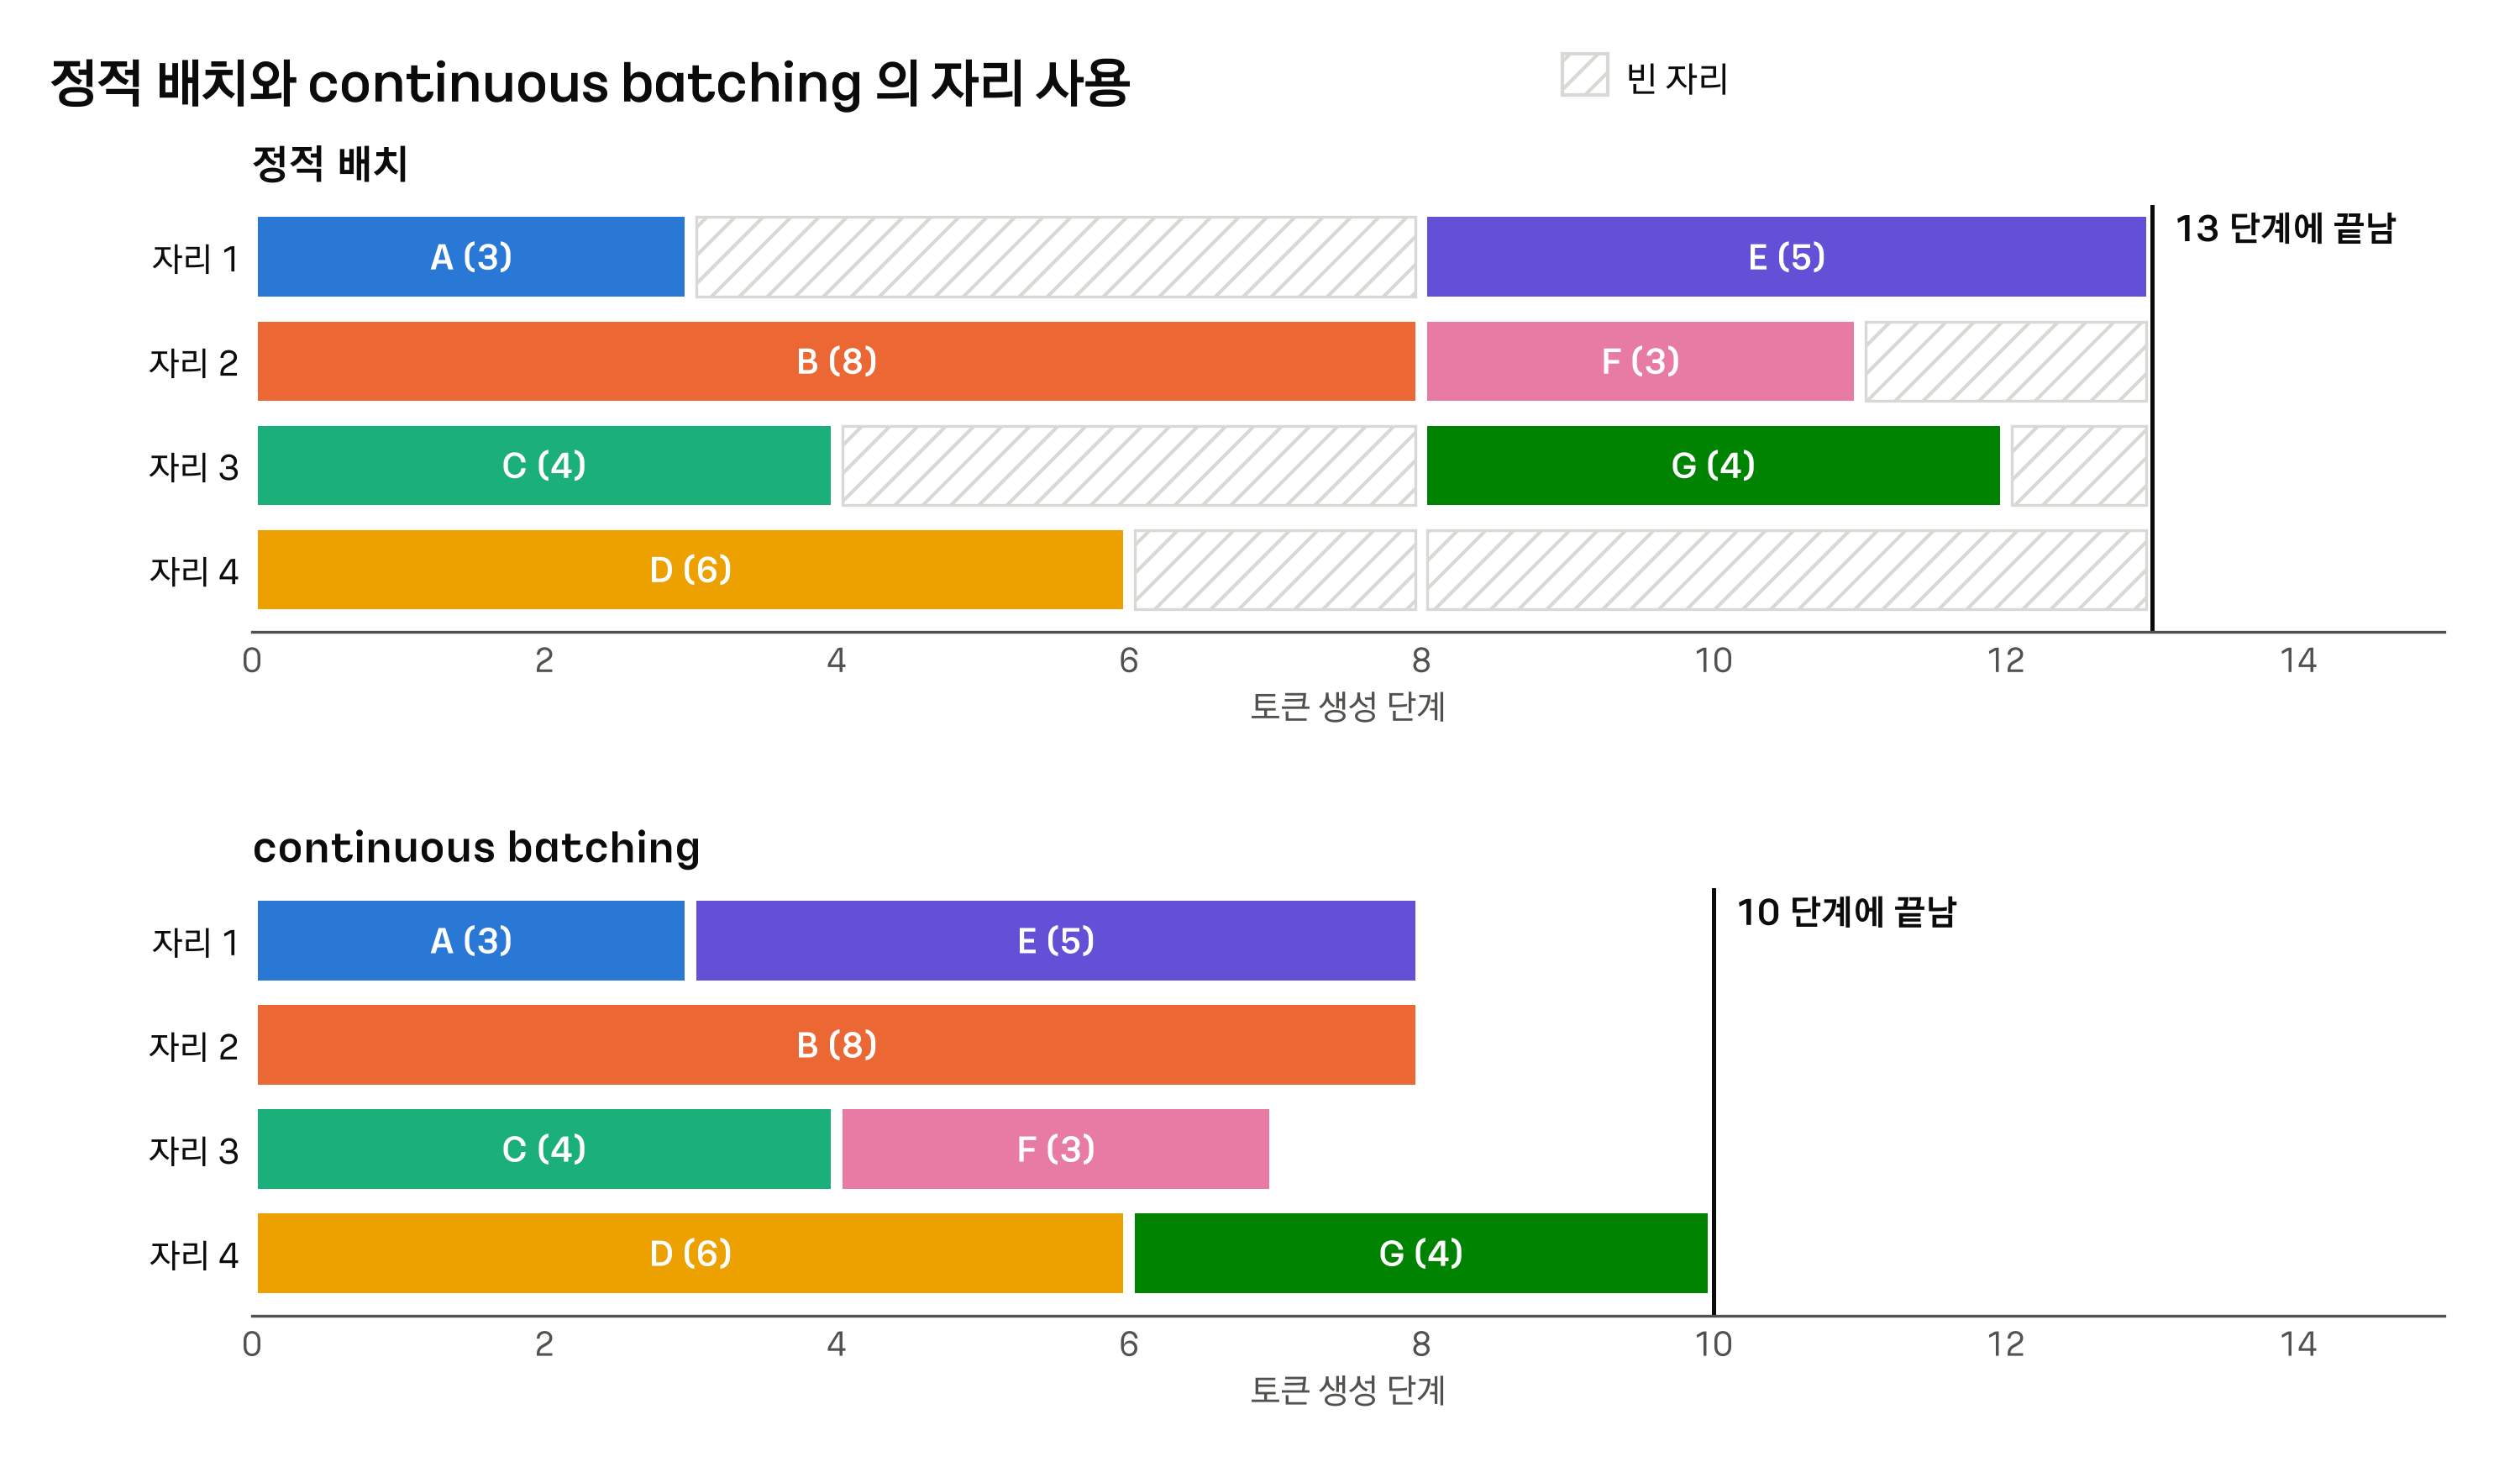
- 정적 배치는 A · B · C · D 가 모두 끝나야 다음 묶음을 시작해서 13 단계가 걸린다.
- continuous batching 은 A 가 끝난 자리에 바로 E 를 넣어 10 단계에 끝난다.
- 실제로는 새 요청을 넣을 때 입력 문장 전체를 처음 계산하는 단계 (Prefill) 가 붙고, 요청마다 KV Cache 메모리가 필요해서 이 둘을 같이 관리한다.
서빙 서버
직접 대기열을 짜지 않고 서빙 서버의 설정으로 동적 배치를 켠다.
- Triton Inference Server: 모델 설정에 dynamic batching 을 켜고 최대 대기 시간과 우선 채울 배치 크기를 적는다.
- TorchServe: 모델을 등록할 때 배치 크기와 최대 대기 시간을 준다.
- vLLM · TGI · TensorRT-LLM: LLM 용 서빙 엔진으로 continuous batching 을 기본으로 쓴다.
부록: 설정 예
Triton 의 config.pbtxt 에서 최대 배치 8, 우선 채울 크기 4 · 8, 최대 대기 2 ms 로 두면 다음과 같다.
max_batch_size: 8
dynamic_batching {
  preferred_batch_size: [ 4, 8 ]
  max_queue_delay_microseconds: 2000
}
TorchServe 는 모델 등록 API 의 batch_size 와 max_batch_delay (ms) 로 같은 것을 정한다.