support 값은 그 itemset 이 얼마나 데이터베이스에 자주 등장하는지 나타내는 지표다.
itemset 에 대한 의 support 는 를 포함한 transactions 의 비율에 비례한다.
예시
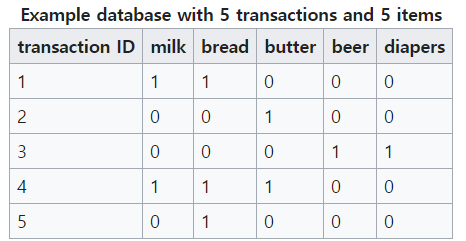
itemset 의 support 값은 0.2 (=1/5) 이다. 왜냐하면 오직 5 개의 transactions 중 만 해당 itemset 을 포함하기 때문이다.
이러한 많은 경우의 수를 효율적으로 고려하기 위해서 support 값의 downward-closure 속성을 활용한다.
itemset 에 포함되는 item 의 개수를 한개부터 늘려가면서 최소 support 값 이상을 가지지 못하는 후보들은 제외한다.
support
한 itemset 이 어떤 transaction 에 속해있는지 (TID) 나타내는 테이블을 생성 테이블에서 minimum support 값을 만족하는 itemset 만을 남겨두고, 같은 테이블 내의 다른 itemset 에 대한 TID 간 교집합을 계산한다. 이후, 다시 minimum support 값 이상인 itemset ...
...총 세가지 방식이 존재한다. (1) Macro Average 가장 단순 방식으로, 모든 클래스 당 F1-score 의 평균을 의미한다. (2) Weighted Average 각 class의 support, 즉 실제 샘플 수로 F1-score를 가중 평균한다. 다수 클래스가 더 큰 비중을 차지하므로 소수 클래스의 낮은 성능이 가려질 수 있다. (3) Micro Average Micro 평균 ...
Confidence 에서 분모에 support 값을 추가한 것과 같다. 예시
연관 규칙 학습은 데이터베이스에 존재하는 변수들 간의 연관성을 발견하는 방법 이다. 여기서, 연관 규칙들은 일반적으로 사용자가 정의한 최소 support 값과 최소 machine learning/metrics/Confidence 값을 동시에 만족시킬 수 있는 규칙을 의미한다.
BFS 방식을 사용해서 itemset 의 support 값을 계산하고, Anti-Monotone property 를 활용해 후보들을 생성해나가는 방법이다. itemset 에 포함되는 item 의 개수를 한개부터 늘려가면서 최소 support 값 이상을 가지지 못하는 후보들은 제외한다. 예시
이것은 어떤 itemset 이 frequent 하지 않으면, 해당 itemset 을 포함하는 모든 superset(초집합) 도 frequent 하지 않다 (infrequent) 는 특성을 의미한다.
lift 규칙은 다음과 같이 정의된다.
배경 To remedy the selection bias in evaluation, some recent work considers a recommendation as an intervention analogous to treating a patient with a specific drug. In both...
FP-growth algorithm 알고리즘은 FP-tree 를 이용한다.
Exposure bias 는 사용자가 모든 item 을 본 것이 아니라, 노출된 item 에 대해서만 feedback 을 남긴다는 데서 생기는 bias 다. 특히 implicit feedback 에서는 관측되지 않은 item 을 negative 로 단순 처리하면 실제로 싫어한 것인지, 그냥 노출되지 않은 것인지...
inter diversity: 유저 간 추천 결과가 다른것 inner diversity: 추천 결과 내 아이템의 성격이 다른 것 연관 추천에서 강아지 영상을 한번 봤는데, 추천 결과가 모두 강아지와 관련된 영상이면 inner diversity 가 낮다고 할 수 있다.
추천 시스템에서 발생할 수 있는 문제점들
추천 시스템에 관련된 github repo 를 정리하는 page