한줄 요약
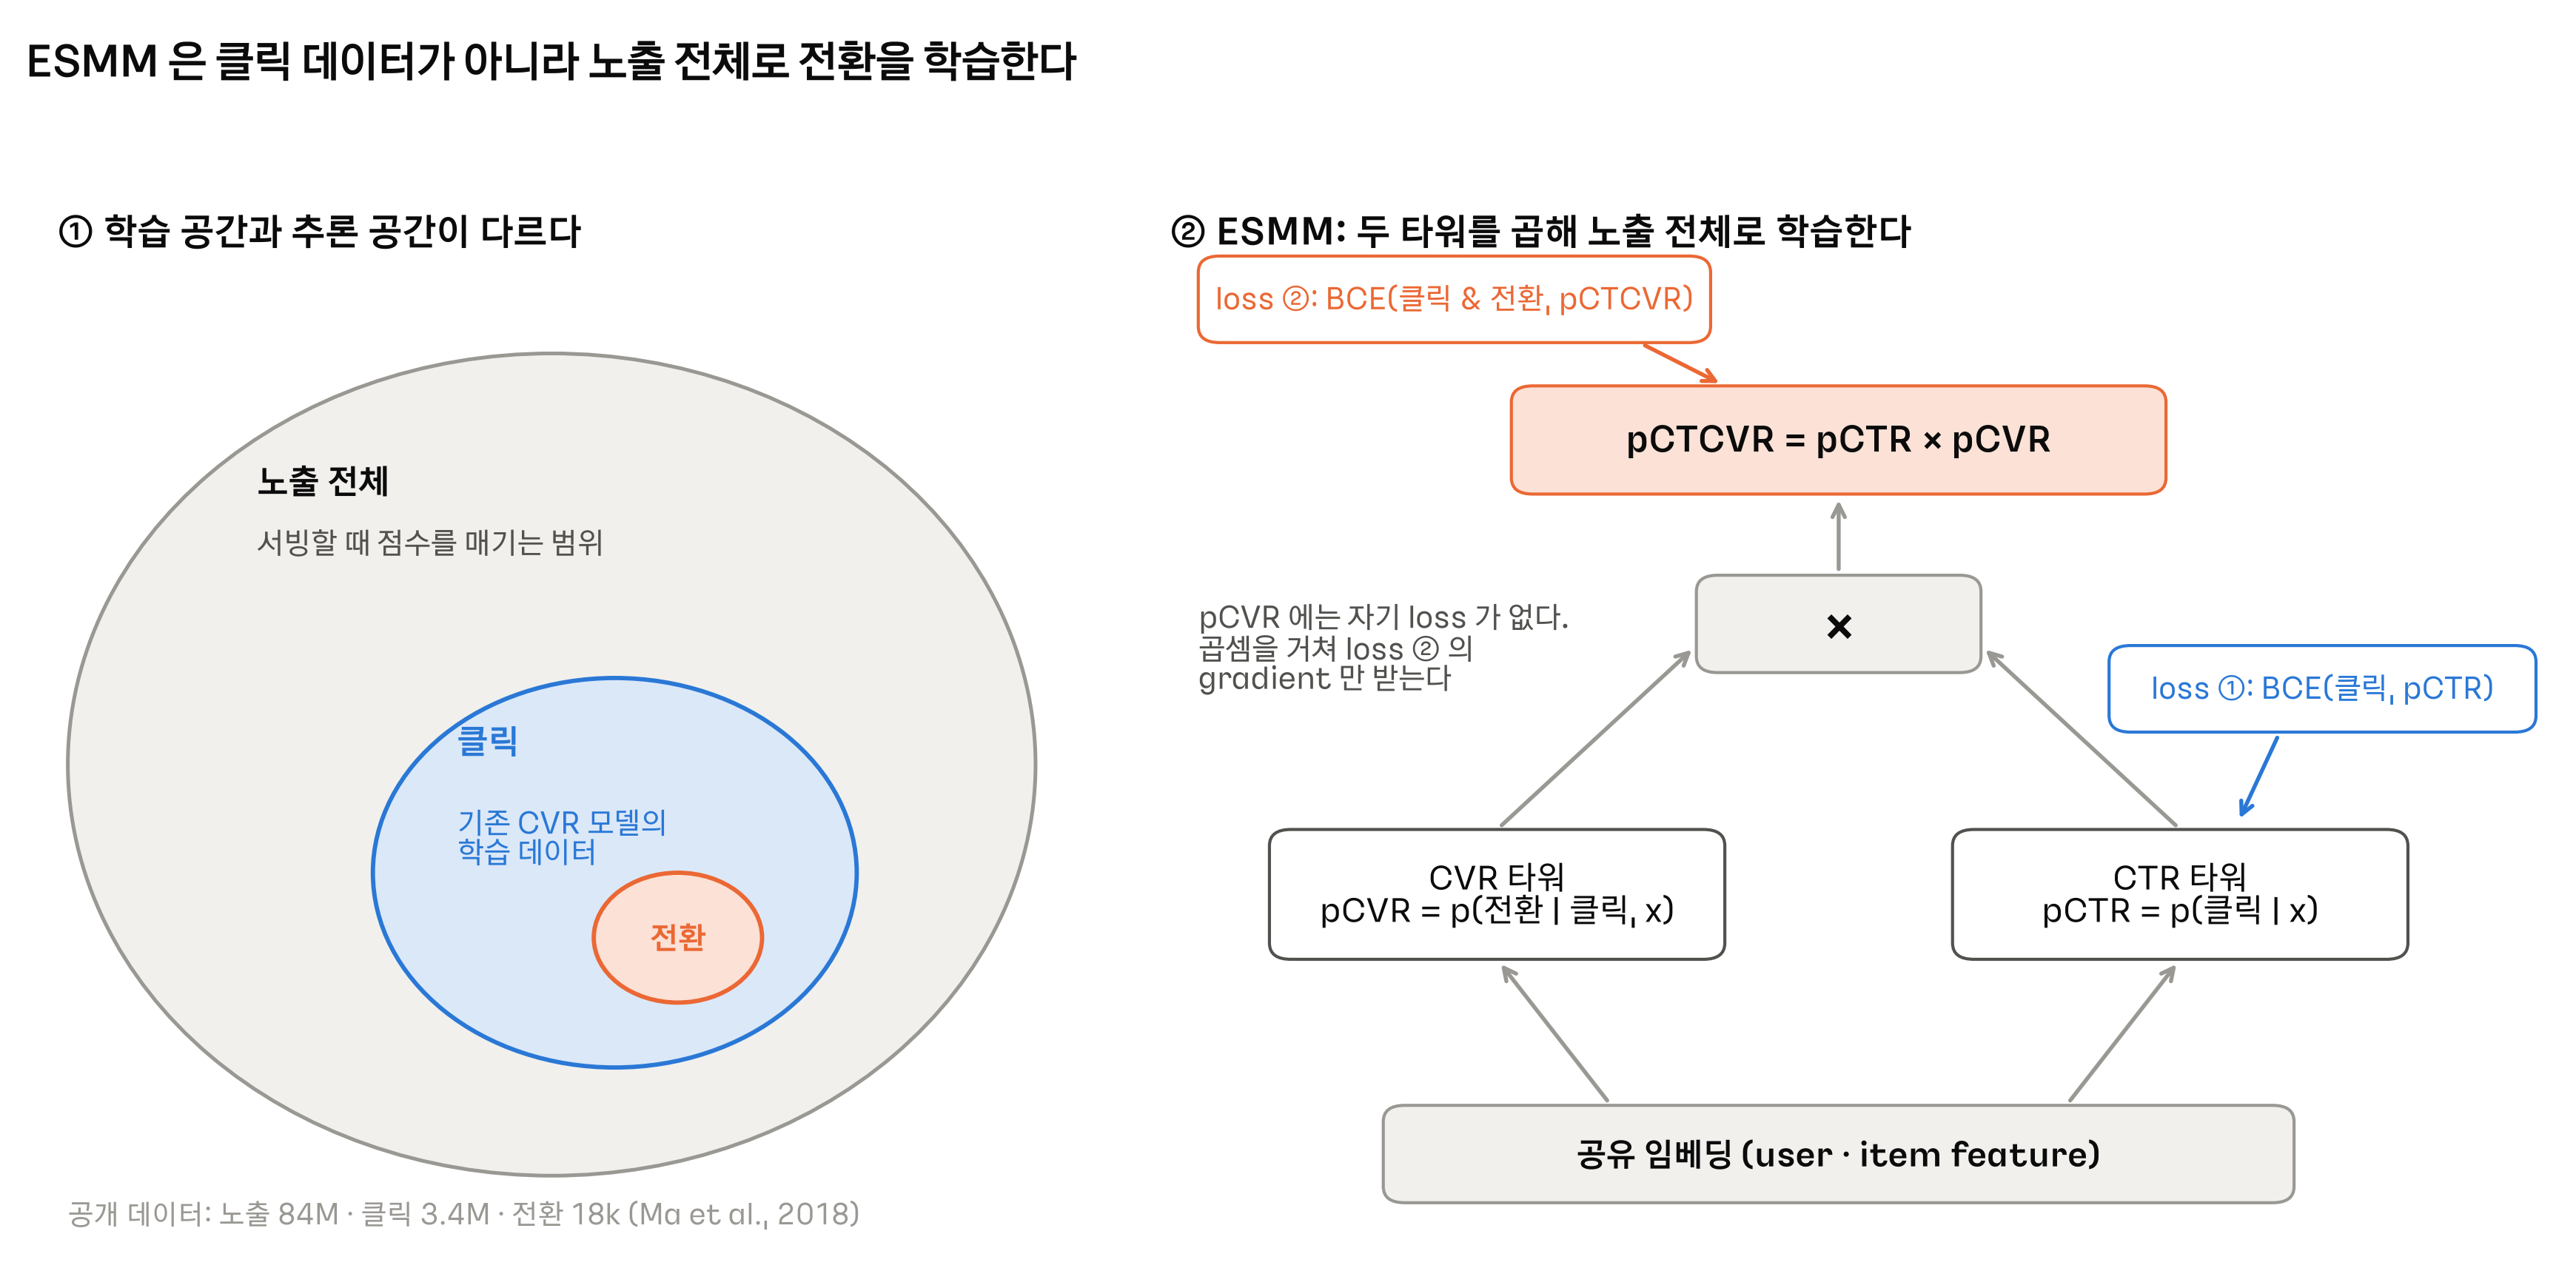
클릭한 사례로만 학습하던 전환율(CVR) 모델을, 노출 전체로 학습하도록 바꾼 Alibaba 의 SIGIR 2018 논문이다. 클릭 확률 pCTR 과 클릭 후 전환 확률 pCVR 을 각각 내는 두 타워를 두고, 둘을 곱한 pCTCVR(노출 → 클릭 → 전환 확률)에 loss 를 건다. pCVR 에는 자기 loss 가 없고 곱셈을 거쳐서만 학습된다.
- 저자: Xiao Ma, Liqin Zhao, Guan Huang, Zhi Wang, Zelin Hu, Xiaoqiang Zhu, Kun Gai (Alibaba)
- 데이터: 타오바오 추천 로그 89 억 건. 1% 표본을 공개 데이터(Ali-CCP)로 냈다
전체 구조
사용자 행동은 노출 → 클릭 → 전환 순서로 일어난다. 전환은 클릭한 뒤에만 생긴다. 이 순서 때문에 세 확률 사이에는 다음 관계가 있다 (논문 Eq 1).
| 기호 | 의미 |
|---|---|
| 노출 하나의 feature (사용자, 상품, 맥락) | |
| 클릭했으면 1 | |
| 전환(구매)했으면 1. 이면 항상 이다 | |
| pCTR | 노출됐을 때 클릭할 확률 |
| pCVR | 클릭했을 때 전환할 확률. 이 논문이 추정하려는 값 |
| pCTCVR | 노출됐을 때 클릭하고 전환까지 할 확률 |
ESMM 은 이 식을 모델 구조로 그대로 옮긴다.
배경 지식
추천 · 광고는 보통 클릭률만으로 순서를 정하지 않는다. 클릭은 많이 받는데 구매로 이어지지 않는 상품이 위에 오면 매출이 줄기 때문이다. 그래서 전환율도 함께 예측해 처럼 섞는다. 광고에서는 oCPC(optimized cost-per-click)처럼 클릭당 입찰가를 전환 가능성에 맞춰 조정하는 데 pCVR 을 쓴다.
여기서 pCVR 은 “클릭했다는 조건에서” 의 전환 확률이다. 조건이 붙은 확률이라 학습 데이터도 자연스럽게 클릭한 사례로만 모으게 되는데, 이 지점에서 문제가 생긴다.
기존 방법의 한계
Sample selection bias
기존 CVR 모델은 클릭한 노출로만 학습하고, 서빙할 때는 노출 후보 전체에 점수를 매긴다. 학습 공간이 추론 공간의 일부일 뿐이다.
클릭은 사용자가 이미 끌린 상품에서 일어난다. 그래서 학습 데이터에는 끌리는 상품만 남고, 사용자가 거의 누르지 않는 상품은 학습 데이터에 거의 없다. 서빙에서는 그런 상품에도 pCVR 을 매겨야 하는데, 모델은 그 영역을 본 적이 없어 값을 믿기 어렵다. 이것을 sample selection bias 라고 한다.
Data sparsity
전환 라벨은 클릭보다 훨씬 드물다. 공개 데이터에서 노출 8,400 만 건 중 클릭이 340 만 건, 전환이 1.8 만 건이다. CVR 모델의 학습 데이터(클릭)는 CTR 모델의 학습 데이터(노출)의 4% 에 불과하다. 상품 · 사용자 ID 임베딩처럼 파라미터가 많은 부분을 이 데이터만으로 학습하기 어렵다.
나눗셈 방식의 불안정
Eq 1 을 뒤집으면 이다. CTR 모델과 CTCVR 모델을 노출 전체로 따로 학습하고 나누면 sample selection bias 는 피할 수 있다. 논문은 이것을 DIVISION 으로 부르며 비교 대상에 넣었다. 하지만 pCTR 은 작은 값이라 나누면 수치가 불안정하고, 결과가 1 을 넘을 수도 있다.
제안 방법
곱셈 구조로 노출 전체 학습
ESMM 은 CVR 타워와 CTR 타워를 두고, 두 출력을 곱해 pCTCVR 을 만든다. loss 는 노출 전체에 대해 두 개를 더한다 (논문 Eq 3).
| 기호 | 의미 |
|---|---|
| 노출 전체의 수 | |
| binary cross-entropy | |
| CTR 타워의 출력 pCTR | |
| CVR 타워의 출력 pCVR | |
| 클릭하고 전환까지 했으면 1, 아니면 0 |
두 loss 모두 노출 전체에서 계산한다. 클릭하지 않은 노출도 두 번째 loss 에 라벨 0 으로 들어간다. pCVR 에 직접 걸린 loss 는 없다. pCVR 은 pCTCVR 을 맞추기 위한 중간값으로만 학습되고, 곱셈을 거쳐 두 번째 loss 의 gradient 를 받는다.
이렇게 하면 pCVR 이 노출 전체에서 정의된다. 서빙할 때는 CVR 타워의 출력을 그대로 꺼내 쓴다. 이 출력은 sigmoid 를 거치므로 DIVISION 과 달리 1 을 넘지 않는다. pCTCVR 은 pCTR 에 1 이하의 값을 곱한 것이라, pCTCVR ≤ pCTR 이라는 관계도 저절로 지켜진다.
임베딩 공유
두 타워는 같은 임베딩 테이블을 쓴다. 임베딩은 파라미터 대부분을 차지하는데, CTR 쪽은 노출 전체라는 많은 데이터로 학습된다. CVR 타워는 이 임베딩을 함께 쓰면서 전환 라벨이 적은 문제를 덜어 낸다. multi-task learning 의 hard parameter sharing 과 같은 방식이다.
타워 자체는 기존 BASE 모델과 같은 Embedding & MLP 구조다. 논문은 이 자리에 다른 CTR 모델 구조를 넣어도 된다고 밝힌다.
벤치마크 · 데이터셋
| 데이터 | 사용자 | 상품 | 노출 | 클릭 | 전환 |
|---|---|---|---|---|---|
| Public Dataset | 0.4M | 4.3M | 84M | 3.4M | 18k |
| Product Dataset | 48M | 23.5M | 8,950M | 324M | 1,774k |
시간 순서로 앞 절반을 학습, 뒤 절반을 테스트에 쓴다. 평가는 두 가지 과제로 나눈다.
- CVR 과제: 클릭한 노출에서 pCVR 의 AUC. 기존 방식과 같은 조건이다
- CTCVR 과제: 노출 전체에서 pCTR × pCVR 의 AUC. pCTR 은 모든 모델이 같은 CTR 네트워크를 쓰고, pCVR 만 모델마다 다르다. sample selection bias 의 영향을 보는 과제다
모든 모델은 임베딩 차원 18, MLP 360 × 200 × 80 × 2, ReLU, Adam 으로 같은 설정을 쓰고, 10 번 반복한 평균을 보고한다.
실험 결과
Public Dataset 결과다 (논문 Table 2, AUC %).
| 모델 | 방식 | CVR 과제 | CTCVR 과제 |
|---|---|---|---|
| BASE | 클릭 데이터로 CVR 직접 학습 | 66.00 | 62.07 |
| AMAN | 클릭 안 한 노출을 일부 음성으로 섞음 | 65.21 | 63.53 |
| OVERSAMPLING | 전환 사례를 복제 | 67.18 | 63.05 |
| UNBIAS | rejection sampling 으로 분포 보정 | 66.65 | 63.56 |
| DIVISION | pCTCVR / pCTR | 67.56 | 63.62 |
| ESMM-NS | ESMM 에서 임베딩 공유만 뺌 | 68.25 | 64.44 |
| ESMM | 곱셈 구조 + 임베딩 공유 | 68.56 | 65.32 |
결과에서 읽을 수 있는 것은 셋이다.
- 노출 전체로 학습한 효과가 가장 크다: DIVISION, ESMM-NS, ESMM 셋 다 BASE 보다 좋다. 셋 다 pCVR 을 노출 전체에서 정의하는 방식이다.
- 곱셈이 나눗셈보다 낫다: 같은 아이디어인데 ESMM-NS 가 DIVISION 보다 좋다. 논문은 작은 pCTR 로 나눌 때의 수치 불안정을 이유로 든다.
- 임베딩 공유가 더한다: ESMM 이 ESMM-NS 보다 CTCVR 과제에서 0.88 높다.
Product Dataset 에서도 ESMM 은 BASE 대비 CVR 과제 AUC +2.18, CTCVR 과제 +2.32 를 보였다. 학습 데이터를 1% 부터 100% 까지 늘린 실험에서도 모든 비율에서 가장 높았다.
실무적 시사점
- 단계가 더 많은 퍼널로 늘릴 수 있다: 노출 → 클릭 → 장바구니 → 구매처럼 단계가 이어지면, 단계마다 타워를 두고 확률을 차례로 곱해 간다. 각 단계의 조건부 확률이 모두 노출 전체에서 정의된다.
- pCVR 은 직접 감독받지 않는다: CVR 타워의 출력이 실제 조건부 전환율과 맞는지는 따로 확인해야 한다. 입찰가 계산에 쓴다면 probability calibration 을 점검한다.
- 전환 지연은 다루지 않는다: 클릭 뒤 며칠 지나 일어나는 전환은 학습 시점에 음성으로 잡힌다. 논문도 이 문제(delayed feedback, Chapelle 2014)는 범위 밖이라고 밝힌다.