Llama 3 8B 로 8K 토큰짜리 대화 16 개를 동시에 처리한다고 하자. 모델 가중치가 약 16 GB 인데, 대화마다 쌓이는 KV Cache 도 합쳐서 16 GiB 다. 문맥을 128K 로 늘리면 캐시는 16 배가 되고, attention 점수 계산은 길이의 제곱으로 늘어난다.
attention 최적화 기법은 이 비용을 줄인다. 같은 “빠르게 한다” 라도 기법마다 줄이는 대상이 다르고, 효과가 나는 단계도 다르다. attention 계산 자체는 Attention 노트에 있다.
줄이는 대상: 연산량, 메모리 IO, KV cache 크기
attention 의 비용은 세 가지로 나눠 볼 수 있다.
- 연산량: 곱셈·덧셈 횟수(FLOPs)다. 점수 행렬이 칸이라 길이의 제곱으로 는다.
- 메모리 IO: GPU 의 큰 메모리와 연산 장치 사이를 오가는 바이트 수다. 점수 행렬이나 KV cache 를 메모리에 쓰고 다시 읽을 때 생긴다.
- KV cache 크기: 생성하는 동안 메모리에 붙잡아 두는 용량이다. 토큰 수 × 층 수 × key·value head 수에 비례한다.
GPU 메모리는 크고 느린 HBM 과 작고 빠른 SRAM 으로 나뉜다.
- HBM(high bandwidth memory)은 GPU 의 주 메모리로, 모델 가중치와 KV cache 가 여기 있다. A100 은 40–80 GB 에 대역폭 1.5–2.0 TB/s 다.
- 연산 장치 바로 옆의 SRAM 은 연산 블록 하나에 192 KB 뿐이지만 대역폭이 약 19 TB/s 로 10 배쯤 빠르다 (Dao et al., 2022).
- attention 최적화의 상당 부분은 이 둘 사이를 오가는 바이트를 줄이는 일이다.
Prefill 과 decode 의 병목
LLM 의 생성은 prompt 전체를 한 번에 처리하는 prefill 과, 토큰을 하나씩 만드는 decode 로 나뉜다 (Prefill).
prefill 은 연산 속도가, decode 는 메모리를 읽는 속도가 병목이다.
- prefill 은 토큰 수천 개를 한꺼번에 처리한다. 가중치를 한 번 읽어 많은 토큰에 곱하므로 큰 행렬곱이 되고, GPU 의 연산 속도가 한계가 된다.
- decode 는 토큰 하나를 만들 때마다 가중치 전체와 KV cache 전체를 읽지만 계산할 양은 적다.
- 바이트 하나를 읽을 때마다 하는 연산 수를 arithmetic intensity 라 한다. A100 은 이 값이 약 156 을 넘어야 연산이 병목이 되는데, decode 의 attention 은 1 보다 작다 (DistServe, Zhong et al., 2024).
그래서 같은 기법도 단계에 따라 효과가 다르다.
- 연산량을 줄이는 기법은 prefill 과 학습에서 효과가 크다.
- 캐시를 작게 만들거나 덜 읽게 하는 기법은 decode 에서 효과가 크다.
기법 한눈에 보기
“결과” 열은 표준 attention 과 같은 값을 내는지, 모델 구조 자체가 달라지는지다. 구조가 달라지는 기법은 학습할 때 정해야 하고, 이미 학습한 모델에는 붙일 수 없거나 추가 학습이 필요하다.
| 기법 | 바꾸는 것 | 주로 줄이는 것 | 효과가 큰 단계 | 결과 |
|---|---|---|---|---|
| MQA, GQA | 여러 query head 가 key·value head 를 나눠 쓴다 | KV cache 크기, decode 의 캐시 읽기 | decode | 구조가 달라진다 |
| MLA | key·value 를 짧은 latent 벡터 하나로 압축해 캐시한다 | KV cache 크기, decode 의 캐시 읽기 | decode | 구조가 달라진다 |
| FlashAttention | 점수 행렬을 HBM 에 쓰지 않고 블록 단위로 SRAM 안에서 계산한다 | 메모리 IO, 학습 중 activation 메모리 | 학습, prefill | 같다 |
| Flash-Decoding | 캐시를 길이 방향으로 나눠 병렬로 읽는다 | decode 에서 노는 GPU 연산 블록 | decode (배치가 작고 문맥이 길 때) | 같다 |
| PagedAttention | 캐시를 고정 크기 블록에 나눠 담는다 | 캐시 메모리의 낭비 | decode (배치 크기) | 같다 |
| KV cache 양자화 | 캐시 원소를 8 비트 이하로 저장한다 | KV cache 크기, 캐시 읽기 | decode | 근사 |
| sliding window | 최근 개 토큰만 본다 | 연산량, KV cache 크기 | 둘 다 | 구조가 달라진다 |
| NSA, DSA | 토큰 중 일부를 골라 그것만 본다 | 연산량, decode 의 캐시 읽기 | 둘 다 | 구조가 달라진다 |
| linear attention, hybrid | softmax attention 을 고정 크기 상태를 갱신하는 층으로 바꾼다 | 연산량, KV cache 크기 | 둘 다 | 구조가 달라진다 |
“효과가 큰 단계” 는 각 기법이 줄이는 대상을 prefill·decode 병목과 맞춰 본 해석이다. 논문의 측정 조건과 수치는 부록에 모았다.
Key·value head 를 나눠 쓰거나 압축하기: MQA, GQA, MLA
decode 는 캐시를 읽는 속도에 묶여 있고 캐시 크기는 key·value head 수에 비례하므로, query head 는 두고 key·value head 만 줄인다.
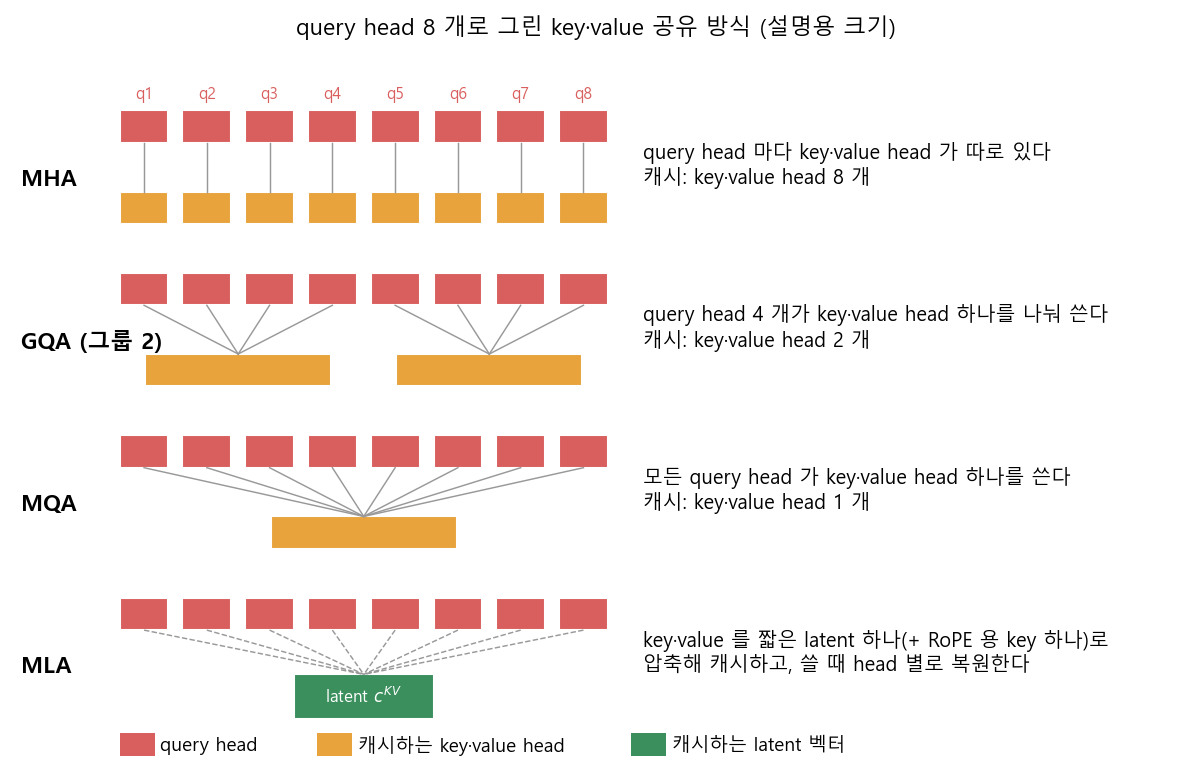
그림은 query head 8 개짜리 층 하나에서 네 방식이 key·value 를 어떻게 나눠 쓰는지 그린 것이다. 빨간 칸이 query head, 주황 칸이 캐시에 저장하는 key·value head, 초록 칸이 MLA 가 저장하는 latent 벡터다. 위에서 아래로 갈수록 캐시에 남는 것이 줄어든다.
- MHA (multi-head attention): 원래 방식이다. query head 마다 key·value head 가 하나씩, 8 벌을 저장한다.
- MQA (multi-query attention): 모든 query head 가 key·value head 하나를 함께 쓴다 (Shazeer, 2019). 캐시가 head 수 분의 1 로 줄지만 품질이 조금 떨어진다.
- GQA (grouped-query attention): 그 중간이다. query head 를 몇 개 그룹으로 나누고 그룹마다 key·value head 하나를 쓴다 (Ainslie et al., 2023). 그룹이 1 개면 MQA, head 수만큼이면 MHA 다.
- 실제 모델은 head 가 훨씬 많다. Llama 3 8B 는 query head 32 개에 key·value head 8 개라 캐시가 MHA 의 4 분의 1 이다.
- 이미 학습한 MHA 모델도 그룹 안의 key·value 가중치를 평균 내 합친 뒤 조금 더 학습하면 GQA 로 바꿀 수 있다.
MLA (multi-head latent attention) 는 head 수를 줄이는 대신 key·value 를 짧은 벡터 하나로 압축해 저장한다.
- 토큰 의 hidden vector 를 길이 512 짜리 latent 로 줄여 캐시에 저장한다 (DeepSeek-V2·V3).
- head 별 key·value 는 계산할 때 로 복원한다. 캐시에는 128 개 head 의 key·value(값 32,768 개) 대신 latent 하나만 남는다.
MLA 는 decode 때 key 를 매번 복원하지 않는다.
- query 와 key 의 내적 에서 를 query 쪽 가중치에 미리 합쳐 두면 latent 와 바로 내적할 수 있다. value 쪽 도 출력 가중치에 합친다.
- 그러면 모든 query head 가 latent 하나를 key·value 로 함께 쓰는 셈이라, DeepSeek 은 이 형태를 MLA 의 “MQA 모드” 라 부른다.
- 이 합치기는 위치 정보를 넣는 RoPE 와 충돌한다. key 를 위치에 따라 회전시키는 행렬이 사이에 끼면 를 query 쪽으로 옮길 수 없다.
- 그래서 위치 정보만 담는 길이 64 짜리 key 를 따로 두고 RoPE 는 거기에만 적용한다(decoupled RoPE). 토큰당 층마다 캐시는 512 + 64 = 576 개 값이다.
같은 계산을 메모리 왕복 없이 하기: FlashAttention
식을 그대로 구현하면 점수 행렬을 HBM 에 썼다가 다시 읽는데, 이 왕복이 시간의 대부분을 차지한다. FlashAttention (Dao et al., 2022) 은 계산 결과는 그대로 두고 이 왕복을 없앤다.
- tiling: 를 SRAM 에 들어가는 크기의 블록으로 잘라 불러오고, 한 블록의 점수 계산·softmax·value 곱을 SRAM 안에서 끝낸 뒤 출력만 HBM 에 쓴다. 이 과정 전체를 CUDA kernel 하나로 합친다.
- online softmax: softmax 는 행 전체의 최댓값과 지수 합이 있어야 계산되는데, 블록 단위로는 행의 일부만 보인다. 그래서 행마다 지금까지의 최댓값 과 지수 합 을 들고 다니다가, 새 블록에서 더 큰 값이 나오면 이전 누적값을 배로 줄여 맞춘다.
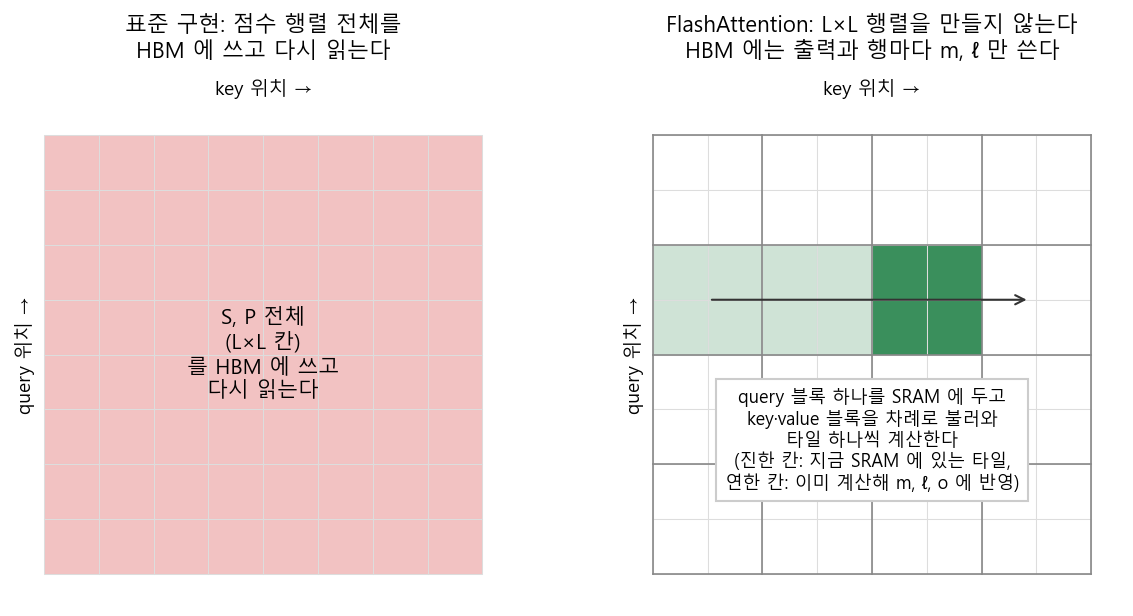
두 그림 모두 가로가 key 위치, 세로가 query 위치인 점수 행렬이다. 왼쪽 표준 구현은 행렬 전체(빨강)를 HBM 에 만든다. 오른쪽 FlashAttention 은 query 블록 하나를 SRAM 에 올려 둔 채 key·value 블록을 하나씩 불러온다. 진한 초록 타일이 지금 계산 중인 것이고, 연한 초록은 이미 계산해 누적값에 반영한 뒤 버린 것이다. 어느 순간에도 SRAM 에는 타일 하나 분량만 있다.
Step by Step 예시: online softmax
Attention 노트의 토큰 세 개 예에서 토큰 3 의 출력을 블록 두 개로 나눠 계산해 본다. 스케일링한 점수는 이고, value 는 , , 이다. key·value 를 {토큰 1, 2} 와 {토큰 3} 두 블록으로 나누고, 정규화하지 않은 출력 누적값을 라 한다.
| 단계 | |||
|---|---|---|---|
| 블록 1 (점수 0.707, 0.707) | 0.707 | ||
| 블록 2 (점수 1.414). 이전 값에 을 곱하고 새 항을 더한다 | 1.414 | ||
| 끝에서 로 나눈다 |
결과는 행 전체로 한 번에 계산한 토큰 3 의 출력 과 같다. FlashAttention 은 근사가 아니라 표준 attention 과 같은 값을 계산하고, 추가 메모리는 이 아니라 에 비례한다.
연산을 오히려 늘리고도 빨라지는 것은, attention 의 비용이 연산이 아니라 메모리 IO 에 있었기 때문이다.
- 역전파에서는 점수 행렬을 저장하지 않고 블록마다 다시 계산한다. 연산은 늘지만 HBM 접근이 줄어 전체 시간은 짧아진다.
- GPT-2 medium 에서 attention 의 순전파+역전파를 측정하면 연산량은 13% 늘었는데, HBM 읽기·쓰기가 9 분의 1 로 줄어 시간은 5.7 배 짧아졌다.
FlashAttention 은 연산량과 캐시 크기를 줄이지 않는다. 칸을 모두 계산하는 것은 같다.
decode 에서는 query 가 하나라 FlashAttention 만으로는 GPU 를 다 쓰지 못한다.
- FlashAttention 은 query 블록 단위로 일을 나누는데, decode 는 query 가 하나라 배치 × head 수만큼만 병렬화된다. 배치가 1 이면 GPU 의 1% 도 쓰지 못한다.
- Flash-Decoding 은 캐시를 길이 방향으로 여러 조각으로 나눠 각각 계산한 뒤, 조각별 최댓값·지수 합으로 online softmax 와 같은 보정을 해서 합친다.
캐시를 담는 방식 바꾸기: PagedAttention, 양자화
PagedAttention 은 캐시를 작은 블록으로 나눠 필요할 때마다 할당해, 미리 잡아 두고 안 쓰는 메모리를 없앤다.
- 요청마다 답변이 얼마나 길어질지 모르므로, 기존 서빙 시스템은 요청마다 최대 길이만큼의 연속된 메모리를 미리 잡았다. 실제 key·value 가 들어 있는 비율은 20–38% 였다.
- PagedAttention 은 운영체제의 가상 메모리처럼 캐시를 16 토큰짜리 블록으로 나눠 필요할 때 할당하고, 블록 표로 논리적 순서를 기록한다. 이 비율이 96% 로 올라간다.
- 같은 prompt 에서 답변을 여러 개 뽑을 때는 공통 앞부분의 블록을 함께 쓰다가 내용이 갈라질 때만 복사한다.
- 토큰당 캐시 크기는 그대로다. 같은 메모리에 더 많은 요청을 담아 배치를 키우는 기법이다 (vllm).
KV cache 양자화는 캐시 원소 하나의 바이트 수를 줄인다.
- vLLM 은 캐시를 FP8 로 저장하는 옵션이 있고, BF16 대비 크기가 절반이 된다.
- KIVI 는 2 비트까지 내렸다. key 는 특정 채널(벡터의 특정 원소 위치)에 큰 값이 몰려 있어 채널 단위로, value 는 토큰 단위로 양자화 범위를 잡는다. 가장 최근 토큰 몇십 개는 원래 정밀도로 둔다.
- 양자화는 근사라서 품질 변화를 따로 확인해야 한다 (Quantization).
보는 토큰 수 줄이기: sliding window, NSA, DSA
앞의 기법들은 모든 토큰을 보는 attention 을 싸게 계산했고, 여기서부터는 query 하나가 보는 토큰 수 자체를 줄인다. 연산량과 decode 의 캐시 읽기가 함께 준다. 대신 모델 구조가 달라지므로 그렇게 학습해야 한다.
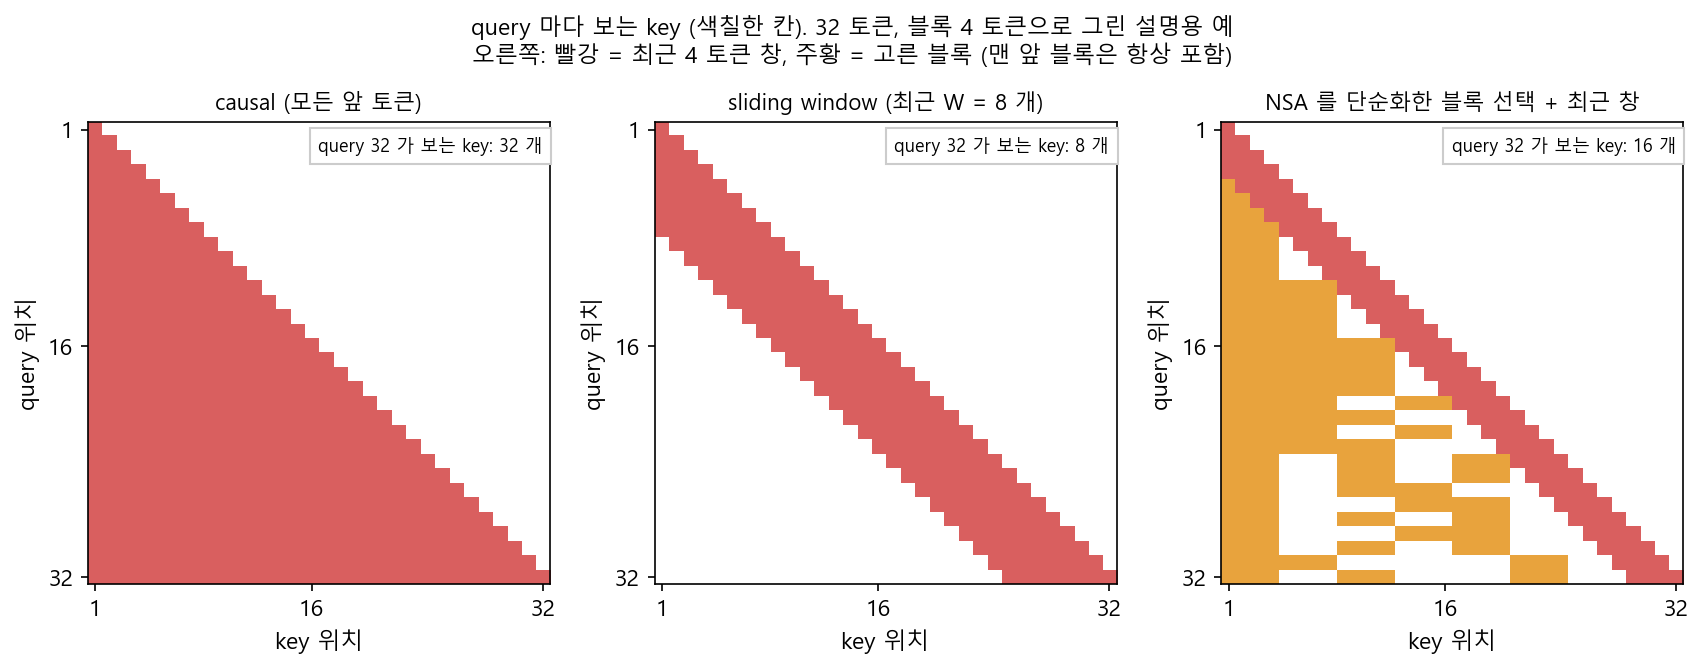
세 그림은 32 토큰 시퀀스에서 query 마다 어떤 key 를 보는지 색칠한 것이다. 왼쪽 causal attention 은 대각선 아래를 모두 칠한다. 가운데 sliding window 는 대각선을 따라 폭 8 인 띠만 남는다. 오른쪽은 NSA 를 단순화한 모양으로, 최근 4 토큰(빨강)에 더해 query 마다 고른 4 토큰 블록 몇 개(주황)를 본다.
sliding window attention 은 각 토큰이 바로 앞 개 토큰만 본다.
- Mistral 7B 는 을 쓴다.
- 한 층에서는 칸 밖을 못 보지만, 층을 지날 때마다 정보가 칸씩 더 전달된다. 32 층이면 이론상 약 131K 토큰 앞의 정보까지 닿는다.
- 캐시도 층마다 최근 개만 있으면 되므로 고정 크기 버퍼에 돌려 가며 덮어쓴다.
NSA (Native Sparse Attention) 는 query 마다 세 갈래로 key·value 를 고르고, 세 결과를 학습된 gate 로 섞는다 (DeepSeek, Yuan et al., 2025).
- 압축: 32 토큰 블록을 작은 MLP 로 key·value 하나씩으로 요약해 문맥 전체를 거칠게 본다.
- 선택: 압축 갈래의 점수로 64 토큰 블록의 중요도를 매기고, 상위 16 개 블록의 원래 토큰을 그대로 본다.
- 창: 최근 512 토큰을 본다.
블록 단위로 고르는 것은 GPU 가 연속된 메모리를 읽을 때 빠르기 때문이다.
DSA (DeepSeek Sparse Attention) 는 가벼운 점수기로 앞 토큰들에 점수를 매기고, 상위 2,048 개 토큰만으로 attention 을 계산한다 (DeepSeek-V3.2).
- 본 attention 의 연산이 에서 로 준다. 는 고르는 토큰 수다.
- 점수기 자체는 여전히 모든 앞 토큰과 점수를 계산하지만, FP8 로 계산할 수 있게 만들어 본 attention 보다 훨씬 싸다.
NSA 와 DSA 는 보는 토큰은 줄여도 캐시에서 지우지는 않는다.
- 다음 query 가 어느 토큰을 고를지 모르기 때문이다. 그래서 캐시 크기는 줄지 않고, decode 에서 읽는 양만 준다.
- sliding window 는 창 밖의 토큰을 지우므로 캐시 크기 자체가 준다.
Softmax attention 을 다른 연산으로 바꾸기: linear attention, hybrid
linear attention 은 점수를 두 벡터에 각각 함수를 적용한 뒤의 내적으로 바꿔, 행렬곱의 순서를 바꿀 수 있게 한다 (Katharopoulos et al., 2020).
- 는 벡터의 각 원소에 적용하는 함수다. 원래의 를 로 바꾼 것이다.
- 왼쪽처럼 계산하면 점수 행렬을 만들어 에 비례한다.
- 오른쪽처럼 를 먼저 계산하면 길이 과 상관없는 작은 행렬이 되어 에 비례한다.
생성할 때는 캐시 대신 고정 크기 상태 하나만 들고 다닌다.
- causal 한 경우에는 를 토큰마다 하나씩 더해 가는 RNN 형태가 된다. 토큰당 연산과 메모리가 문맥 길이와 상관없이 일정하다.
- 대신 과거 전체를 고정 크기 상태에 눌러 담기 때문에, 긴 문맥에서 특정 정보를 정확히 찾아오는 능력이 약해질 수 있다.
그래서 최근 모델은 고정 크기 상태를 갖는 층 사이에 softmax attention 층을 일부만 섞는다(hybrid). KV cache 는 softmax attention 층에서만 생기므로 그 비율만큼 준다.
| 모델 | 구성 |
|---|---|
| MiniMax-Text-01 | lightning attention(linear attention 의 한 구현) 7 층마다 softmax attention 1 층, 총 80 층 |
| Jamba | Mamba(state space model) 7 층마다 attention 1 층 |
| Qwen3-Next-80B-A3B | Gated DeltaNet 3 층마다 gated attention 1 층, 총 48 층 |
부록: 논문별 측정값
arithmetic intensity (DistServe 부록 A)
- decode 의 attention 은 head 하나에서 메모리 읽기·쓰기 번(원소 단위)에 연산 번이라 그 비가 1 보다 작다. 는 head 길이, 은 문맥 길이다.
- FlashAttention 을 쓴 prefill 의 attention 계산도 이 값이 10–21 정도라서 메모리 쪽에 가깝다. prefill 이 연산 병목이라는 말은 주로 행렬곱에 해당한다 (Sarathi-Serve, Agrawal et al., 2024 도 같은 구분을 분석했다).
MQA (Shazeer, 2019)
- WMT14 영어–독일어 번역 모델(6 층, head 8 개, head 길이 128)에서 TPUv2 로 측정한 디코더의 토큰당 시간이 46 µs 에서 3.8 µs 로 약 12 배 줄었다 (Table 2, 배치 1024).
- dev BLEU 는 26.7 에서 26.5 로 0.2 떨어졌다 (Table 1). 파라미터 수를 맞추려고 feed-forward 층을 4096 에서 5440 으로 넓힌 비교다.
GQA (Ainslie et al., 2023)
- MHA 를 GQA 로 바꿀 때 원래 사전학습 스텝의 5% 만큼 더 학습했다 (2.1절, 3.1절).
- T5-XXL 에서 GQA-8 의 요약·번역·QA 평균 점수는 47.1 로 MHA 의 47.2 와 거의 같고, 샘플당 추론 시간은 1.51 초에서 0.28 초로 약 5.4 배 줄었다 (Table 1, TPUv4).
MLA (DeepSeek-V2·V3)
- DeepSeek-V2 는 hidden vector 길이 5120(V3 는 7168), head 128 개, head 길이 128, latent 길이 512, 위치용 key 길이 64 를 쓴다 (V2 2.1절, 부록 C).
- DeepSeek 67B 대비 KV cache 를 93.3% 줄이고 최대 생성 처리량을 5.76 배 높였다고 보고했다 (초록, 1장). 처리량은 가중치를 FP8, KV cache 를 원소당 평균 약 6 비트로 양자화하고 H800 8 장으로 측정한 값이다. 93.3% 에 이 양자화가 포함되는지는 논문에 나와 있지 않다.
- 같은 규모의 MoE 모델끼리 비교하면 MLA 가 MHA 의 14%(약 16B 모델), 4%(약 250B 모델) 크기 캐시로 MHA 보다 좋은 성능을 냈다 (부록 D.2).
- DeepSeek-V3.2 보고서(부록 A)에 따르면 V3.1-Terminus 는 학습과 prefill 에 key·value 를 복원하는 MHA 모드를, decode 에 MQA 모드를 쓴다.
FlashAttention (Dao et al., 2022)
- HBM 접근 횟수는 표준 구현이 , FlashAttention 이 이다 (Theorem 2). 은 시퀀스 길이, 는 head 길이, 은 SRAM 크기다. 가 64–128, 이 약 100 KB 면 이 보다 훨씬 작아 접근 횟수가 크게 준다.
- GPT-2 medium(시퀀스 1024, head 16 개, head 길이 64, 배치 64, A100)에서 attention 순전파+역전파를 측정했다 (Figure 2).
| 구현 | 연산량 (GFLOPs) | HBM 읽기·쓰기 (GB) | 시간 (ms) |
|---|---|---|---|
| 표준 attention | 66.6 | 40.3 | 41.7 |
| FlashAttention | 75.2 | 4.4 | 7.3 |
- FlashAttention-2 (Dao, 2023) 는 행렬곱이 아닌 연산을 줄이고 시퀀스 길이 방향으로도 병렬화해 약 2 배 빠르고, A100 이론 최대 연산 속도의 50–73% 에 이른다.
- FlashAttention-3 (Shah et al., 2024) 는 H100 의 비동기 메모리 복사와 FP8 을 써서 FP16 으로 최대 740 TFLOPs/s(이론 최대의 75%), FP8 로 약 1.2 PFLOPs/s 를 보고했다.
Flash-Decoding (Dao et al., 2023 블로그)
- A100 에서 배치 1, query head 16 개·key·value head 2 개 조건으로 측정한 attention 자체는 FlashAttention 보다 최대 50 배 빨랐다.
- CodeLlama-34B 로 배치 1, 시퀀스 길이 64K 까지 생성한 전체 속도는 최대 8 배였다. 이 측정의 GPU 종류와 수는 글에 나와 있지 않다.
PagedAttention (Kwon et al., 2023)
- 기존 시스템에서 KV cache 용 메모리 중 실제 토큰의 key·value 가 들어 있는 비율은 20.4–38.2%, vLLM 은 96.3% 였다 (Figure 2).
- 같은 지연 시간에서 FasterTransformer, Orca 보다 처리량이 2–4 배 높았다.
KIVI (Liu et al., 2024)
- Llama-2-7B 를 A100 한 장에서 돌렸을 때 가중치까지 포함한 최대 메모리가 2.6 배 줄고, 배치를 최대 4 배 키워 처리량이 2.35–3.47 배 늘었다.
sliding window (Mistral 7B, Jiang et al., 2023)
- 32K 토큰 시퀀스에서 캐시 메모리가 8 배 줄었다 (2절).
NSA (Yuan et al., 2025)
- 압축 갈래는 32 토큰 블록을 16 토큰 간격으로 요약한다. 선택 갈래는 맨 앞 블록 1 개와 최근 블록 2 개를 항상 포함한다.
- 64K 문맥에서 A100 8 장 기준 순전파 9.0 배, 역전파 6.0 배 빨랐다 (Triton 으로 구현한 FlashAttention-2 대비, 5.1절).
- decode 는 한 스텝에 읽는 토큰이 65,536 개에서 5,632 개로 줄어 11.6 배를 기대할 수 있다고 계산했다 (Table 4). 시간 측정값이 아니라 읽는 메모리 양으로 추정한 값이다.
- 27B MoE 모델로 사전학습했을 때 일반 벤치마크 평균은 0.456 으로 full attention 의 0.443 보다 높았다 (Table 1).
DSA (DeepSeek-V3.2)
- 점수기(lightning indexer)의 식은 다음과 같다. 공개 설정은 head 개, key 길이 128 이다.
- 는 토큰 가 앞 토큰 를 볼 가치를 나타내는 점수이고, 는 토큰 에서 만든 점수기의 query 와 head 가중치, 는 토큰 에서 만든 점수기의 key 다.
- V3.1-Terminus 에서 출발해 점수기만 먼저 학습하고(21 억 토큰) 전체를 이어서 학습했다(9,437 억 토큰).
- 비용 감소는 H800 에서 실제 서비스를 측정해 추정한 그래프(Figure 3)로만 제시했고 본문에 수치는 없다. 공개 벤치마크는 V3.1-Terminus 와 비슷하다 (예: MMLU-Pro 85.0 대 85.0).
- 점수기의 key 만큼 캐시가 오히려 조금 커진다.
linear attention · hybrid
- linear attention 논문(Katharopoulos et al., 2020)은 을 썼다 (3.4절에 RNN 형태).
- MiniMax-01 보고서(2.2절)는 linear attention 만 쓴 모델이 긴 문서에서 특정 문장을 찾는 과제(needle in a haystack)에서 한계를 보였다고 적었다.
- Jamba 는 256K 문맥 16 비트 기준 KV cache 가 4 GB 로, Mixtral 의 32 GB 보다 작다 (Lieber et al., 2024, Table 1).
- Qwen3-Next 의 구성은 공식 모델 카드와 config 의
full_attention_interval= 4 에서 확인했다.
References
- Zhong et al., 2024, DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
- Agrawal et al., 2024, Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve
- Shazeer, 2019, Fast Transformer Decoding: One Write-Head is All You Need
- Ainslie et al., 2023, GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- DeepSeek-AI, 2024, DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
- DeepSeek-AI, 2024, DeepSeek-V3 Technical Report
- Dao et al., 2022, FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- Dao, 2023, FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- Shah et al., 2024, FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
- Dao, Haziza, Massa, Sizov, 2023, Flash-Decoding for long-context inference
- Kwon et al., 2023, Efficient Memory Management for Large Language Model Serving with PagedAttention
- Liu et al., 2024, KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache
- vLLM 문서, Quantized KV Cache
- Jiang et al., 2023, Mistral 7B
- Yuan et al., 2025, Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
- DeepSeek-AI, 2025, DeepSeek-V3.2-Exp: Boosting Long-Context Efficiency with DeepSeek Sparse Attention, DeepSeek-V3.2
- Katharopoulos et al., 2020, Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention
- MiniMax, 2025, MiniMax-01: Scaling Foundation Models with Lightning Attention
- Lieber et al., 2024, Jamba: A Hybrid Transformer-Mamba Language Model
- Qwen, Qwen3-Next-80B-A3B-Instruct 모델 카드