쇼핑 검색에서 노출된 상품이 클릭될지 예측하는 모델을 만든다고 하자. 10월 한 달 동안 상품이 노출된 기록 약 6만 건을 모았고, 노출 한 건마다 클릭됐으면 1, 아니면 0 을 라벨로 붙였다. 피처는 둘이다.
- 상품 클릭률: 그 상품이 노출된 횟수 중 클릭된 비율이다. 10월 전체 기록으로 계산해 붙였다.
- 검색어와 상품의 관련도: 노출 한 건마다 따로 매긴 점수다.
10월 기록을 무작위로 섞어 80% 로 학습하고 나머지 20% 로 평가했더니 AUC 가 0.81 이 나왔다. 그런데 이 모델을 11월에 실제로 쓰면 AUC 가 0.70 으로 떨어진다. 클릭률을 다른 방식으로 계산한 모델은 평가에서 0.71 로 더 낮았지만, 11월에는 0.72 로 오히려 앞선다.
한눈에 보기
- Data leakage 는 예측하는 순간에는 알 수 없는 정보가 학습·평가 데이터에 섞이는 것이다: 평가 점수는 올라가지만, 실제 서비스에는 그 정보가 없어서 성능이 떨어진다.
- 집계 피처는 그 샘플 시각 이전 기록으로만 계산한다: 10월 전체로 계산한 클릭률에는 미래의 클릭과 맞히려는 클릭 자체가 들어 있다.
- 학습 때와 서비스 때 피처를 다른 경로로 만들면 같은 문제가 생긴다: 서비스 때 모델에 넣은 피처 값을 기록해 두고 그 값으로 학습한다.
- 같은 사용자·검색어가 학습과 평가에 나뉘어 들어가도 점수가 부풀려진다: 시간 순서나 그룹 단위로 나눈다.
- 평가 데이터로 무언가를 고르면 그 평가 점수는 더 이상 믿을 수 없다: 임계값·하이퍼파라미터는 검증 데이터로 고르고, 평가 데이터는 마지막에 한 번만 본다.
예측 시점에 알 수 없는 정보
모델은 예측하는 순간에 손에 있는 정보만 쓸 수 있다. 11월 5일 오후 2시에 상품 A 를 보여 줄지 정한다면, 그 시각까지 쌓인 기록만 쓸 수 있다. A 가 그 뒤에 몇 번 클릭될지는 모른다.
학습 데이터를 만들 때는 이 제약이 저절로 지켜지지 않는다. 10월 기록을 다 모은 뒤에 학습 데이터를 만들기 때문에, 10월 5일 노출 한 건에 10월 31일까지의 정보를 붙이기 쉽다. 이렇게 예측 시점에는 없었을 정보가 학습이나 평가에 섞이는 것을 data leakage 라 한다.
Leakage 는 학습 데이터와 평가 데이터가 섞이는 것만 뜻하지 않는다. 두 데이터가 겹치는 데가 하나도 없어도, 피처 하나가 미래를 담고 있으면 평가 점수가 부풀려진다. 처음 예시가 그런 경우다.
집계 피처에 미래와 정답이 섞일 때
처음 예시에서 클릭률 피처를 10월 전체 기록으로 계산했다. 10월 5일 오후 2시의 노출 한 건 입장에서 보면 두 가지가 새어 들어와 있다.
- 미래의 클릭: 10월 6일부터 31일까지의 클릭이 클릭률에 들어 있다. 10월 5일에 서비스하는 모델은 알 수 없는 값이다.
- 맞히려는 클릭 자체: 지금 예측하려는 바로 그 노출의 클릭 여부가 클릭률 계산에 들어 있다.
노출이 적은 상품일수록 이 피처가 정답을 거의 그대로 알려 준다.
- 10월에 열 번 노출된 상품이 있다. 노출 열 건에는 모두 같은 클릭률이 붙는다.
- 클릭률이 0% 면 열 건 모두 클릭이 없었다는 뜻이다. 모델은 이 상품의 노출을 전부 음성으로 맞힐 수 있다.
- 예시 데이터에서 10월에 노출된 상품의 절반은 노출이 10 건 이하다.
학습 데이터의 클릭률이 이렇게 잘 맞으니, 모델은 클릭률을 강하게 믿도록 학습된다. 예시에서 클릭률에 붙은 가중치는 제대로 계산한 모델의 4 배였다. 그런데 11월에 서비스할 때는 미래 기록이 없으므로 클릭률을 전날까지의 기록으로만 계산할 수밖에 없다. 학습 때보다 훨씬 덜 정확한 값을 4 배로 믿는 셈이다.
아래 그림은 클릭률 계산 방식이 다른 두 모델의 AUC 다. 파란 막대는 10월 기록 중 떼어 둔 20% 로 잰 값이고, 주황 막대는 11월 기록에 실제 서비스와 같은 방식으로 피처를 붙여 잰 값이다. 가로축은 무작위로 점수를 줄 때의 AUC 인 0.5 부터 그렸다.
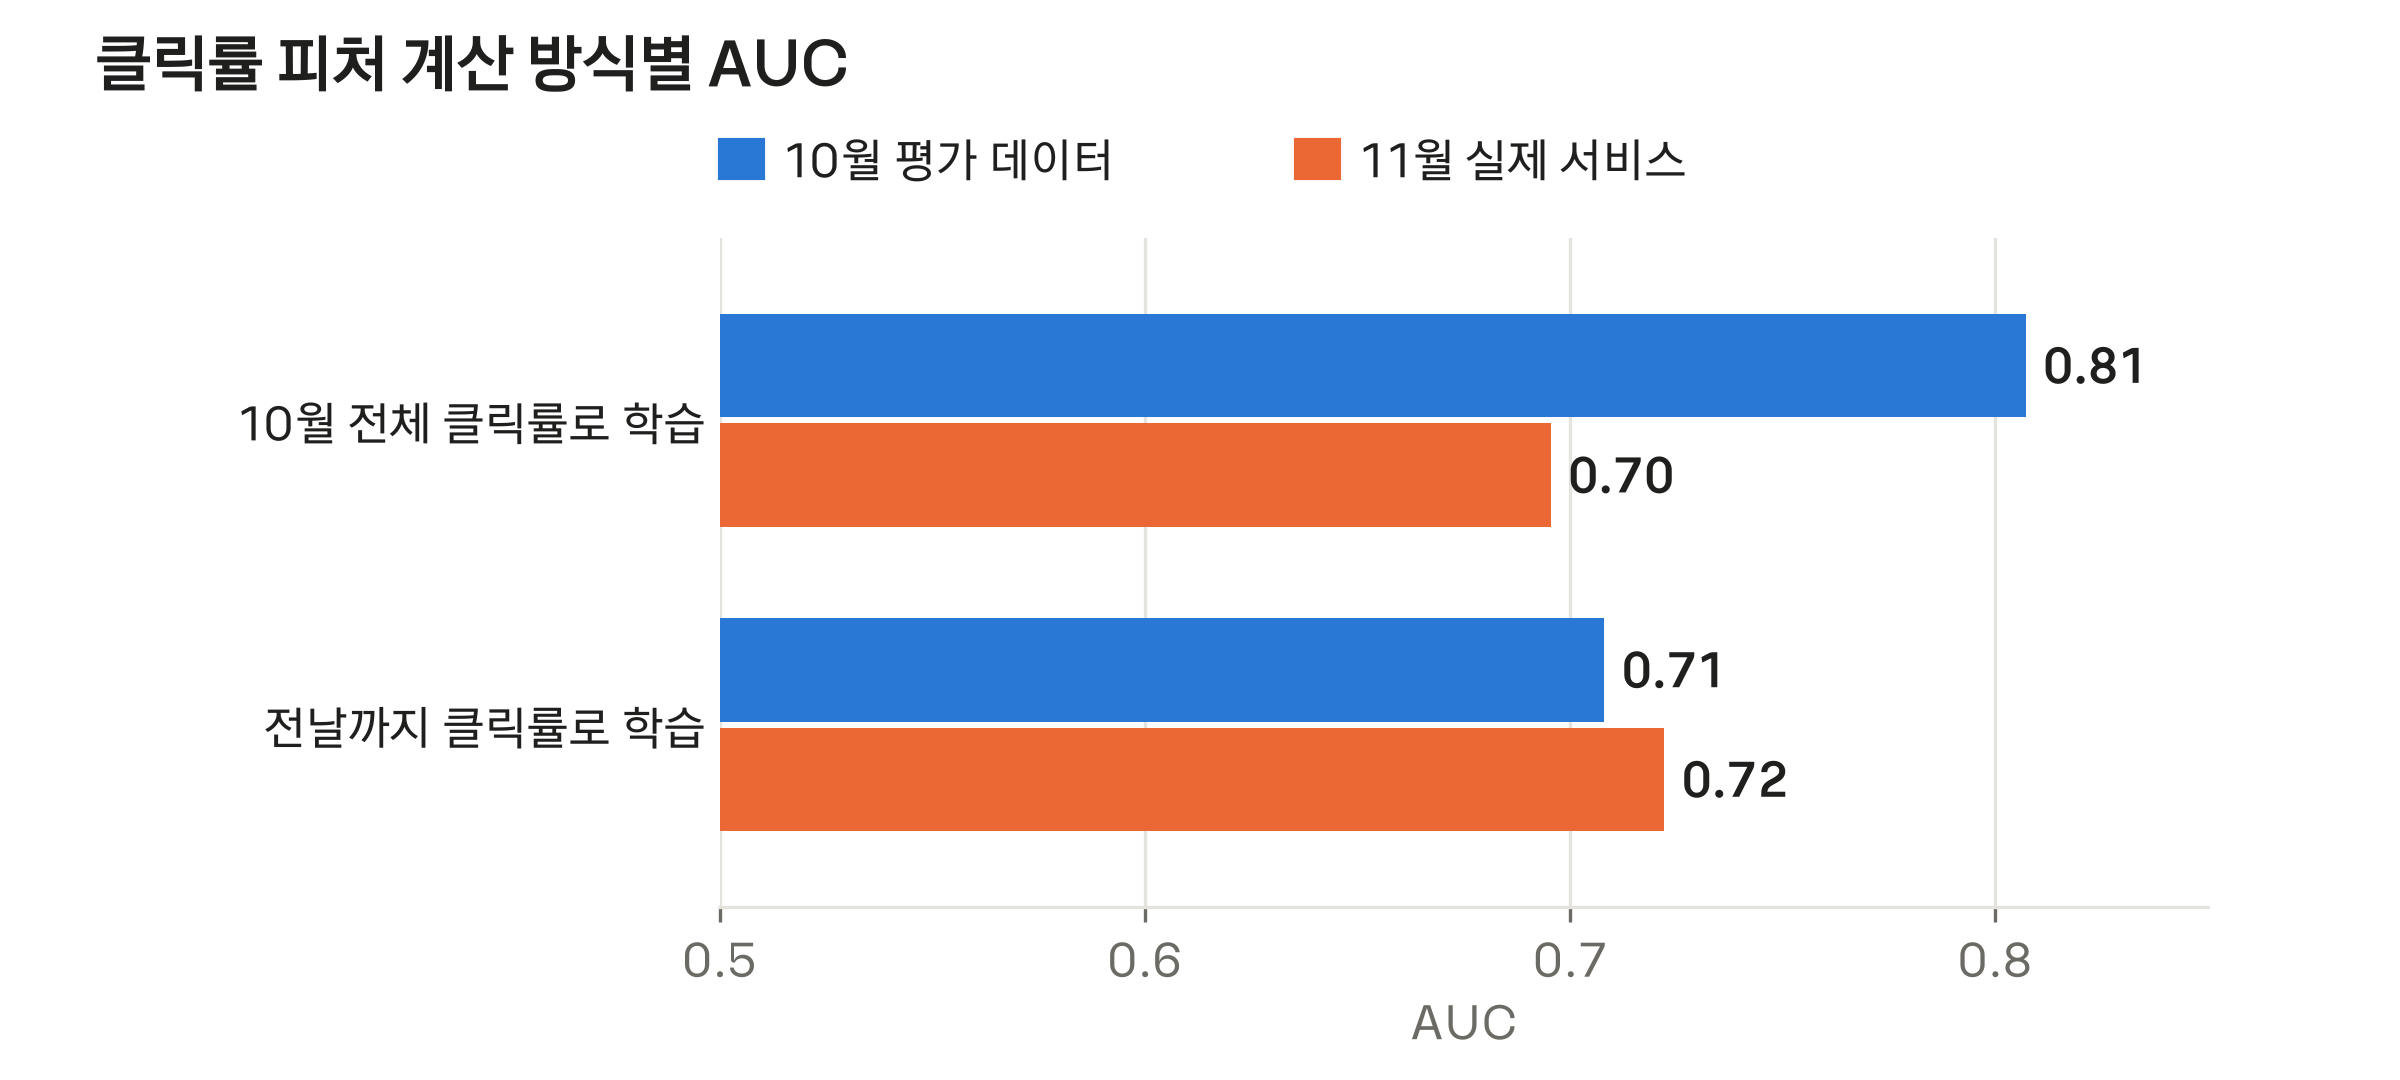
평가 점수가 높은 모델이 실제로는 더 나빴다.
- 10월 전체 클릭률로 학습한 모델: 평가 0.81 → 11월 0.70.
- 전날까지 클릭률로 학습한 모델: 평가 0.71 → 11월 0.72.
- 두 모델을 평가 점수로 고르면 나쁜 쪽을 고르게 된다.
대책은 각 샘플의 피처를 그 샘플 시각 이전 기록으로만 계산하는 것이다. 이를 point-in-time 피처라고 부른다.
- 10월 5일 노출에는 10월 4일까지의 클릭률을 붙인다.
- 평가 점수는 낮아지지만, 서비스 때 모델이 받는 것과 같은 값으로 학습하므로 평가 점수가 실제 성능에 가까워진다.
- 실제로는 노출이 적은 상품의 클릭률이 0% 나 100% 로 튀지 않게, 전체 평균 쪽으로 당겨서 계산한다 (부록).
학습 때와 서비스 때 피처가 다를 때
Point-in-time 으로 계산해도, 학습 데이터를 만드는 코드와 서비스에서 피처를 만드는 코드가 다르면 값이 어긋난다. 이를 training-serving skew 라 한다. 미래 정보가 섞인 것은 아니지만, 모델이 학습 때 본 값과 서비스 때 받는 값이 달라진다는 결과는 같다.
어긋나는 경로는 대개 셋이다.
- 집계 방식이 다르다: 학습 데이터는 하루 단위 배치로 집계하고, 서비스는 실시간 카운터로 집계한다. 집계 범위나 중복 클릭을 빼는 기준이 조금씩 다르다.
- 기록이 늦게 도착한다: 학습 데이터를 만들 때는 그날 클릭이 다 모여 있지만, 서비스 시점에는 몇 시간치가 아직 반영되지 않았다.
- 빈 값을 채우는 방식이 다르다: 서비스에서 피처를 제때 못 가져오면 기본값 0 이 들어가는데, 학습 데이터에는 그런 0 이 없다.
가장 확실한 대책은 서비스 때 모델에 실제로 넣은 피처 값을 기록해 두고, 그 기록으로 학습하는 것이다.
- 학습과 서비스가 같은 값을 보게 되므로 위 세 경로가 모두 사라진다.
- 새 피처는 기록이 쌓일 때까지 학습에 쓸 수 없다.
- 기록할 수 없는 피처는 학습용과 서비스용 집계를 같은 코드로 만들고, 두 쪽 값의 분포를 주기적으로 비교한다.
같은 사용자·검색어가 학습과 평가에 나뉠 때
처음 예시는 10월 기록을 무작위로 섞어 나눴다. 그러면 같은 사용자가 같은 날 같은 검색어로 본 노출이 학습과 평가 양쪽에 들어간다. 모델이 그 사용자·검색어의 특징을 외워서 평가 데이터를 맞히면 점수는 오른다. 하지만 서비스에서 처음 보는 사용자·검색어에는 통하지 않는다.
학습과 평가는 서비스와 같은 조건이 되도록 나눈다.
- 시간 순서로 나눈다: 10월 1–24일로 학습하고 25–31일로 평가한다. 과거로 학습해 미래를 예측하는 서비스와 조건이 같아진다.
- 그룹 단위로 나눈다: 사용자·검색어·세션 단위로 묶어 한 묶음이 한쪽에만 들어가게 한다. cross-validation 에서는 scikit-learn 의
GroupKFold가 이 방식이다. - 랭킹 모델은 최소한 검색어 단위로 나눈다: 검색어 하나의 결과 목록이 한 평가 단위이므로, 같은 목록의 문서가 양쪽에 흩어지면 안 된다.
- 중복·유사 샘플도 한쪽에 몰아 넣는다: 같은 문서의 사본, 같은 사진을 조금 자른 것이 양쪽에 있으면 모델은 외운 답으로 평가 데이터를 맞힌다.
전처리와 모델 선택에서 새는 경우
피처가 깨끗해도 학습 과정에서 평가 데이터를 들여다보면 평가 점수가 부풀려진다.
- 전처리 통계를 전체 데이터로 계산할 때: 정규화에 쓰는 평균·표준편차, 범주별 평균 라벨(target encoding), 어휘 사전을 학습·평가를 합친 데이터로 만들면 평가 데이터의 정보가 학습에 들어간다.
- 통계는 학습 데이터로만 계산하고, 평가 데이터에는 그 값을 그대로 적용한다.
- Target encoding 은 학습 데이터 안에서도 자기 라벨이 섞이므로 out-of-fold 로 계산한다.
- 평가 데이터로 임계값·하이퍼파라미터를 고를 때: 평가 점수가 가장 좋은 값을 고르면, 그 점수에는 평가 데이터에 우연히 잘 맞은 몫이 들어 있다.
- 검증 데이터로 고르고, 평가 데이터는 마지막에 한 번만 본다.
- 같은 판정자가 만든 라벨로 학습과 평가를 할 때: 큰 언어 모델이 매긴 라벨로 작은 모델을 학습하고 같은 방식의 라벨로 평가하면, 판정자의 실수를 따라 할수록 점수가 오른다.
- 사람이 검수한 평가 데이터를 따로 둔다.
Leakage 를 의심할 신호
- 평가 점수가 기대보다 지나치게 좋다: 같은 문제를 푼 다른 모델이나 이전 버전보다 크게 앞서면 먼저 피처를 의심한다.
- 피처 하나가 혼자 성능을 거의 다 낸다: 예시에서 10월 전체 클릭률 하나만으로 점수를 매기면 AUC 가 0.74 였다. 전날까지 클릭률 하나만으로는 0.54 다.
- 시간 순서로 나눠 다시 평가하면 점수가 크게 떨어진다: 무작위로 나눌 때만 좋은 모델은 외운 것을 맞히고 있을 가능성이 크다.
- 서비스 때 그 피처를 언제, 어디서 가져오는지 설명할 수 없다: 피처마다 이 질문에 답해 보면 미래 정보가 섞인 피처가 드러난다.
부록: 시뮬레이션 설정
처음 예시와 그림의 숫자는 아래 설정으로 만든 가상 데이터에서 나왔다.
- 상품 3,000 개, 기간 61 일 (10월 31 일 + 11월 30 일).
- 상품마다 고유 매력 와 하루 평균 노출 수 를 정한다. 노출 수는 날마다 Poisson() 로 뽑는다.
- 노출마다 관련도 을 뽑고, 클릭 확률은 이다. 전체 클릭률은 약 6.7% 다.
- 클릭률 피처는 두 방식 모두 전체 평균 쪽으로 당긴 값 을 쓰고, 계산 기간만 다르다.
- 10월 전체: 10월 1–31 일의 모든 노출.
- 전날까지: 그 노출 날짜의 전날까지 모든 노출. 11월 노출에는 10월과 11월 전날까지를 합쳐 쓴다.
- 모델은 로지스틱 회귀이고 입력은 [클릭률의 logit, 관련도] 다. 10월 노출을 무작위로 섞어 80% 로 학습하고 20% 로 평가했다.
- 11월 성능은 두 모델 모두 “전날까지” 클릭률을 넣어 잰다. 서비스에서는 그 값밖에 구할 수 없기 때문이다.
| 난수 시드 | 10월 전체: 평가 | 10월 전체: 11월 | 전날까지: 평가 | 전날까지: 11월 | 클릭률 가중치 (10월 전체 / 전날까지) |
|---|---|---|---|---|---|
| 0 | 0.807 | 0.695 | 0.708 | 0.722 | 1.75 / 0.41 |
| 1 | 0.805 | 0.692 | 0.708 | 0.720 | 1.67 / 0.42 |
| 2 | 0.800 | 0.698 | 0.706 | 0.723 | 1.72 / 0.47 |
본문의 숫자는 시드 0 이다.
관련 노트
References
- Kaufman, Rosset, Perlich, Stitelman, “Leakage in Data Mining: Formulation, Detection, and Avoidance”, ACM TKDD 6(4), 2012. https://doi.org/10.1145/2382577.2382579
- Google, Rules of Machine Learning — Rule #29 (서비스 때 쓴 피처를 기록해 학습에 쓰기) 와 training-serving skew 절. https://developers.google.com/machine-learning/guides/rules-of-ml
- scikit-learn, Common pitfalls and recommended practices — Data leakage. https://scikit-learn.org/stable/common_pitfalls.html