사용자가 아직 다 치지 않은 앞부분으로 단어를 찾는 검색이다. 검색창에 “삼성” 까지만 쳐도 “삼성전자” 가 나오는 자동완성, “ㅅㅅㅈㅈ” 처럼 초성만 쳐도 찾아 주는 초성 검색이 모두 여기에 속한다.
역색인 은 완성된 단어(term)를 열쇠로 문서를 찾는다. “삼성전자” 로 색인된 문서는 “삼성” 이라는 term 으로는 안 나온다. 그래서 앞부분으로 찾으려면 따로 구조를 만들어야 하고, 방법은 크게 두 갈래다.
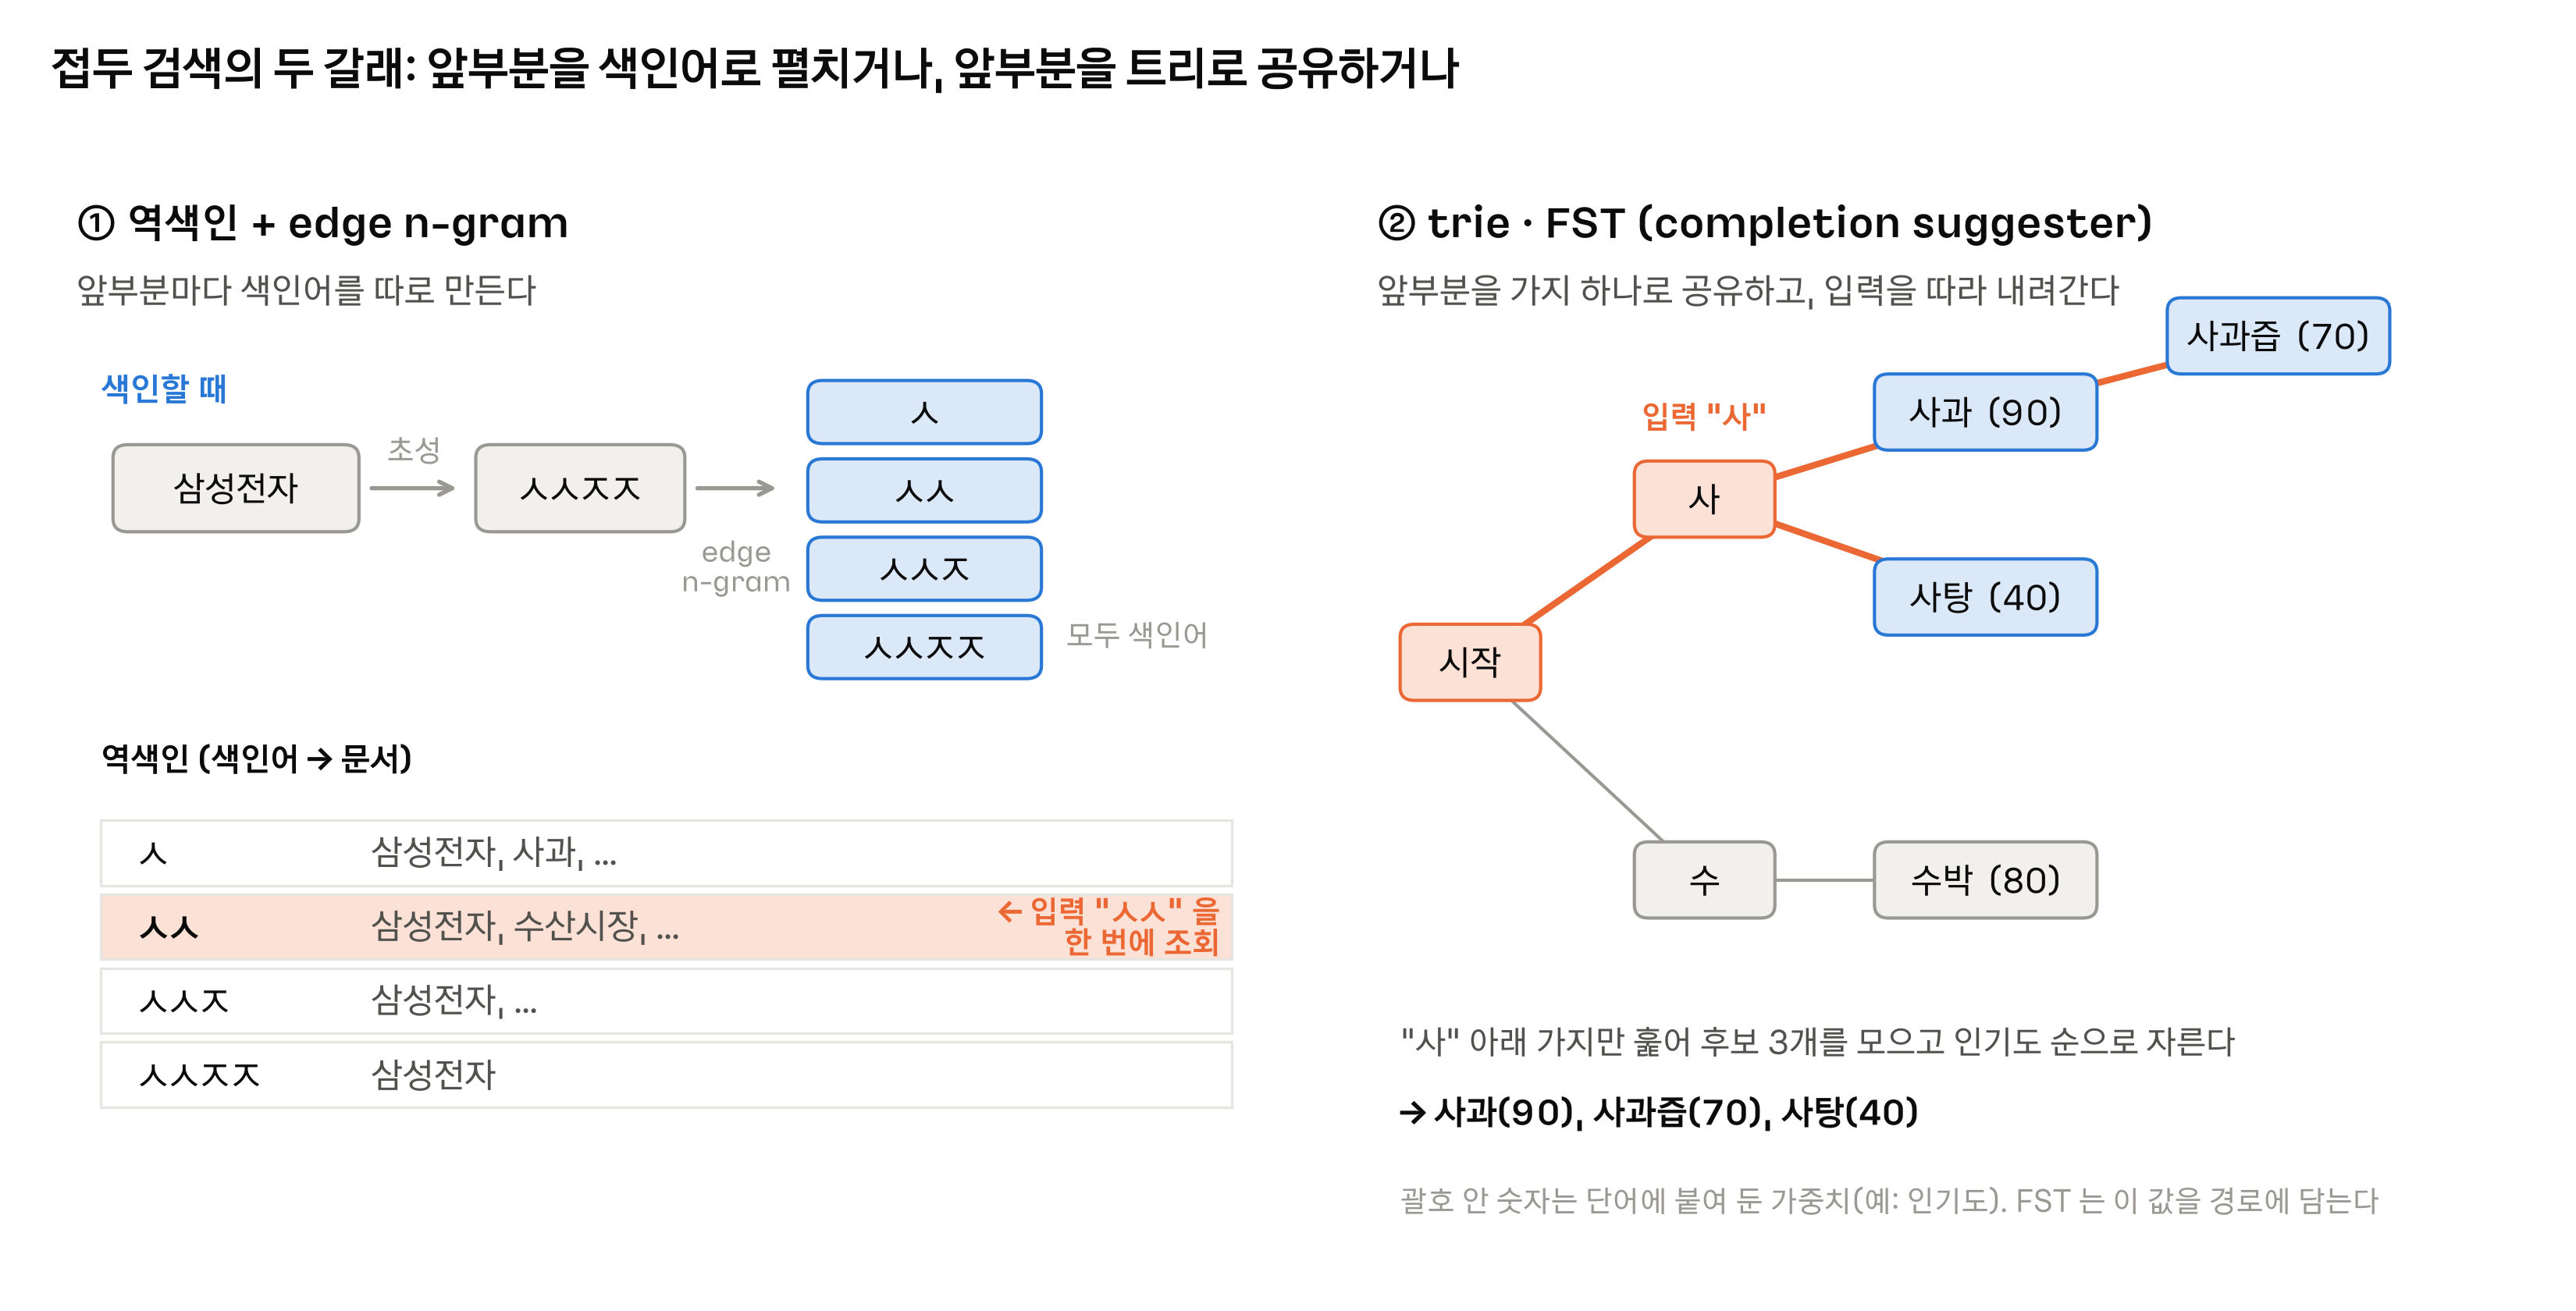
- 앞부분을 색인어로 펼친다: 색인할 때 “삼”, “삼성”, “삼성전”, “삼성전자” 를 모두 term 으로 넣는다. 검색할 때는 입력을 그대로 일반 키워드처럼 찾는다. Elasticsearch 의 edge n-gram 이 이 방식이다.
- 앞부분을 트리로 공유한다: 단어들을 앞글자부터 갈라지는 트리(trie)로 만들어 두고, 입력한 글자를 따라 내려가 그 아래 단어를 모은다. Elasticsearch 의 completion suggester 가 이 트리를 압축한 FST 를 쓴다.
역색인 + Edge N-gram
edge n-gram 은 단어의 앞에서 시작하는 부분 문자열만 뽑는 n-gram 이다. 일반 n-gram 은 단어 중간의 조각까지 모두 만들지만, edge n-gram 은 앞부분만 만든다.
| 단어 | edge n-gram (min 1, max 4) |
|---|---|
apple | a, ap, app, appl |
삼성전자 | 삼, 삼성, 삼성전, 삼성전자 |
이 조각을 모두 역색인의 term 으로 넣으면, 앞부분 검색이 “term 하나 조회” 로 바뀐다. 사용자가 “삼성” 을 치면 term 삼성 의 posting list 를 읽으면 끝이다. 보통 검색과 같은 경로를 타므로 BM25 같은 점수, 필터, 정렬을 그대로 섞어 쓸 수 있다.
색인 · 검색 analyzer 분리
색인 쪽 analyzer 에만 edge n-gram 을 걸고, 검색 쪽 analyzer 는 일반 분석기로 둔다. 검색어 “삼성” 에도 edge n-gram 을 적용하면 삼 과 삼성 두 term 으로 찾게 되어, “삼” 으로 시작하는 모든 문서가 함께 걸린다. Elasticsearch 문서도 이 경우만은 색인과 검색에 다른 analyzer 를 쓰라고 권한다.
{
  "settings": {
    "analysis": {
      "tokenizer": {
        "prefix_tok": {
          "type": "edge_ngram", "min_gram": 1, "max_gram": 10,
          "token_chars": ["letter", "digit"]
        }
      },
      "analyzer": {
        "prefix_index": {
          "type": "custom", "tokenizer": "prefix_tok", "filter": ["lowercase"]
        }
      }
    }
  },
  "mappings": {
    "properties": {
      "title": {
        "type": "text",
        "analyzer": "prefix_index",
        "search_analyzer": "standard"
      }
    }
  }
}
검색 쪽 standard analyzer 는 영문을 소문자로 바꾸므로, 색인 쪽에도 lowercase 필터를 넣어 대소문자를 맞춘다. token_chars 를 지정해야 공백에서 단어가 나뉜다. 지정하지 않으면 “삼성 전자” 전체가 한 덩어리로 취급되어 “전자” 로 시작하는 입력은 맞지 않는다.
대가: 색인 크기
길이 인 단어 하나가 term 최대 개가 된다. max_gram 을 크게 잡을수록 색인이 커지고, 짧은 조각(삼, a)은 posting list 가 아주 길어진다. 그래서 보통 min_gram 을 1 이나 2, max_gram 을 10 안팎으로 잡고, 원래 단어를 담은 필드를 따로 둬서 정확히 일치하는 문서에 점수를 더 준다.
색인을 키우지 않고 검색할 때 앞부분을 펼치는 방법(Lucene 의 PrefixQuery)도 있다. 단어 사전에서 그 앞부분으로 시작하는 term 을 모두 찾아 OR 로 묶는다. 입력이 짧으면 걸리는 term 이 수천 개가 되어 느려지므로, 키를 누를 때마다 부르는 자동완성에는 잘 쓰지 않는다.
Trie · FST 와 Completion Suggester
trie 는 단어를 글자 단위 경로로 저장하는 트리다. 앞부분이 같은 단어는 같은 가지를 공유한다. “사” 를 입력하면 루트에서 “사” 가지로 내려가고, 그 아래에 있는 “사과”, “사과즙”, “사탕” 이 후보가 된다. 단어 수와 상관없이 입력 길이만큼만 내려가면 된다.
FST 는 trie 를 두 방향으로 확장한 구조다.
| 구조 | 공유하는 것 | 단어에 붙는 값 |
|---|---|---|
| trie | 앞부분(prefix) | 없음. 단어가 있는지만 안다 |
| FST | 앞부분과 뒷부분(suffix) | 경로를 따라 더해지는 출력값 (가중치, 파일 위치 등) |
completion suggester 는 단어마다 가중치(인기도, 검색 수 등)를 붙여 FST 로 만들고 메모리에 올려 둔다. 입력을 따라 내려간 뒤 그 아래 후보 중 가중치가 큰 것부터 꺼낸다. 문서를 점수화하지 않고 사전만 훑으므로, 키를 누를 때마다 불러도 빠르다.
대신 쓰임새가 좁다.
- 앞부분 일치만 된다: “전자” 로 “삼성전자” 를 찾으려면 입력 후보(
input)에 “전자” 를 따로 넣어야 한다. - 점수 조합이 제한된다: 미리 정한 가중치로만 정렬한다. BM25 나 다른 필드의 조건을 자유롭게 섞으려면 edge n-gram 쪽이 낫다.
- 메모리를 쓴다: FST 는 세그먼트마다 만들어 메모리에 올린다. 만드는 비용도 크다.
FST 는 자동완성 전용이 아니다. Lucene 은 일반 역색인에서도 단어 사전의 색인(terms index)을 FST 로 저장한다. 검색어가 들어오면 FST 로 그 단어가 있는 사전 블록을 찾고, 블록에서 posting list 위치를 읽는다.
초성 검색
한국어 사용자는 “삼성전자” 를 “ㅅㅅㅈㅈ” 로 찾기도 한다. 한글 음절은 초성 · 중성 · 종성으로 이뤄져 있으므로, 색인할 때 초성만 뽑아 따로 저장하면 된다. 위 그림 왼쪽의 흐름이 이것이다.
- 색인할 때 제목을 음절별로 분해해 초성만 이은 문자열을 만든다 (
삼성전자→ㅅㅅㅈㅈ). - 그 문자열을 별도 필드에 넣고 edge n-gram 을 건다.
ㅅ,ㅅㅅ,ㅅㅅㅈ,ㅅㅅㅈㅈ가 모두 term 이 된다. - 검색할 때 입력이 자음으로만 이뤄져 있으면 초성 필드에서 찾고, 아니면 원래 제목 필드에서 찾는다.
한글 음절의 유니코드 값에는 초성 · 중성 · 종성 번호가 규칙적으로 들어 있다. 음절 코드에서 0xAC00(가)을 빼고 588(중성 21 × 종성 28)로 나눈 몫이 초성 번호다.
CHO = "ㄱㄲㄴㄷㄸㄹㅁㅂㅃㅅㅆㅇㅈㅉㅊㅋㅌㅍㅎ"

def chosung(text: str) -> str:
    out = []
    for ch in text:
        code = ord(ch) - 0xAC00
        out.append(CHO[code // 588] if 0 <= code < 11172 else ch)
    return "".join(out)

chosung("삼성전자")  # 'ㅅㅅㅈㅈ'
초성은 정보가 적어서 같은 초성을 가진 단어가 많다. ㅅㅅ 는 “삼성”, “수산”, “시설” 을 모두 가리킨다. 그래서 초성 필드에서 찾은 결과는 인기도나 클릭 수로 다시 정렬하는 일이 많다.
두 방식 비교
| 비교 항목 | 역색인 + edge n-gram | completion suggester (FST) |
|---|---|---|
| 색인 | 앞부분마다 term 이 생겨 커진다 | 단어 사전만 FST 로 압축 |
| 검색 비용 | term 하나 조회 + 일반 검색 점수 계산 | 입력 길이만큼 트리를 내려감 |
| 점수 · 필터 | BM25, 필터, 다른 필드와 자유롭게 섞음 | 미리 넣은 가중치 위주 |
| 일치 범위 | 단어 단위로 토큰화하면 중간 단어의 앞부분도 맞음 | 입력 후보의 맨 앞부터만 맞음 |
| 잘 맞는 곳 | 입력하면서 결과 문서를 바로 보여 주는 검색 | 검색창 아래 추천 검색어 목록 |