휴대폰 사진첩에서 「바닷가에서 뛰는 강아지」 라고 쳐서 사진을 찾고 싶다고 하자.
- 사진 수천 장을 미리 벡터 하나씩으로 바꿔 둔다.
- 검색어도 벡터 하나로 바꾼다.
- 검색어 벡터와 가장 가까운 사진 벡터를 꺼낸다.
사진과 글을 같은 공간의 벡터로 바꾸는 모델이 필요하다. 요즘은 이 일을 VLM(Vision-Language Model, 사진을 읽는 LLM)으로 한다.
결론부터 말하면, VLM 임베딩은 LLM 임베딩과 뽑는 법이 같다.
- 둘 다 맨 끝 토큰의 마지막 층 hidden state 를 문장 벡터로 쓴다.
- 둘 다 그대로는 못 쓰고 대조 학습(contrastive learning)으로 다시 학습한다.
- 다른 점은 입력이다: VLM 은 사진을 토큰 수십~수백 개로 바꿔 글 토큰과 한 줄로 이어 붙인다.
VLM 이 사진을 설명하는 글을 먼저 쓰고 그 글을 임베딩하는 것이 아니다. 사진에서 나온 토큰이 글 토큰과 같은 줄에 섞여 LLM 을 한 번 통과하고, 그 끝에서 벡터 하나가 나온다.
LLM 에서 문장 벡터를 뽑는 방법
토큰마다 나오는 벡터를 하나로 줄이기
LLM 에 「바닷가에서 뛰는 강아지」 를 넣으면 토큰마다 벡터가 하나씩 나온다. 이 벡터가 hidden state 다.
- 끝 토큰까지 토큰이 5 개면 벡터도 5 개다.
- 검색에는 문장 하나에 벡터 하나가 필요하다.
- 그래서 여러 벡터를 하나로 줄인다. 이 과정을 풀링(pooling)이라 한다.
flowchart LR
    T1["바닷가"] --> L["LLM"]
    T2["에서"] --> L
    T3["뛰는"] --> L
    T4["강아지"] --> L
    T5["끝 토큰 (EOS)"] --> L
    L --> H["토큰마다 hidden state 하나씩"]
    H --> P1["평균 풀링: 다섯 벡터의 평균"]
    H --> P2["마지막 토큰 풀링: 끝 토큰 벡터만"]
풀링은 크게 두 가지다.
- 평균 풀링 (mean pooling): 모든 토큰 벡터의 평균을 낸다.
- 마지막 토큰 풀링 (last-token pooling): 맨 끝 토큰의 벡터 하나만 쓴다.
- 보통 문장 끝에 EOS(End of Sequence) 토큰을 붙이고 그 자리를 쓴다.
마지막 토큰을 쓰는 이유
GPT 같은 LLM 은 각 토큰이 자기 앞의 토큰만 본다. 이를 causal attention 이라 한다.
- 「바닷가」 자리의 벡터는 뒤에 「강아지」 가 온다는 것을 모른다.
- 맨 끝 자리의 벡터만 문장 전체를 보고 만들어진다.
- 그래서 문장 끝에 끝 토큰(EOS)을 붙이고 그 자리의 벡터를 쓴다.
그래서 평균을 내면 문장 전체를 모르는 벡터들이 섞인다. LLM 기반 임베딩 모델 다수가 마지막 토큰을 쓰는 이유다.
반대 경우와 나란히 놓으면 이렇다.
- BERT 처럼 양방향으로 보는 모델: 어느 토큰이든 문장 전체를 보므로 평균 풀링이 잘 통한다.
- GPT 처럼 앞만 보는 모델: 끝 토큰만 문장 전체를 보므로 마지막 토큰 풀링을 쓴다.
LLM2Vec 은 LLM 의 attention 을 양방향으로 바꾸고 추가 학습한 뒤 평균 풀링을 쓴다. 앞만 보는 제약을 풀면 평균 풀링이 다시 낫다는 것을 보여 준다 (LLM2Vec).
대조 학습으로 다시 학습하기
LLM 의 끝 토큰 벡터를 그대로 꺼내면 좋은 임베딩이 아니다. LLM 은 다음 토큰을 맞히도록 학습됐다. 끝 토큰 벡터에는 「문장 뜻」 보다 「다음에 올 단어」 에 쓸 정보가 담긴다.
그래서 대조 학습으로 다시 학습한다.
- 「바닷가에서 뛰는 강아지」 와 실제 그 사진의 설명글을 짝으로 준다.
- 짝끼리는 벡터가 가까워지게 학습한다.
- 같은 배치 안의 다른 글(「눈 속의 고양이」 등)과는 멀어지게 학습한다.
- 이 손실 함수가 InfoNCE 다.
대표 모델 둘이 이 방식이다.
- E5-Mistral: Mistral-7B 에 LoRA 를 붙여 대조 학습했다 (Wang et al., 2024).
- 학습 데이터 상당 부분은 LLM 이 만든 합성 데이터다.
- 끝 토큰(EOS)의 마지막 층 벡터를 쓴다.
- Qwen3 Embedding: 같은 방식을 세 단계 학습으로 키웠다 (Zhang et al., 2025).
- 합성 쌍 약 1.5 억 개로 먼저 학습하고, 정제된 데이터로 다시 학습한 뒤, 체크포인트 여러 개를 합친다.
- 역시 끝 토큰(EOS)의 마지막 층 벡터를 쓴다.
검색어 앞에 붙이는 지시문 (instruction)
같은 문장이라도 무슨 일에 쓸지에 따라 벡터가 달라야 한다.
- 사진 검색에 쓰면 「바닷가에서 뛰는 강아지」 는 그 장면을 찍은 사진과 가까워야 한다.
- 「동물 / 풍경」 주제 분류에 쓰면 「공원에서 자는 고양이」 같은 다른 동물 문장과 가까워야 한다.
그래서 검색어 앞에 지시문을 붙인다. E5-Mistral 은 이런 모양으로 넣는다.
Instruct: 주어진 검색어에 맞는 사진 설명을 찾아라
Query: 바닷가에서 뛰는 강아지- 끝 토큰은 앞의 모든 토큰을 보므로, 지시문을 보고 벡터를 과제에 맞게 바꾼다.
- 지시문은 검색어 쪽에만 붙이고 문서 쪽에는 붙이지 않는다.
- 문서 벡터는 한 번만 만들어 두고, 과제가 바뀌면 검색어 쪽 지시문만 바꾼다.
VLM 이 사진을 토큰으로 바꾸는 과정
VLM 은 비전 인코더, projector, LLM 세 부품으로 이뤄져 있다.
아래 그림에서 주황색은 사진에서 나온 것, 파란색은 글에서 나온 것이다. 빨간 칸이 임베딩으로 쓰는 끝 토큰 벡터다.
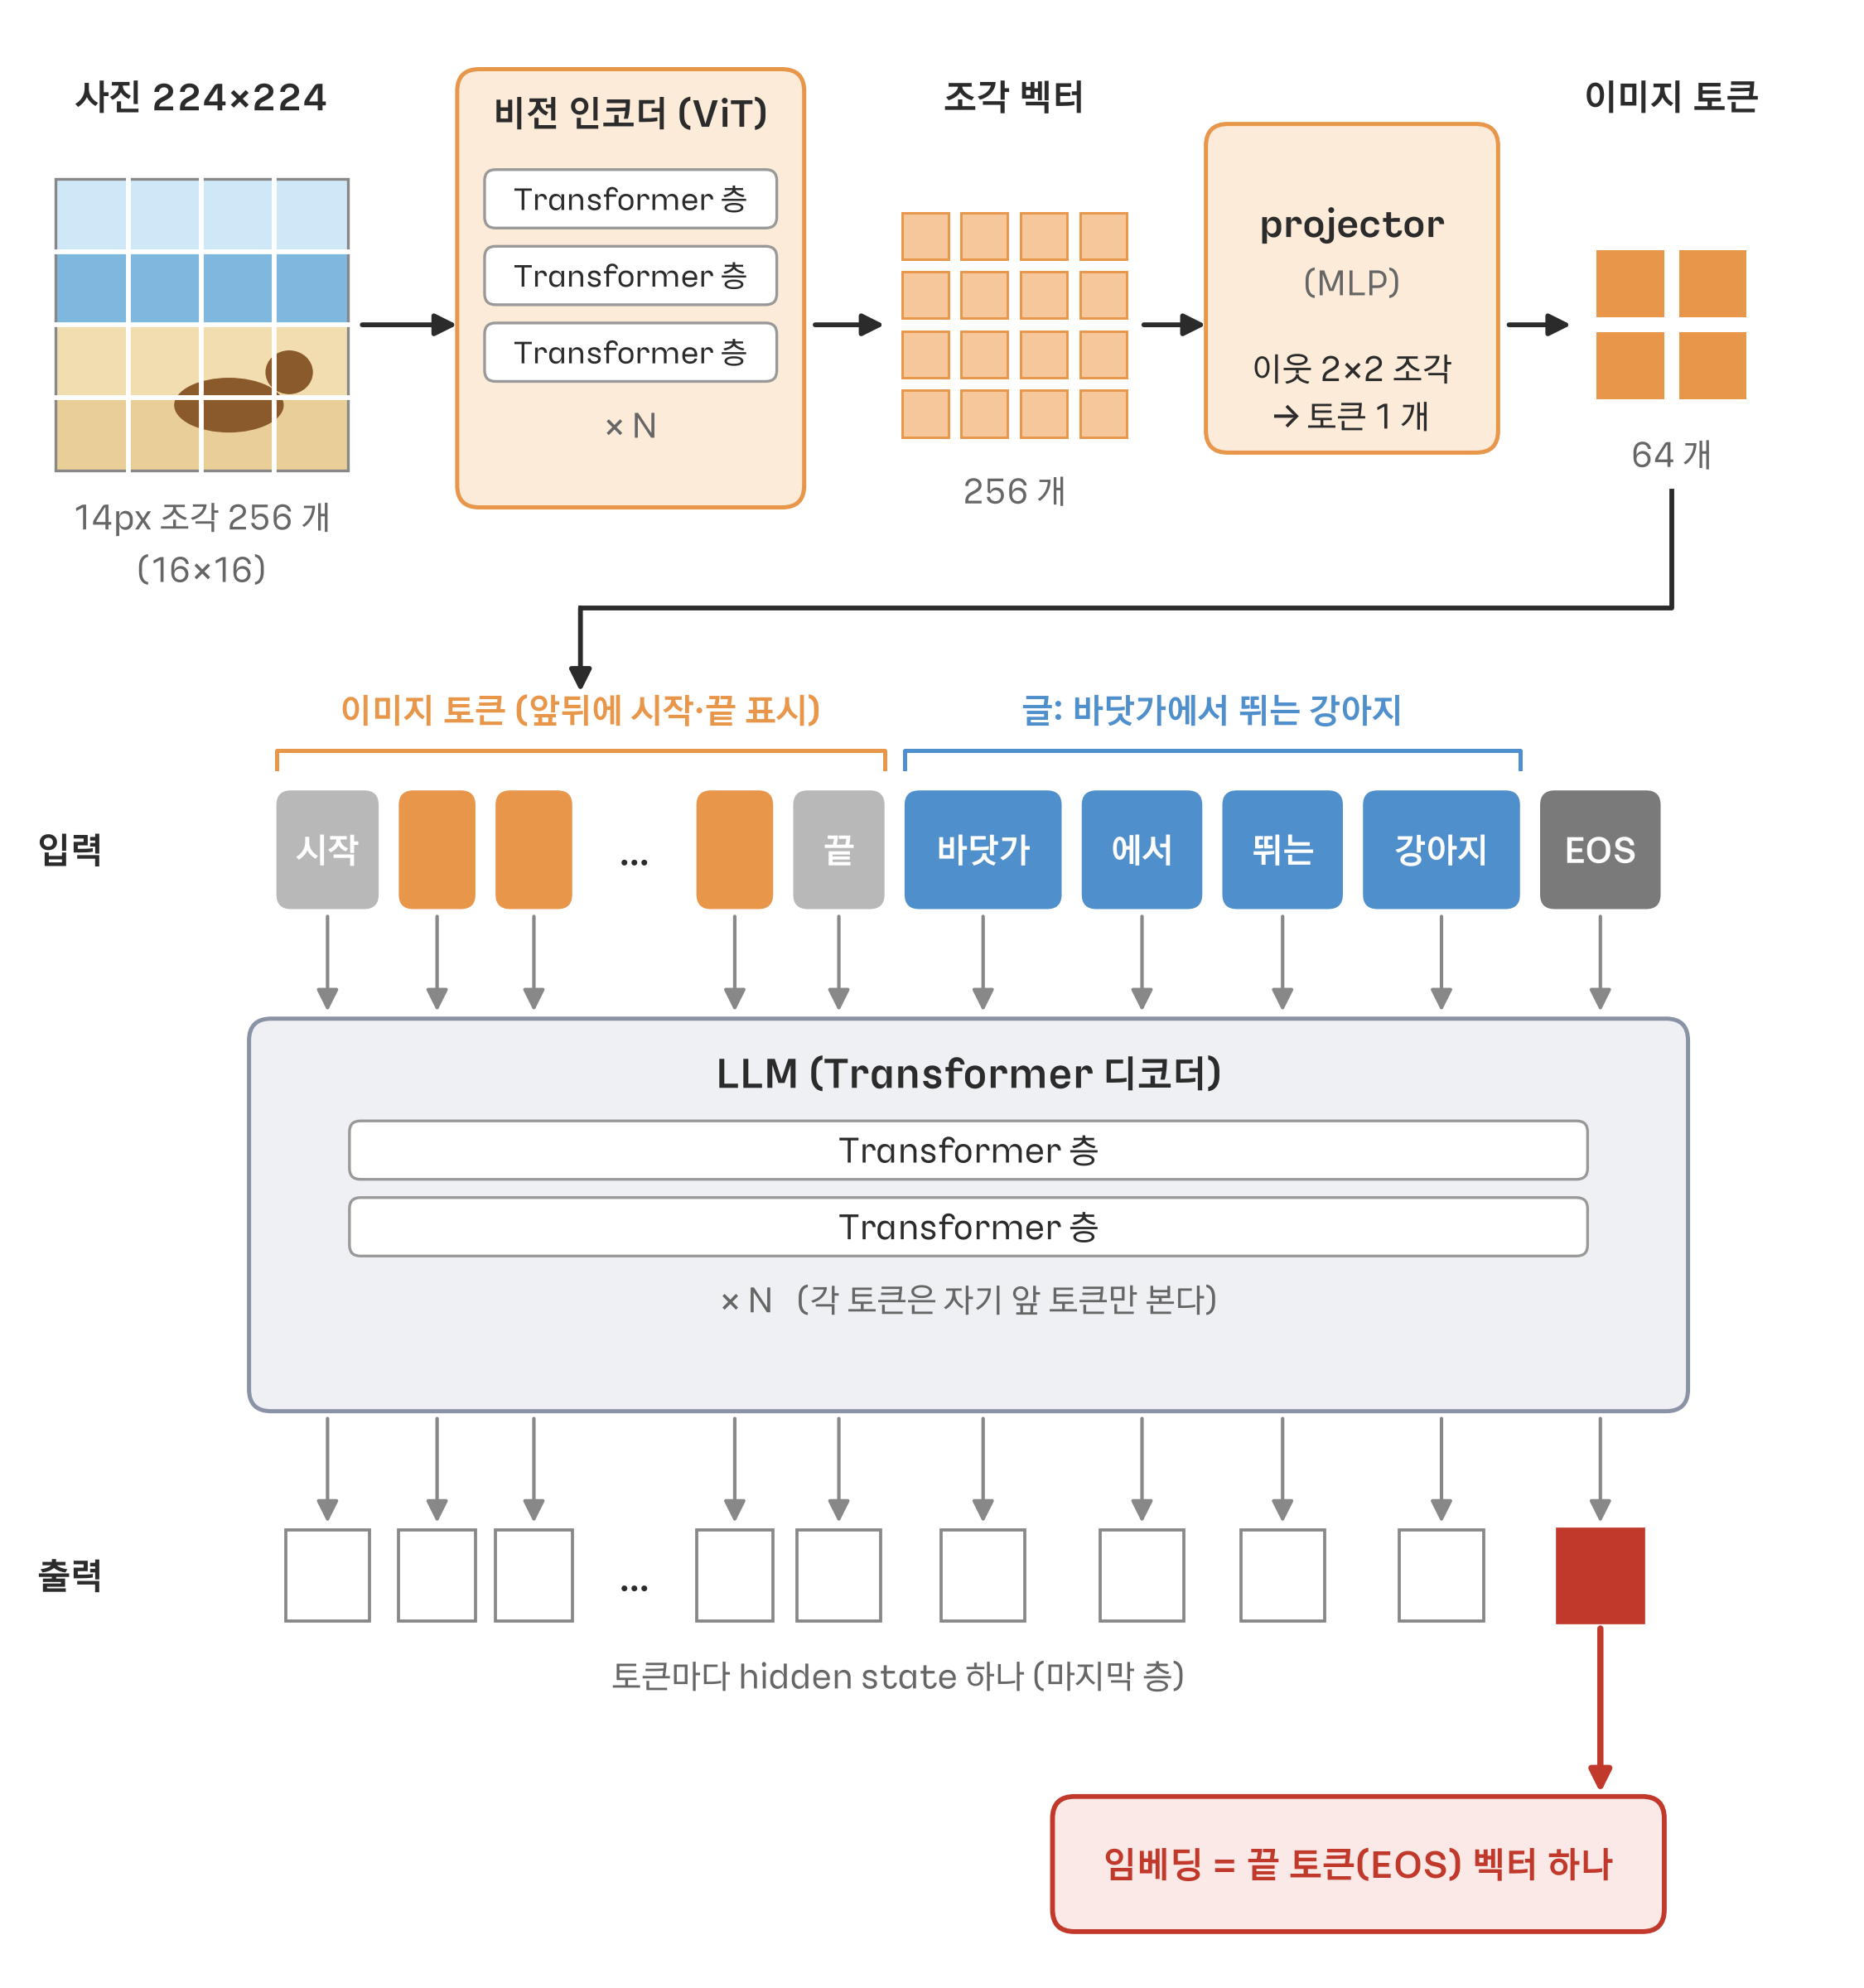
비전 인코더 (vision encoder): 사진을 작은 정사각형 조각(패치, patch)으로 자르고 조각마다 벡터를 만든다.
- Qwen2-VL 은 한 변 14 픽셀짜리 조각을 쓴다.
- 224×224 사진이면 가로 16 개 × 세로 16 개, 조각 256 개가 나온다.
projector: 비전 인코더가 만든 벡터를 LLM 의 단어 벡터와 같은 공간으로 옮긴다.
- 비전 인코더와 LLM 은 따로 학습된 모델이라 벡터 크기도 뜻도 다르다.
- LLaVA 는 선형 층 하나로 옮긴다 (Liu et al., 2023).
- Qwen2-VL 은 작은 MLP 로 옮기면서 이웃한 2×2 조각을 토큰 하나로 합친다 (Wang et al., 2024).
- 조각 256 개가 토큰 64 개가 된다.
LLM: 이미지 토큰과 글 토큰을 한 줄로 이어 받는다.
[이미지 시작] [이미지 토큰 64 개] [이미지 끝] 이 사진에 뭐가 있나?- Qwen2-VL 은 이미지 토큰 앞뒤에 시작·끝 표시 토큰을 하나씩 붙인다.
- 224×224 사진 한 장이 토큰 66 개가 된다.
- LLM 입장에서 사진은 「단어 66 개」 처럼 보인다.
- 이 토큰들은 글 토큰과 같은 attention 을 거치므로, 뒤에 오는 글 토큰이 사진 내용을 볼 수 있다.
조각 크기와 토큰 수의 자세한 내용은 Qwen-VL 노트에 있다.
VLM 에서 임베딩을 뽑는 방식
사진 검색 임베딩을 만드는 방식은 세 가지다.
- CLIP: 사진과 글을 서로 다른 인코더 둘이 읽는다.
- VLM 단일 벡터: VLM 하나가 사진과 글을 함께 읽고 벡터 1 개를 낸다 (VLM2Vec, GME, Qwen3-VL-Embedding).
- VLM 멀티벡터: VLM 하나가 읽고 토큰마다 벡터를 하나씩 낸다 (ColPali).
flowchart LR
    A1["CLIP: 사진"] --> A2["이미지 인코더"] --> A3["CLS 벡터 1 개"]
    B1["CLIP: 글"] --> B2["텍스트 인코더"] --> B3["EOS 벡터 1 개"]
    C1["단일 벡터: 지시문 + 사진 + 글"] --> C2["VLM"] --> C3["끝 토큰 벡터 1 개"]
    D1["멀티벡터: 페이지 사진"] --> D2["VLM"] --> D3["토큰마다 벡터, 약 1,030 개"]
CLIP: 사진과 글을 따로 읽는 인코더 둘
CLIP 은 이미지 인코더와 텍스트 인코더를 따로 두고, 마지막에 같은 공간으로 맞춘다.
- 이미지 인코더(ViT)는 맨 앞 CLS 토큰 자리의 벡터를 쓴다.
- 텍스트 인코더는 EOS 토큰 자리의 마지막 층 벡터를 쓴다 (Radford et al., 2021).
- 각 벡터를 선형 층 하나로 같은 공간에 투영한다.
사진과 글이 모델 안에서 만나지 않는다. 그래서 생기는 한계가 있다.
- 「이 사진에서 색만 빨간색인 것」 처럼 사진과 글을 함께 넣어 벡터 하나를 만들 수 없다.
- 텍스트 인코더가 작고 입력이 76 토큰으로 잘려서, 긴 지시문을 따르게 만들기 어렵다.
VLM 단일 벡터: LLM 임베딩과 같은 방식
VLM 하나에 사진이든 글이든 섞어 넣고, LLM 임베딩과 똑같이 끝 토큰 벡터를 쓴다.
- 「바닷가에서 뛰는 강아지」 글만 넣어도 된다.
- 강아지 사진만 넣어도 된다.
- 사진과 「이 사진과 같은 장소에서 찍은 것」 을 함께 넣어도 벡터 하나가 나온다.
대표 모델은 이렇다.
- VLM2Vec: Phi-3.5-V 를 대조 학습했다 (Jiang et al., 2024).
- 끝 토큰의 마지막 층 벡터를 쓰고, 검색어 앞에
Instruct: … Query: …지시문을 붙인다. - 36 개 데이터셋으로 된 MMEB 벤치마크도 함께 냈다.
- 끝 토큰의 마지막 층 벡터를 쓰고, 검색어 앞에
- GME: Qwen2-VL 2B·7B 를 대조 학습했다 (Zhang et al., 2024).
- 끝 토큰의 마지막 층 벡터를 쓴다.
- 글, 사진, 사진+글을 모두 받는다.
- Qwen3-VL-Embedding: Qwen3-VL 을 대조 학습했다 (Qwen, 2026).
- 입력 끝에 끝 토큰을 붙이고 그 자리의 마지막 층 벡터를 쓴다.
- 지시문은 system prompt 에 넣고, 없으면 「Represent the user’s input.」 을 기본으로 쓴다.
예외도 하나 있다. Jina-Embeddings-v4 는 같은 VLM 기반이지만 단일 벡터를 평균 풀링으로 만든다 (Günther et al., 2025).
지시문이 하는 일
VLM 임베딩에서도 지시문은 LLM 임베딩과 똑같이 과제를 알려 준다.
- 같은 강아지 사진이라도 「같은 물건이 나온 사진을 찾아라」 를 붙이면 다른 강아지 사진과 가까워진다.
- 「이 사진에 대한 질문에 답하는 글을 찾아라」 를 붙이면 「이 개는 무슨 품종인가」 같은 글과 가까워진다.
E5-V 는 지시문 하나로 사진과 글을 같은 자리에 모은다 (Jiang et al., 2024).
- 글 뒤에는 「위 문장을 한 단어로 요약하면:」 을 붙인다.
- 사진 뒤에는 「위 사진을 한 단어로 요약하면:」 을 붙인다.
- 실제 문구는 영어다 (
Summary above sentence in one word:,Summary above image in one word:).
앞에서 끝 토큰 벡터에는 「다음에 올 단어」 정보가 담긴다고 했다. E5-V 는 이 성질을 거꾸로 이용한다. 다음에 올 단어가 곧 한 단어 요약이 되도록 지시하는 것이다.
- 「바닷가에서 뛰는 강아지」 글의 끝 토큰은 다음 단어로 「강아지」 를 떠올린다.
- 강아지 사진의 끝 토큰도 다음 단어로 「강아지」 를 떠올린다.
- 둘 다 같은 단어를 떠올리므로 두 끝 토큰 벡터가 가까워진다.
그래서 E5-V 는 사진 없이 글 쌍만으로 학습했는데도 사진 검색이 된다.
- 학습에는 뜻이 같은 문장 쌍만 썼고, 사진은 한 장도 넣지 않았다.
- 학습은 「한 단어 요약」 자리의 벡터를 검색에 맞게 다듬는다.
- 사진도 같은 지시문 덕분에 그 「한 단어 요약」 자리로 오므로, 따로 학습하지 않아도 함께 나아진다.
멀티벡터: 토큰 벡터를 전부 쓰는 ColPali
ColPali 는 끝 토큰 하나만 쓰지 않고, 모든 출력 토큰을 각각 128 차원으로 줄여 전부 저장한다 (Faysse et al., 2024).
- 바탕 모델은 PaliGemma-3B 다.
- PDF 페이지를 한 장씩 이미지로 바꿔 넣는다.
- 페이지 한 장이 조각 1,024 개와 글 토큰 6 개, 약 1,030 개 벡터가 된다.
- 검색어도 토큰마다 벡터를 만든다.
점수는 ColBERT 와 같은 late interaction 으로 낸다.
- 검색어 토큰마다 페이지 조각 중 가장 비슷한 것 하나를 찾는다.
- 그 최고 점수들을 모두 더한다.
단일 벡터와 나란히 놓으면 이렇다.
- 단일 벡터: 페이지 한 장이 벡터 1 개다.
- 저장이 싸고 검색이 빠르다.
- 표 안의 숫자 하나 같은 작은 내용은 묻히기 쉽다.
- 멀티벡터: 페이지 한 장이 벡터 약 1,030 개다.
- 작은 글씨·표·그래프 속 내용까지 짚는다.
- 저장과 계산이 그만큼 든다.
벡터 수를 줄이는 방법은 token pooling 에 있다.
LLM 임베딩과 VLM 임베딩 비교
같은 점이 훨씬 많다. VLM 임베딩은 LLM 임베딩 방식을 그대로 가져오고, 입력에 이미지 토큰을 섞은 것이다.
| 항목 | LLM 임베딩 | VLM 임베딩 |
|---|---|---|
| 입력 | 글 토큰 | 글 토큰 + 이미지 토큰 (비전 인코더 → projector) |
| 벡터 위치 | 끝 토큰(EOS)의 마지막 층 | 같다 (ColPali 는 모든 토큰, Jina v4 는 평균) |
| 지시문 | 검색어 앞에 과제 설명 | 같다 + 「한 단어로 요약하면:」 처럼 끝 토큰에 뜻을 모으는 지시 (E5-V) |
| 학습 | 대조 학습 (InfoNCE) | 같다, 학습 쌍에 사진이 들어간다 |
| 대표 모델 | E5-Mistral, Qwen3-Embedding | VLM2Vec, GME, Qwen3-VL-Embedding, ColPali |
| 이전 세대 | BERT 계열 (평균 풀링) | CLIP (인코더 둘) |
| 입력 길이 | 글 길이만큼 | 사진 한 장마다 토큰 수십~수천 개가 더 붙어 느리고 메모리를 더 쓴다 |
부록: 입력 템플릿
본문에서 말로 풀었던 입력 모양이다. 줄바꿈은 읽기 좋게 맞췄다.
E5-Mistral. 검색어 쪽만 지시문을 붙이고, 끝에 EOS 를 붙인다.
Instruct: {task_definition}
Query: {query}
Qwen3-Embedding. 지시문과 검색어를 이어 붙이고 끝 토큰을 붙인다.
{Instruction} {Query}<|endoftext|>VLM2Vec. 사진 토큰 뒤에 지시문을 둔다.
<image> Instruct: {task_definition}
Query: {query}
Qwen3-VL-Embedding. 지시문은 system, 입력은 user 에 넣고, assistant 자리 끝 토큰의 벡터를 쓴다.
<|im_start|>system
{Instruction}<|im_end|>
<|im_start|>user
{Instance}<|im_end|>
<|im_start|>assistant
<|endoftext|>
E5-V. 글과 사진에 같은 꼴의 지시문을 붙인다.
<text>
Summary above sentence in one word:

<image>
Summary above image in one word:
References
- Improving Text Embeddings with Large Language Models (E5-Mistral)
- Qwen3 Embedding
- LLM2Vec
- Visual Instruction Tuning (LLaVA)
- Qwen2-VL
- Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- VLM2Vec
- GME: Improving Universal Multimodal Retrieval by Multimodal LLMs
- Qwen3-VL-Embedding and Qwen3-VL-Reranker
- E5-V
- ColPali
- jina-embeddings-v4