두 구조의 차이
질의와 문서의 관련도를 신경망으로 매기는 방법은 크게 둘이다. bi-encoder 는 질의와 문서를 따로 인코딩해 벡터 두 개를 만들고, 두 벡터의 내적으로 점수를 낸다. cross-encoder 는 질의와 문서를 한 입력으로 이어 붙여 인코더에 넣고, 인코더가 직접 점수를 낸다.
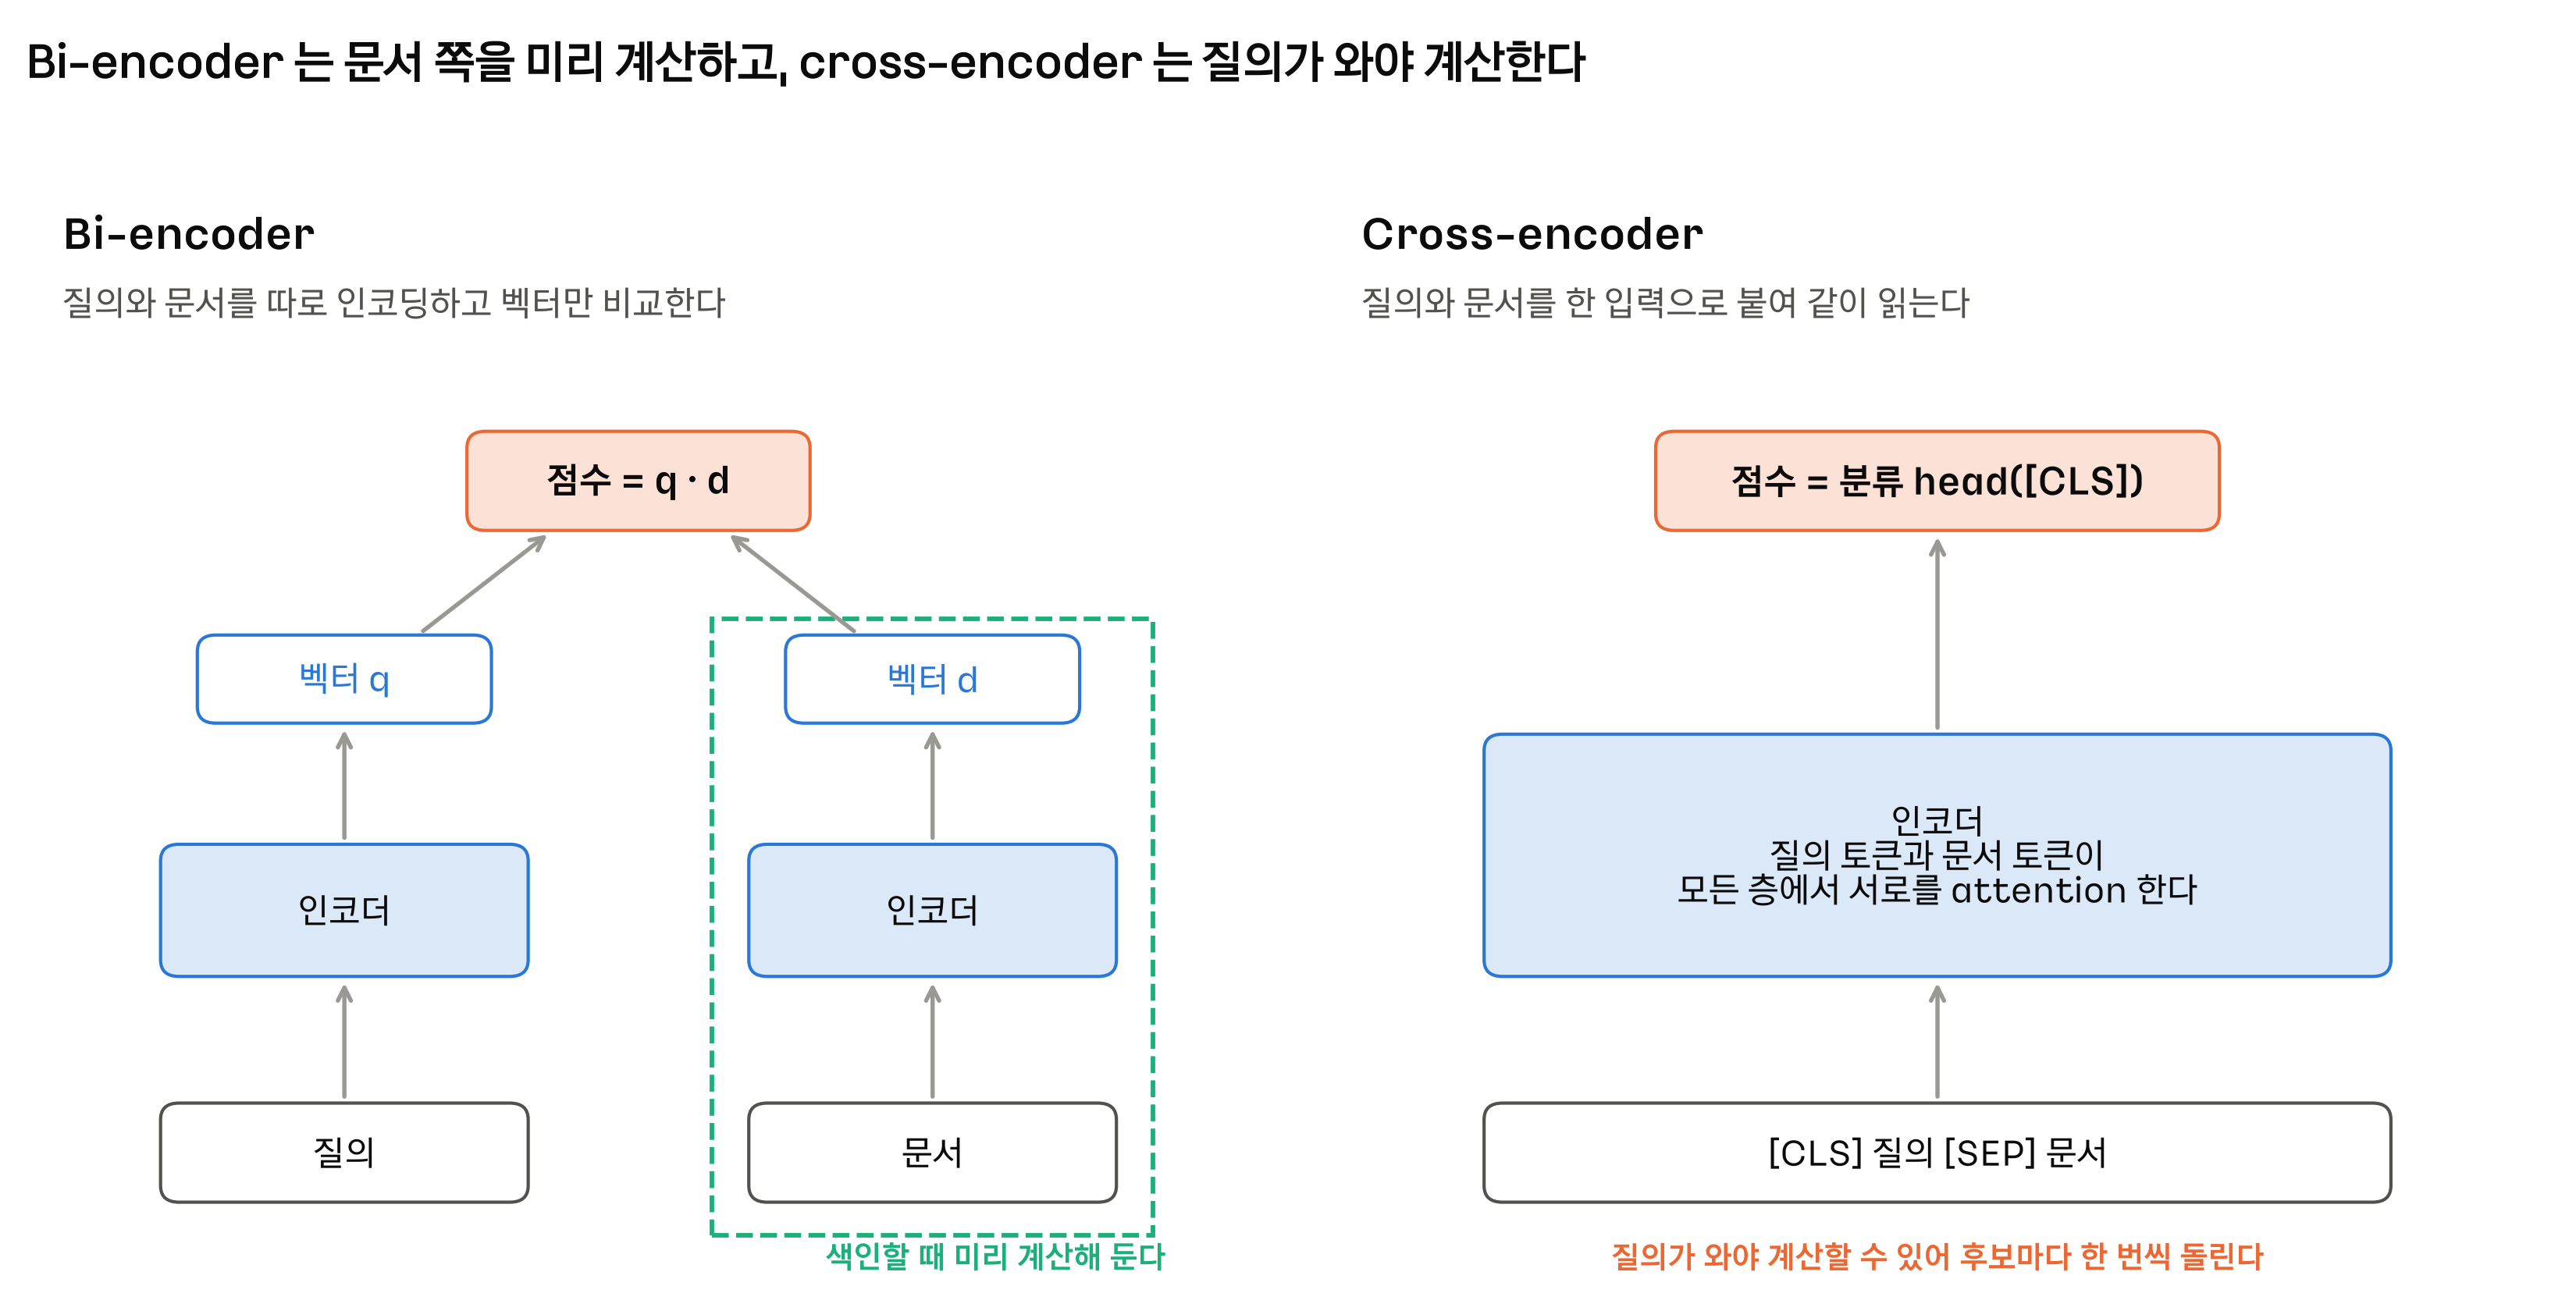
둘의 차이는 “질의와 문서가 언제 만나는가” 다. bi-encoder 에서는 두 쪽이 각자 인코더를 다 통과한 뒤 마지막 내적에서 한 번 만난다. cross-encoder 에서는 첫 층부터 질의 토큰과 문서 토큰이 서로를 attention 한다. “사과 없는 레시피” 같은 질의에서 “없는” 이 “사과” 를 어떻게 바꾸는지를 문서 내용과 맞대어 볼 수 있다.
이 차이가 그대로 비용 차이가 된다.
| 비교 항목 | Bi-encoder | Cross-encoder |
|---|---|---|
| 문서 쪽 계산 | 색인할 때 미리 벡터로 만들어 둔다 | 질의가 와야 계산할 수 있다 |
| 질의 하나의 비용 | 질의 인코딩 1 번 + ANN 검색 | 후보 수만큼 인코더 forward |
| 다룰 수 있는 후보 수 | 수백만에서 수십억 (ANN 색인) | 수십에서 수백 |
| 정확도 | 벡터 하나에 문서를 압축하므로 낮다 | 토큰 단위로 비교하므로 높다 |
| 대표 모델 | DPR, sentence transformers, Two-tower Model | monoBERT, bge-reranker 같은 reranker |
두 단계 구성
두 구조는 서로 대체하지 않고 역할을 나눈다. bi-encoder 가 전체 문서에서 후보 수백 개를 빠르게 꺼내고, cross-encoder 가 그 후보만 다시 매겨 순서를 정한다. 첫 단계는 정답을 놓치지 않는 것(recall)이, 두 번째 단계는 위쪽 순서를 맞히는 것(precision)이 목표다. 이 구성이 Re-ranking 이고, 단계를 더 늘린 것이 Cascade Ranking System 이다.
ColBERT 같은 late interaction 모델은 그 중간이다. 문서를 토큰별 벡터 여러 개로 미리 계산해 두고, 질의 토큰마다 가장 비슷한 문서 토큰을 찾아 점수를 더한다. 문서 쪽을 미리 계산할 수 있으면서 토큰 단위 비교도 일부 살린다. 대신 문서의 토큰마다 벡터가 하나씩이라 문서 하나에 수십에서 수백 개가 되고, 색인이 커진다.
학습 방법
Bi-encoder 학습: contrastive
bi-encoder 는 질의 벡터가 정답 문서 벡터와는 가깝고 다른 문서와는 멀어지도록 학습한다. 보통 InfoNCE loss 를 쓰고, 같은 batch 에 있는 다른 질의의 정답 문서를 negative 로 재활용한다(in-batch negative). batch 크기만큼 negative 를 공짜로 얻는 방법이다.
in-batch negative 는 대부분 질의와 무관한 문서라 학습 초반이 지나면 쉽게 구분된다. 그래서 질의와 비슷하지만 정답이 아닌 hard negative 를 섞는다. hard negative 를 상위 후보에서 뽑을수록 실제로는 정답인 문서(false negative)가 섞이는 문제가 생긴다.
Cross-encoder 학습: 분류
cross-encoder 는 (질의, 문서) 쌍에 관련 여부나 등급을 붙여 분류 · 회귀로 학습한다. 입력 하나가 쌍 하나라서 in-batch negative 같은 재활용은 없고, negative 쌍을 따로 만들어 넣는다.
Cross-encoder 를 선생으로 쓰는 학습
cross-encoder 는 정확하지만 느리고, bi-encoder 는 빠르지만 덜 정확하다. 그래서 학습할 때 cross-encoder 를 bi-encoder 의 선생으로 쓴다. 쓰는 방식은 두 가지다.
- 라벨을 고친다: RocketQA(Qu et al., NAACL 2021)는 cross-encoder 가 관련 있다고 판단한 상위 후보를 hard negative 에서 빼서 false negative 를 걸러 냈다. 라벨이 없는 질의 데이터에는 cross-encoder 판정으로 pseudo-label 을 붙여 학습 데이터를 늘렸다.
- 점수를 따라가게 한다: cross-encoder 가 후보 목록에 매긴 점수 분포를 bi-encoder 가 따라가도록 distillation 한다. RocketQAv2(Ren et al., EMNLP 2021)가 두 모델을 함께 학습하며 이 방식을 썼다.
References
- Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks (Reimers & Gurevych, EMNLP 2019)
- Poly-encoders: Architectures and Pre-training Strategies for Fast and Accurate Multi-sentence Scoring (Humeau et al., ICLR 2020)
- RocketQA: An Optimized Training Approach to Dense Passage Retrieval for Open-Domain Question Answering (Qu et al., NAACL 2021)
- RocketQAv2: A Joint Training Method for Dense Passage Retrieval and Passage Re-ranking (Ren et al., EMNLP 2021)
- Sentence Transformers - Cross-Encoders